Scoring de candidatos: aprender a filtrar sem perder boas decisões
Regressão logística e boosting como filtros do otimizador: o que preveem e como avaliar o custo de excluir candidatos.

Série: dos dados à decisão logística
- Dos pedidos à rede logística: um projeto de otimização e machine learning
- MILP: transformar uma decisão logística em um modelo verificável
- Relaxação linear: quanto uma solução ainda pode melhorar
- Guloso e busca local: construir rápido e melhorar com critério
- LNS: reorganizar parte da rede para escapar do ótimo local
- Prever demanda: de uma referência populacional a Poisson e boosting
- Previsão populacional: tendências, amortecimento e teste temporal
- K-means: descobrir perfis municipais sem inventar categorias naturais
- Scoring de candidatos: aprender a filtrar sem perder boas decisões
- Cenários e SAA: decidir antes de conhecer a demanda
O filtro é uma decisão com consequências
Com muitos candidatos, resolver a rede completa pode ser caro. O scoring aprende quais costumam receber uma instalação em soluções anteriores e propõe uma lista reduzida. É uma pré-seleção para um exame mais detalhado: descartar o candidato adequado nessa etapa impede que o otimizador o recupere depois. Por isso o objetivo não é apenas classificar bem, mas preservar boas redes com menos esforço computacional.
O rótulo aberto indica que um município recebeu pelo menos um módulo na solução usada para treinar. Não é uma verdade geográfica universal: depende de custos, demanda, capacidades e qualidade dessa solução. As entradas incluem demanda local e próxima, distância ponderada, renda, aluguel e variáveis do cenário. Se as soluções usadas como referência são aproximadas, o classificador também aprende suas limitações.
Duas famílias e uma validação comum
A regressão logística transforma uma combinação de atributos em um score entre zero e um; o boosting combina árvores e admite interações mais flexíveis. O módulo deixa uma macrorregião de fora em cada ajuste e produz scores fora da amostra. Esse número pode ordenar candidatos, mas não deve ser apresentado como probabilidade calibrada de sucesso comercial sem uma avaliação adicional.
Para usar o pipeline completo, prepare primeiro os dados territoriais, cenários e soluções que originam os rótulos. Execute o comando abaixo na raiz do repositório, com uma pasta de saída nova. Ele realiza experimentos de scoring; não é um exemplo instantâneo nem funciona somente com os CSV resumidos desta série. Antes da execução longa, consulte --help e confirme a disponibilidade das matrizes e tabelas de referência.
python -m alocacao_capacitada.network.run_scoring --help
python -m alocacao_capacitada.network.run_scoring --iterations 100 --out results/scoring_tutorial_new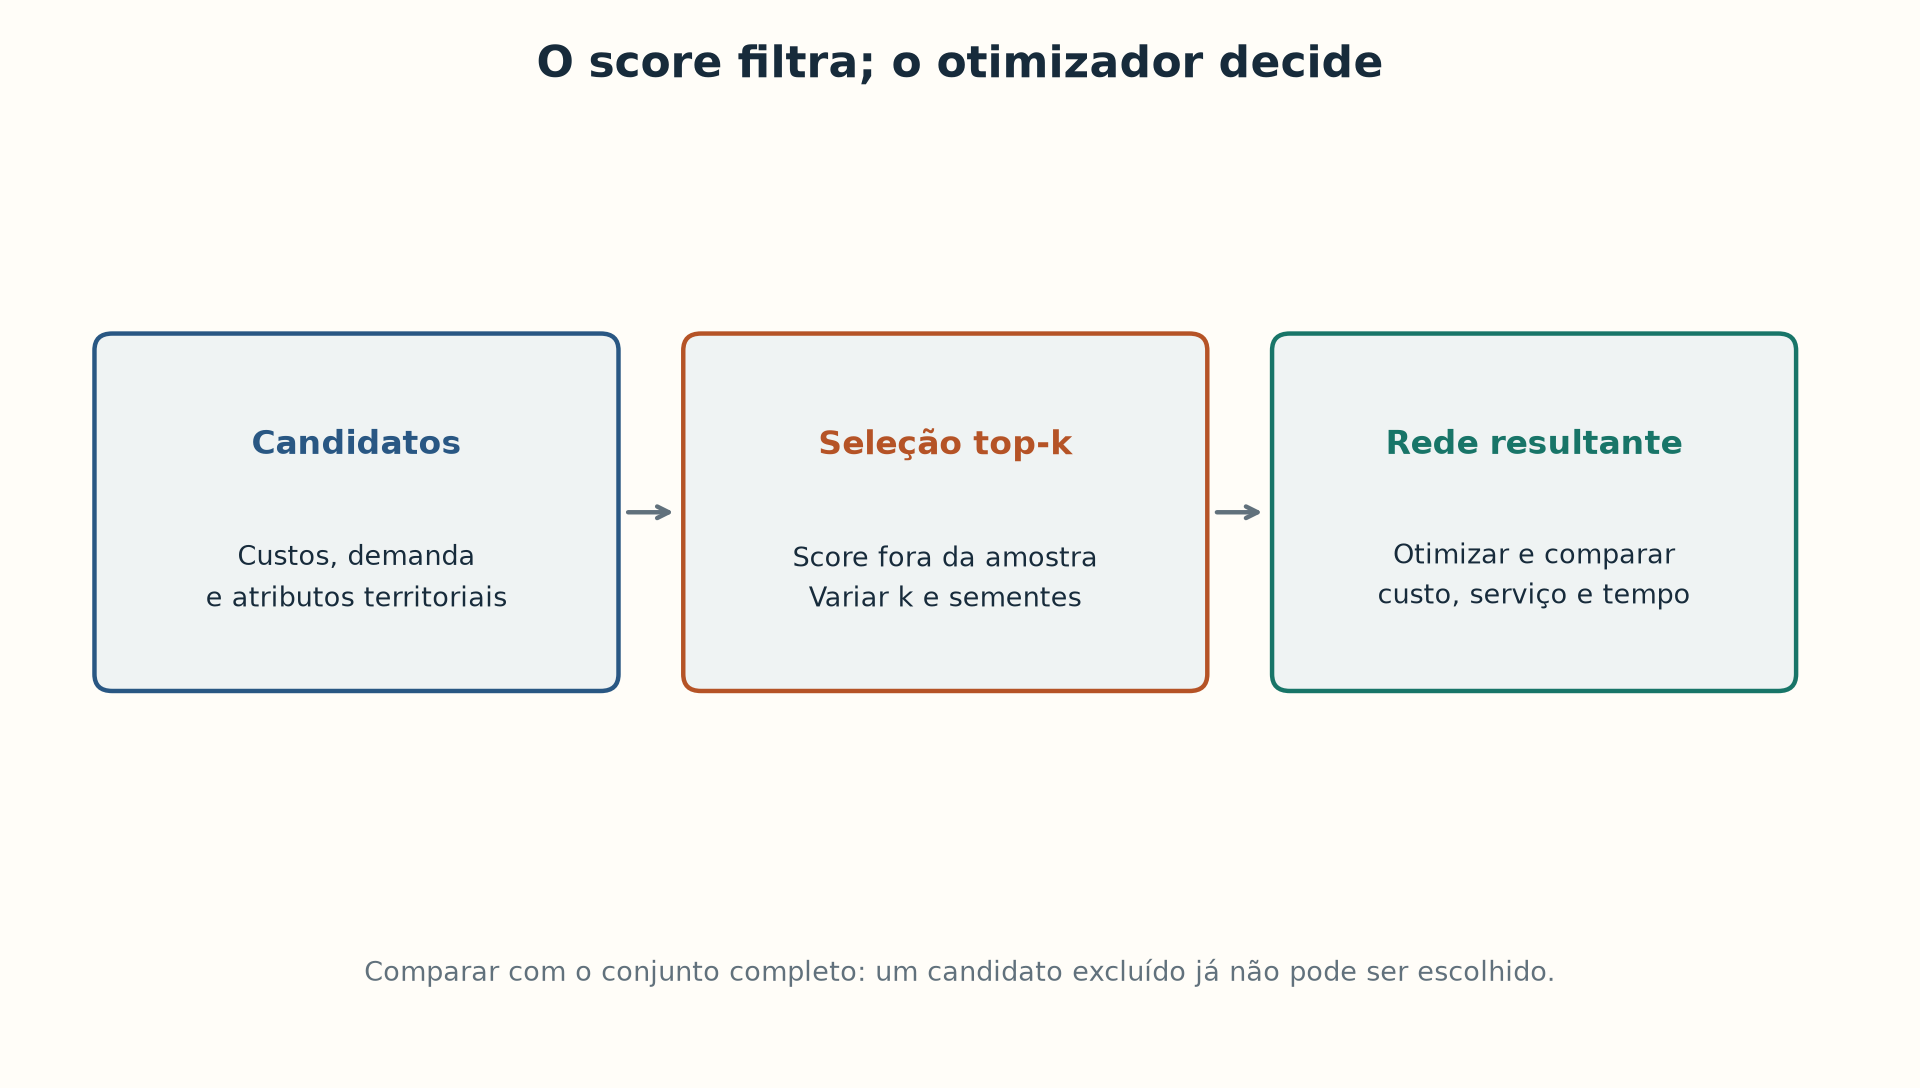
A métrica final é a decisão
AUC mede ordenação geral e precision@k mede a proporção de positivos entre os k primeiros. Ambas são úteis, mas excluir um único centro estratégico pode encarecer muito a rede mesmo com métricas altas. Resolva a rede com todos os candidatos e com o filtro sob orçamentos comparáveis. Avalie ambas sobre a mesma demanda e matriz de transporte; compare custo, atendimento, tempo e limites disponíveis.
excess_pct = 100 * (cost_filtered - cost_reference) / cost_referenceSe a referência completa for heurística, chame o resultado de excesso em relação à referência, não de distância ao ótimo. Um valor negativo pode ocorrer porque o problema reduzido foi mais fácil de resolver dentro do tempo; não prova que eliminar alternativas melhora o ótimo matemático. Varie k, repita sementes e confira a capacidade territorial. Um filtro que acelera o cálculo mas impede atender regiões importantes não cumpriu sua função.
Fontes e evidências
Próximo: Cenários e SAA: decidir antes de conhecer a demanda