Previsão populacional: tendências, amortecimento e teste temporal
Como projetar população sem confundir revisão censitária com crescimento nem população futura com pedidos garantidos.

Série: dos dados à decisão logística
- Dos pedidos à rede logística: um projeto de otimização e machine learning
- MILP: transformar uma decisão logística em um modelo verificável
- Relaxação linear: quanto uma solução ainda pode melhorar
- Guloso e busca local: construir rápido e melhorar com critério
- LNS: reorganizar parte da rede para escapar do ótimo local
- Prever demanda: de uma referência populacional a Poisson e boosting
- Previsão populacional: tendências, amortecimento e teste temporal
- K-means: descobrir perfis municipais sem inventar categorias naturais
- Scoring de candidatos: aprender a filtrar sem perder boas decisões
- Cenários e SAA: decidir antes de conhecer a demanda
Projetar com uma referência explícita
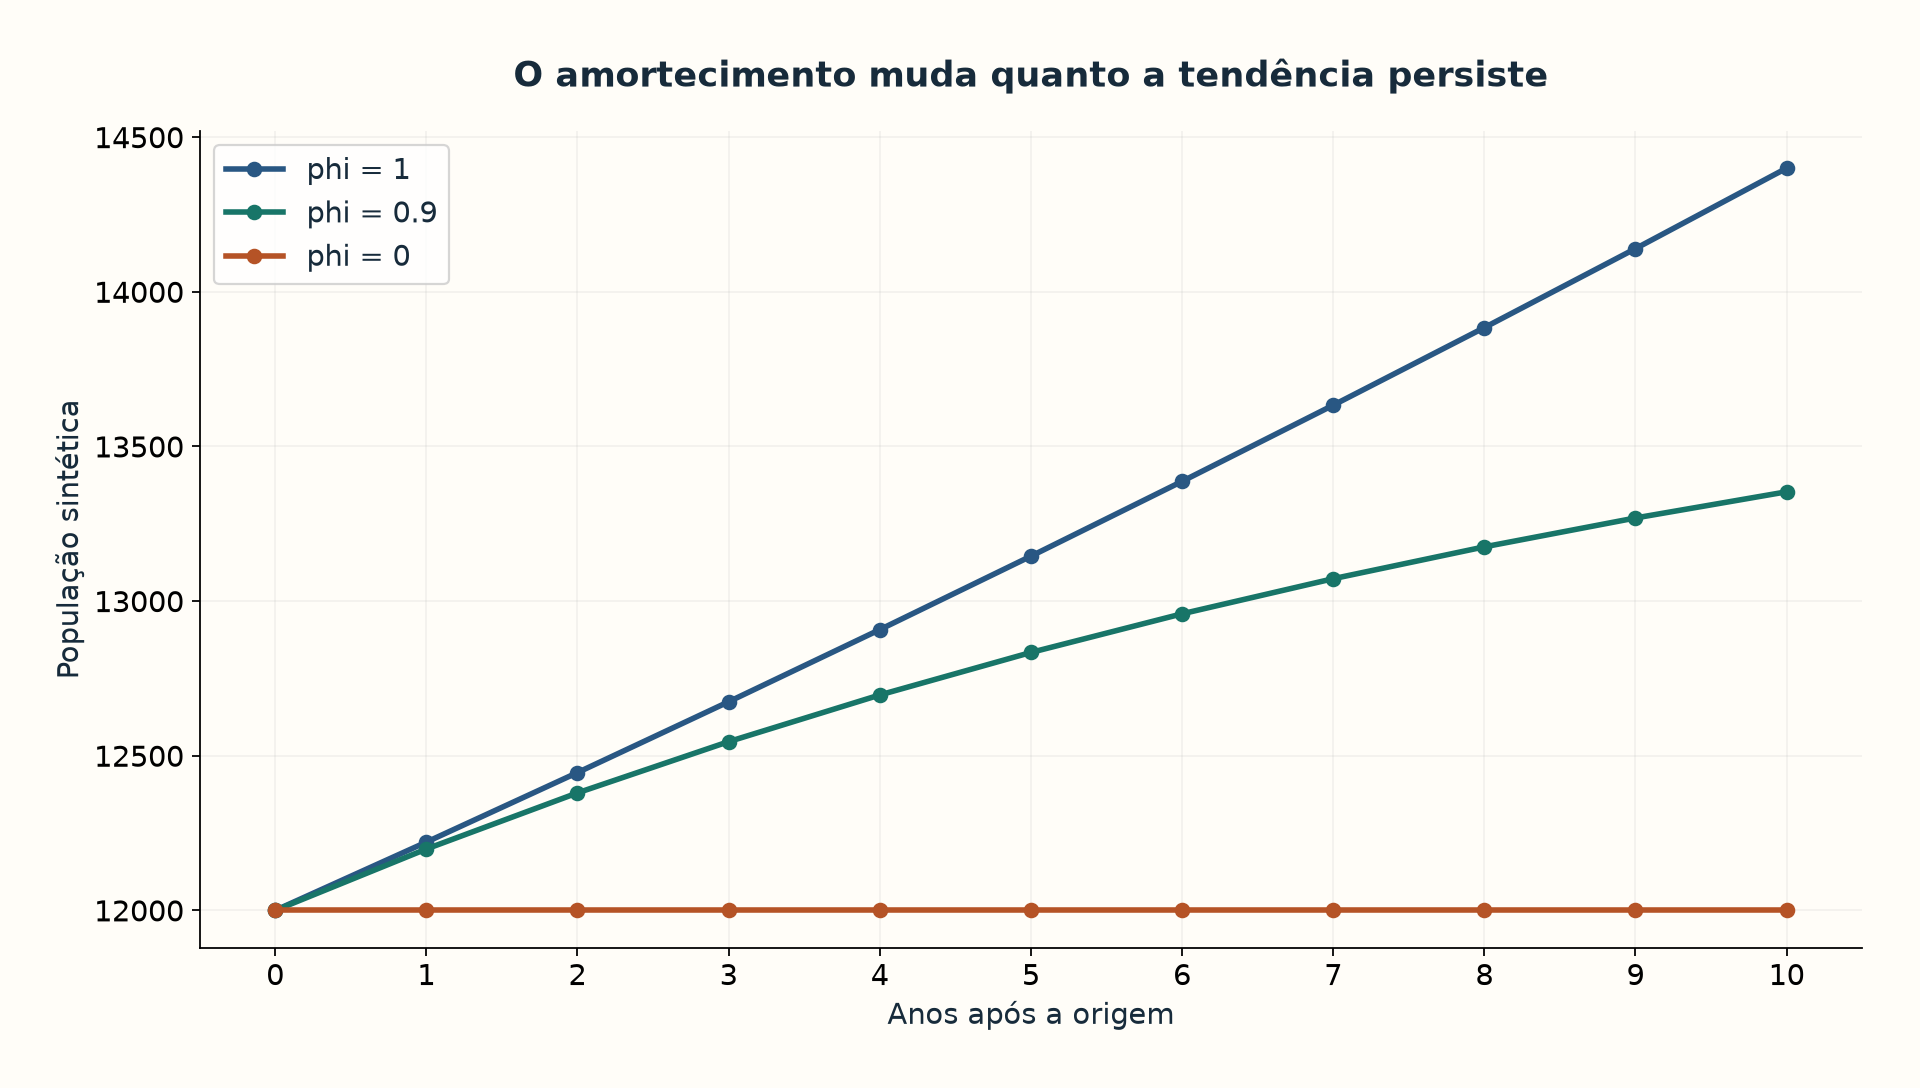
Uma cidade que cresceu rapidamente não mantém necessariamente esse ritmo durante décadas. O projeto combina sua taxa recente com a mediana dos municípios do mesmo estado e faixa populacional. O peso w determina quanto confiar na tendência municipal; phi amortece sua persistência. Funciona como ouvir a trajetória individual junto da experiência de um grupo comparável, sem supor que todos os municípios sejam iguais.
g_local = (P_last / P_past)**(1 / window) - 1
g_effective = w*g_local + (1-w)*g_group
steps = sum(phi**k for k in range(1, horizon+1))
P_forecast = P_last * (1 + g_effective)**steps
Com w=1 usa-se apenas crescimento local; com w=0, apenas a referência do grupo. Phi=1 mantém a taxa ao longo do horizonte; valores menores reduzem sua persistência. O caso phi=0 mantém o último nível e serve como referência ingênua. Escolher parâmetros exige testes anteriores à data avaliada, não selecionar retrospectivamente aquele que mais combina com o ano que se deseja prever.
Executar um exemplo controlado
import pandas as pd
from alocacao_capacitada.ml.forecast import Config, predict

series = pd.DataFrame({2010: [10000., 20000.],
                       2020: [12000., 22000.]}, index=[1, 2])
uf = pd.Series(["SP", "SP"], index=series.index)
pred = predict(series, uf, origin=2020, horizon=5,
               config=Config(window=10, w=1.0, phi=1.0))
print(pred.round(1).to_dict())
Os dados deste exemplo são sintéticos e devem produzir aproximadamente 13145,3 e 23073,8 habitantes. Servem para conferir a fórmula, não para descrever municípios reais. Depois altere phi e observe como muda a projeção mantendo o nível inicial. Para avaliar precisão, você precisa de valores posteriores observados e de múltiplas origens temporais, comparando sempre horizontes equivalentes.
O que observar nos dados e nas métricas
As estimativas do IBGE anteriores ao Censo 2022 e as revisadas posteriormente pertencem a séries metodológicas diferentes. O módulo separa essas etapas e marca anos interpolados. Um salto entre versões não deve ser interpretado automaticamente como crescimento real. Também convém perguntar se a interpolação usou um dado que ainda não existia na data simulada: validação temporal exige reproduzir a informação disponível, não apenas ordenar as colunas por ano.
A revisão encontrou que census_backtest calcula exp(|log(previsto/real)|)−1 sob uma etiqueta de APE. Se a previsão for 80 e o observado 100, essa expressão produz 25%, enquanto o APE convencional |previsto−real|/real produz 20%. Ambas as expressões podem ser estudadas, mas não são intercambiáveis. Antes de citar porcentagens censitárias do repositório, recalcule a métrica desejada a partir das previsões. Esse código não foi alterado durante a preparação da série.
Por fim, população projetada não equivale a demanda logística. Convertê-la em pedidos exige hipóteses adicionais de propensão, participação de mercado e frequência de compra. Avalie essas hipóteses por cenários e confira a rede com capacidade fixa. Uma previsão mais precisa só justifica um modelo mais complexo se melhorar a decisão que você realmente precisa tomar.
Fontes e evidências
Próximo: K-means: descobrir perfis municipais sem inventar categorias naturais