Dos pedidos à rede logística: um projeto de otimização e machine learning
O que construí, como os algoritmos se conectam e o que demonstram os experimentos de localização de centros com capacidade limitada.

Série: dos dados à decisão logística
- Dos pedidos à rede logística: um projeto de otimização e machine learning
- MILP: transformar uma decisão logística em um modelo verificável
- Relaxação linear: quanto uma solução ainda pode melhorar
- Guloso e busca local: construir rápido e melhorar com critério
- LNS: reorganizar parte da rede para escapar do ótimo local
- Prever demanda: de uma referência populacional a Poisson e boosting
- Previsão populacional: tendências, amortecimento e teste temporal
- K-means: descobrir perfis municipais sem inventar categorias naturais
- Scoring de candidatos: aprender a filtrar sem perder boas decisões
- Cenários e SAA: decidir antes de conhecer a demanda
A pergunta antes do algoritmo
Onde abrir centros de distribuição e a qual centro atribuir cada região? Aproximar-se do cliente reduz deslocamentos, mas abrir instalações custa dinheiro e cada uma admite um volume limitado. Meu projeto transforma esse conflito em um modelo que permite comparar decisões com regras explícitas. O objetivo desta série é ensinar a construir e questionar esse processo, dos dados à leitura do resultado.
Uma cadeia com responsabilidades distintas
A engenharia de dados preserva fontes, normaliza municípios e registra proveniência. Os modelos de demanda estimam pedidos; a previsão populacional constrói futuros; o agrupamento descreve perfis territoriais. Depois, a otimização escolhe instalações e atribuições. O scoring reduz candidatos e a análise de cenários verifica se uma escolha resiste a mudanças. Nenhuma etapa substitui a seguinte: prever onde haverá demanda não decide, por si só, onde convém instalar-se.
Três escalas de evidência
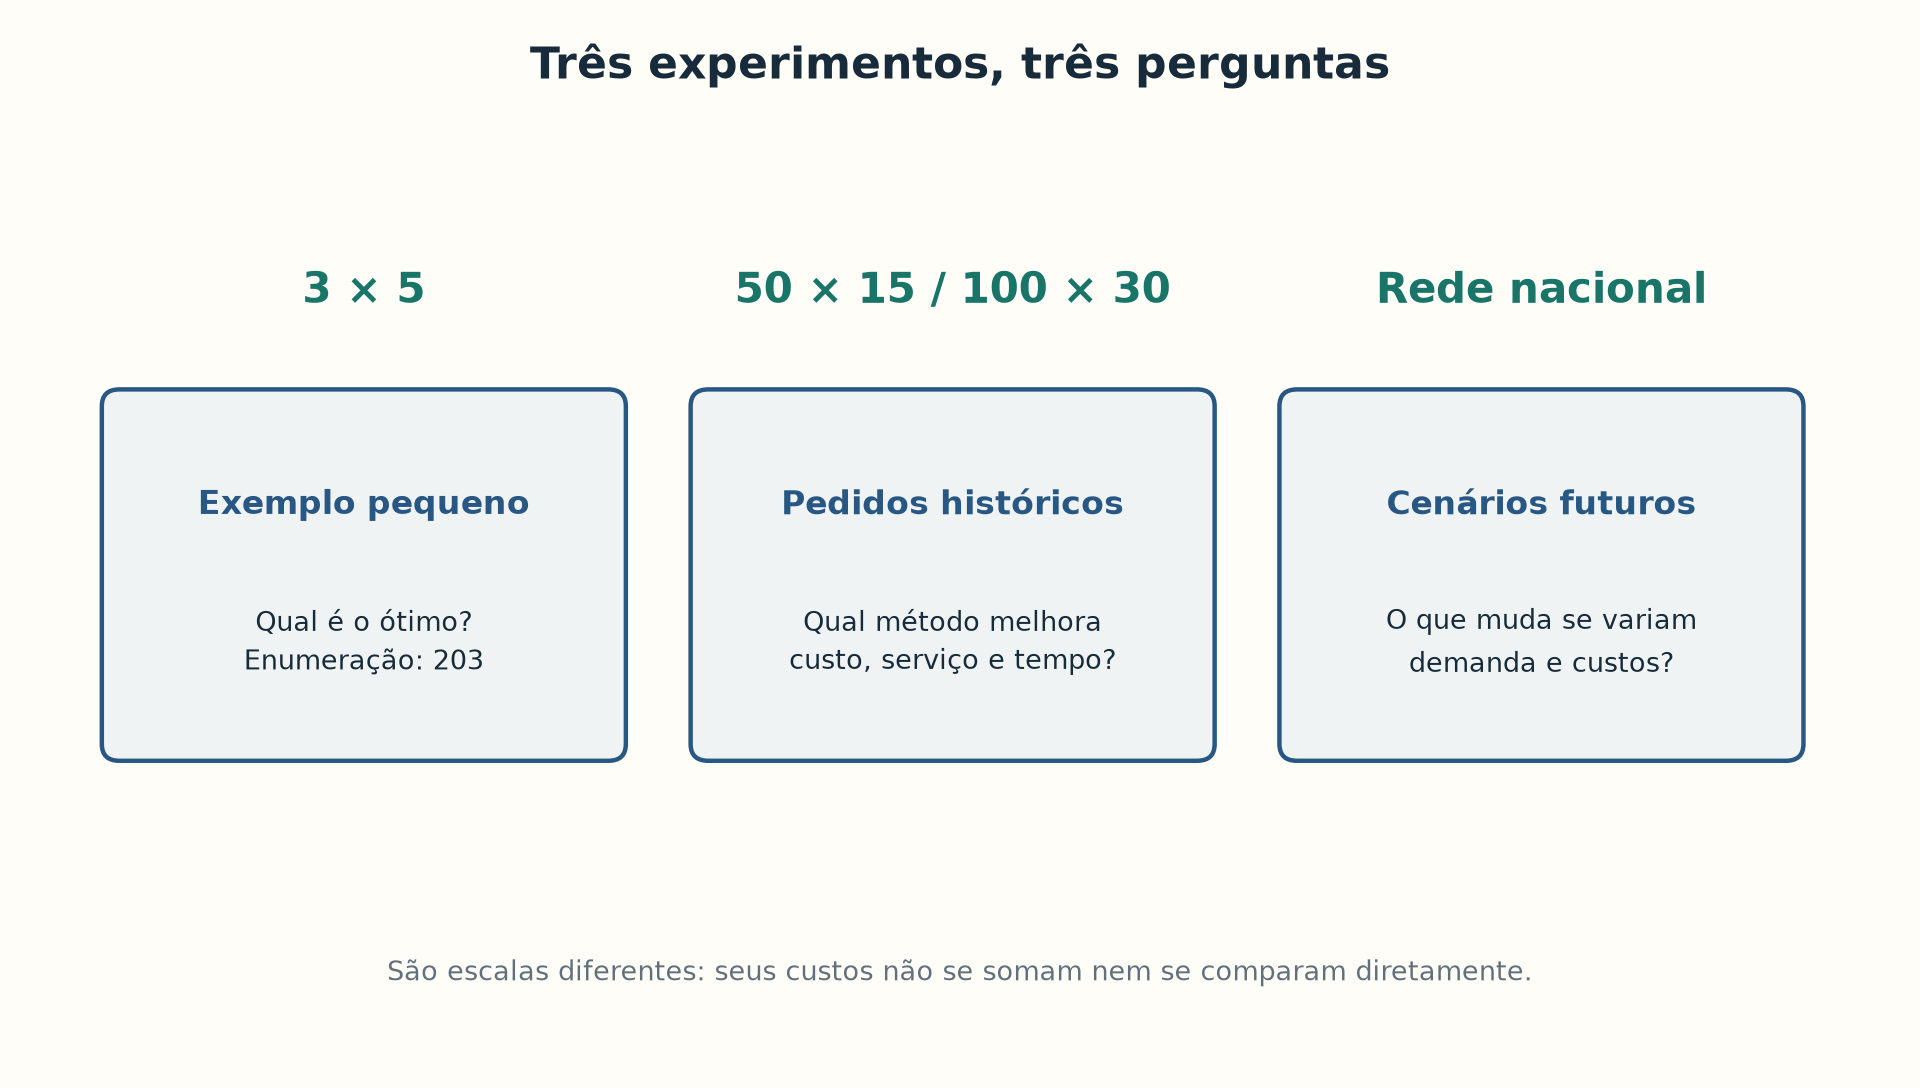
O exemplo didático tem três centros e cinco regiões: permite enumerar todas as decisões e provar o ótimo de 203 unidades monetárias. O estudo histórico utiliza recortes de pedidos Olist, com 50 regiões e 15 candidatos ou 100 regiões e 30 candidatos. A rede nacional acrescenta população, propensão e cenários de mercado. São experimentos com horizontes e hipóteses diferentes; somar suas cifras ou apresentar seus custos como comparáveis seria incorreto.
| Método | Custo 50×15 | Custo 100×30 |
|---|---|---|
| Guloso | 994102.40 | 1352149.43 |
| Busca local | 920006.98 | 1339302.12 |
| MILP | 919471.41 | 1310952.57 |
| MILP aquecido | 894531.26 | 1313883.90 |
| LNS, média de 3 sementes | 893976.56 | 1309923.03 |
O orçamento nominal foi de dez segundos por execução; os métodos rápidos terminaram antes e houve pequenos excessos de tempo no LNS. Todos atenderam 100% da demanda selecionada, que representa aproximadamente 27,66% e 43,01% dos pedidos do universo de referência. O custo médio do LNS foi 10,07% menor que o guloso em 50×15, calculado sobre o custo guloso. É uma melhoria computacional sob essas hipóteses, não uma economia operacional medida.
Como estudar e reproduzir
Comece pelo modelo e execute o exemplo pequeno antes de alterar parâmetros. Depois compare heurísticas, limites e sementes; só então acrescente previsão e cenários. O repositório exige Python 3.12 ou superior e declara Cavuca como dependência editável na pasta irmã ../Cavuca: clonar apenas este repositório não garante instalar todo o ambiente. Os exemplos da série que importam alocacao_capacitada devem ser executados nesse ambiente preparado. O site publicado contém apenas páginas estáticas.
A revisão local de 01/10/2026 executou 91 testes com sucesso. Também identificou uma métrica censitária que não coincide com o APE convencional e uma descrição do LNS mais forte que a garantia real do código. Os artigos explicam ambas as limitações. Os resultados maiores citados aqui foram confrontados com os CSV existentes; nem todas as simulações nacionais foram reexecutadas. Antes de uma decisão real faltam contratos de transporte, capacidade operacional, custos completos e níveis de serviço.
Fontes e evidências
Próximo: MILP: transformar uma decisão logística em um modelo verificável