Prever demanda: de uma referência populacional a Poisson e boosting
Como preparar o alvo, validar por território e ler erros sem transformar pedidos de um marketplace em todo o mercado.

Série: dos dados à decisão logística
- Dos pedidos à rede logística: um projeto de otimização e machine learning
- MILP: transformar uma decisão logística em um modelo verificável
- Relaxação linear: quanto uma solução ainda pode melhorar
- Guloso e busca local: construir rápido e melhorar com critério
- LNS: reorganizar parte da rede para escapar do ótimo local
- Prever demanda: de uma referência populacional a Poisson e boosting
- Previsão populacional: tendências, amortecimento e teste temporal
- K-means: descobrir perfis municipais sem inventar categorias naturais
- Scoring de candidatos: aprender a filtrar sem perder boas decisões
- Cenários e SAA: decidir antes de conhecer a demanda
Definir o que estamos estimando
Os pedidos observados resultam de população, renda, acesso, oferta e participação da plataforma. O projeto aprende propensão relativa de compra na Olist durante uma janela histórica. Um município sem pedidos registrados pode ter clientes atendidos por outras empresas; zero observado não significa mercado inexistente. Antes de treinar, defina período, unidade geográfica, pedidos válidos e tratamento dos municípios sem correspondência.
A referência mais simples distribui pedidos proporcionalmente à população. O GLM de Poisson permite que a taxa dependa de atributos por meio de uma ligação logarítmica. O boosting soma árvores que corrigem erros sucessivos e pode capturar relações não lineares. Na implementação, aprende-se pedidos/população com peso igual à população e multiplica-se a taxa prevista pela população para recuperar pedidos. Não confunda essa ponderação com duplicar linhas sem controle.
Como aplicar a validação espacial
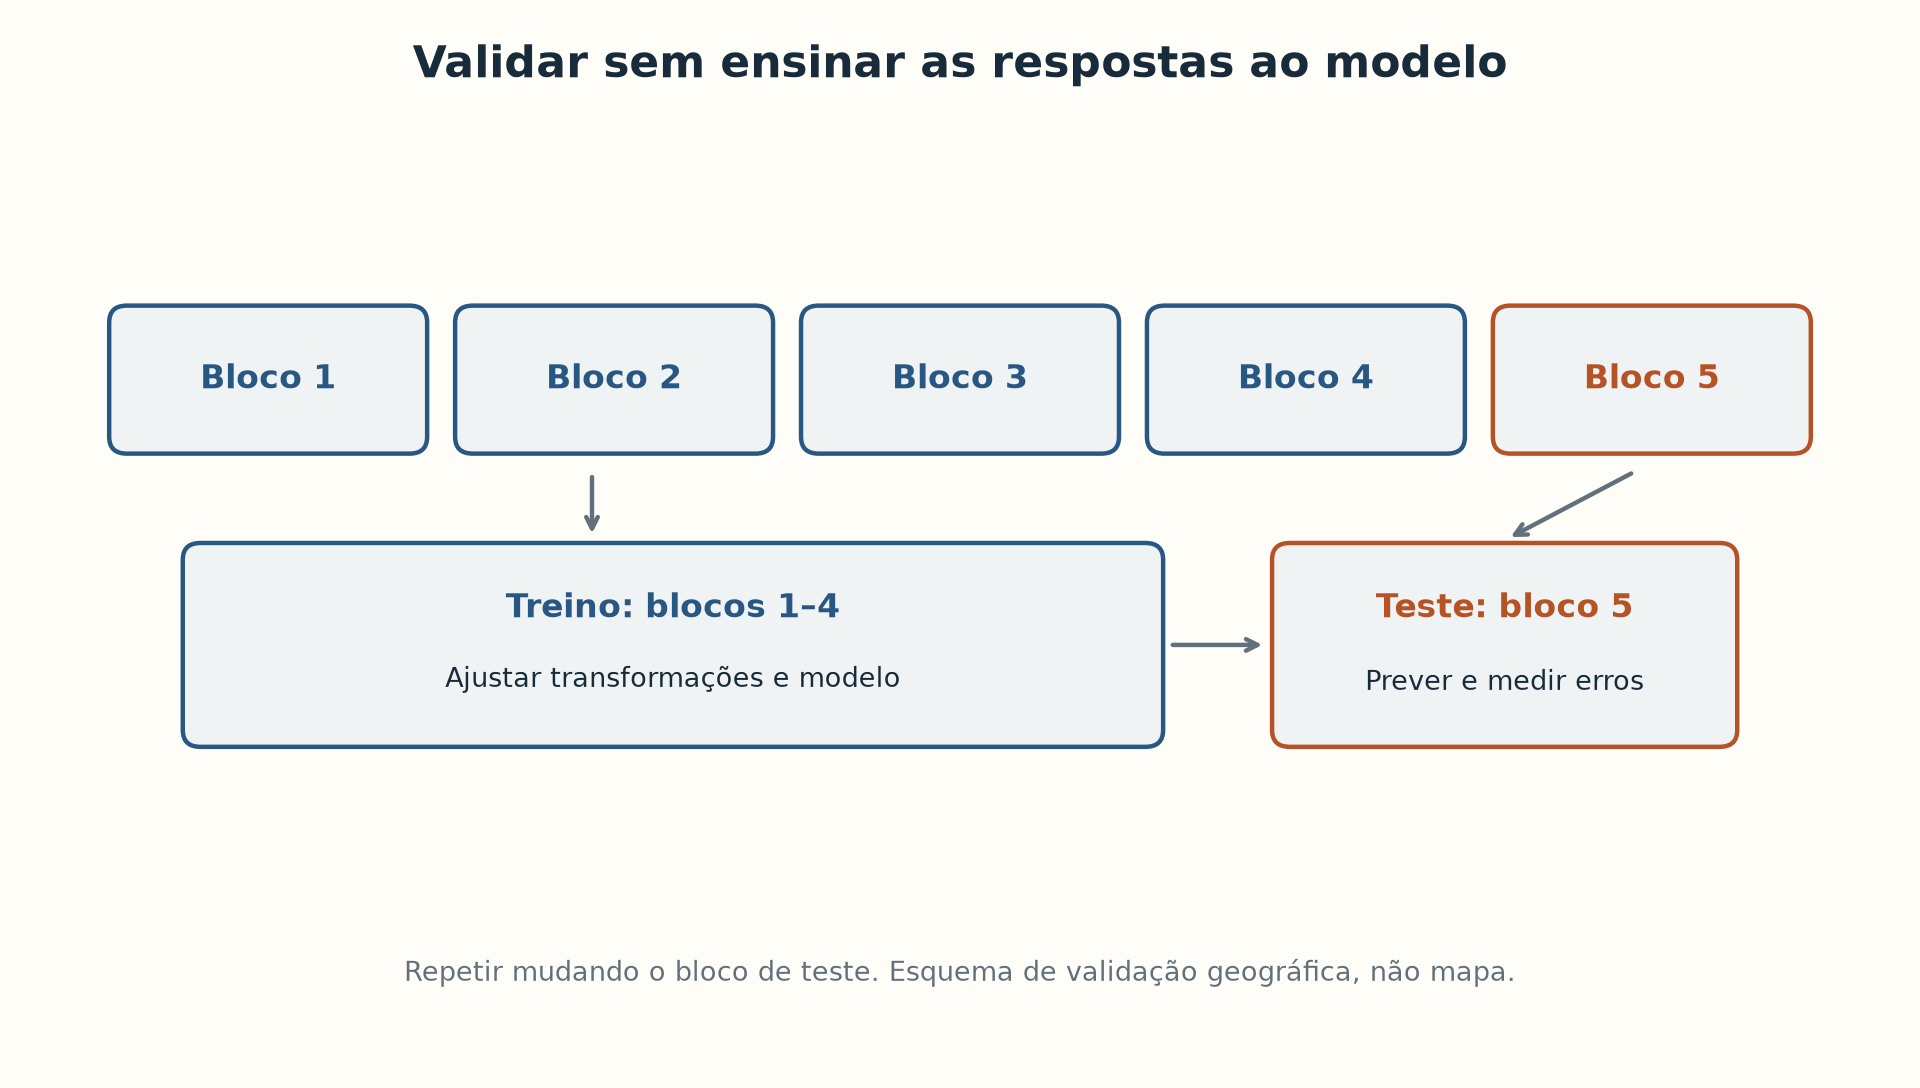
Municípios vizinhos costumam se parecer. Separar linhas aleatoriamente pode deixar exemplos muito semelhantes no treino e no teste. O projeto usa cinco grupos de estados ou deixa uma macrorregião de fora. Ajuste escalas e modelos somente com o treino; calcule cada previsão de teste com um modelo que não tenha visto seu bloco. Se quiser prever o futuro, acrescente também uma separação temporal com atributos disponíveis na data da decisão.
from pathlib import Path
import pandas as pd
from alocacao_capacitada.ml.demand_model import cross_predict, evaluate_predictions

table = pd.read_csv(Path("results/estudo_integrado_20261001/dados_municipais.csv"))
predictions = cross_predict(table, scheme="uf")
print(evaluate_predictions(predictions).to_string(index=False))
Este comando executa a família do módulo demand_model; não reproduz exatamente a ablação do estudo integrado, que usa três conjuntos de atributos e boosting com 150 iterações. Para essa ablação, consulte os CSV vinculados. Manter 5564 municípios e as mesmas partições permite comparar atributos sem atribuir a um modelo a vantagem de ter recebido uma amostra mais fácil.
| Atributos | Deviance Poisson | MAE em pedidos | Previsto/observado |
|---|---|---|---|
| Somente população | 14.16 | 12.49 | 0.97 |
| Históricos selecionados | 3.98 | 6.23 | 0.95 |
| Retrospectivos completos | 3.14 | 5.42 | 0.91 |
Interpretar mais que o menor erro
MAE informa o erro absoluto médio em pedidos. A deviance Poisson avalia o ajuste de previsões positivas a contagens; menor é melhor na mesma amostra. A razão previsto/observado mostra viés agregado: 0,91 indica subestimação total próxima de 9%, embora o MAE seja menor. Analise resíduos por estado e porte do município. Spearman alto indica boa ordenação relativa, não necessariamente quantidades bem calibradas.
A ablação completa usa informação retrospectiva, incluindo informação posterior ao período dos pedidos. Sua melhoria não prova uma previsão que teria sido possível naquela época. Mesmo o subconjunto histórico exige conferir datas de publicação. Para decidir se vale usar o modelo, leve suas previsões ao otimizador e meça mudanças de custo e atendimento fora da amostra: uma melhoria preditiva pode deixar quase intacta a localização escolhida.
Fontes e evidências
Próximo: Previsão populacional: tendências, amortecimento e teste temporal