K-means: descobrir perfis municipais sem inventar categorias naturais
Normalização, escolha de k, silhueta e estabilidade para interpretar agrupamentos territoriais.

Série: dos dados à decisão logística
- Dos pedidos à rede logística: um projeto de otimização e machine learning
- MILP: transformar uma decisão logística em um modelo verificável
- Relaxação linear: quanto uma solução ainda pode melhorar
- Guloso e busca local: construir rápido e melhorar com critério
- LNS: reorganizar parte da rede para escapar do ótimo local
- Prever demanda: de uma referência populacional a Poisson e boosting
- Previsão populacional: tendências, amortecimento e teste temporal
- K-means: descobrir perfis municipais sem inventar categorias naturais
- Scoring de candidatos: aprender a filtrar sem perder boas decisões
- Cenários e SAA: decidir antes de conhecer a demanda
Agrupar responde a uma pergunta diferente
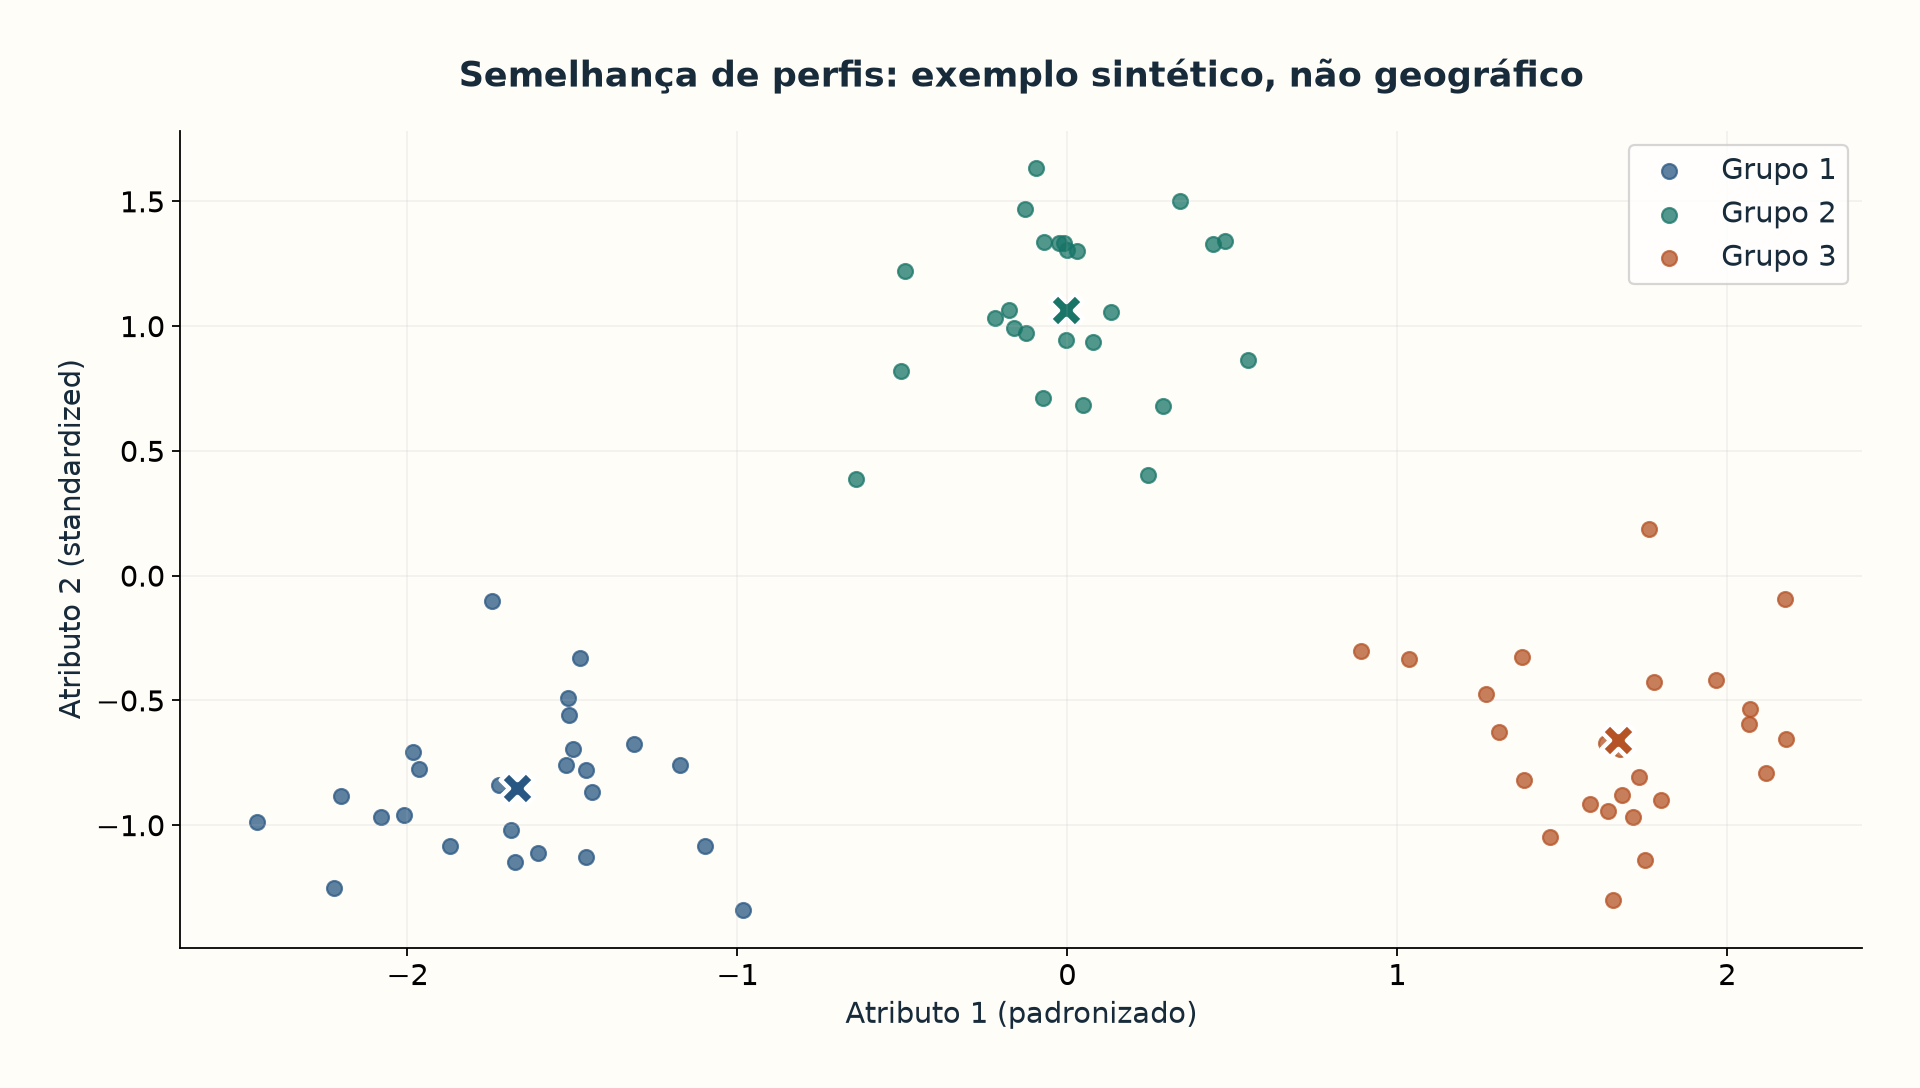
Prever pedidos busca uma quantidade; agrupar municípios busca semelhanças. O K-means organiza observações ao redor de k centroides e reduz a soma das distâncias quadráticas a esses centros no espaço dos atributos. No projeto, esse espaço inclui população, crescimento, idade, renda e distância a polos. Um centroide é um perfil numérico: não é uma localização recomendada para um galpão.
Pense em organizar uma biblioteca por semelhança de conteúdo: as categorias ajudam a explorar, mas dependem dos critérios escolhidos. Se você muda os atributos, muda a noção de proximidade. Sem normalização, uma variável com números grandes pode dominar outra medida em proporções. O módulo aplica StandardScaler e usa várias inicializações para reduzir a dependência de um ponto de partida desfavorável.
Preparar e executar
import pandas as pd
from sklearn.preprocessing import StandardScaler
from alocacao_capacitada.ml.clustering import CLUSTER_FEATURES, choose_k, fit_clusters

table = pd.read_csv("results/estudo_integrado_20261001/dados_municipais.csv")
complete = table[table["completo"]].copy()
x = StandardScaler().fit_transform(complete[CLUSTER_FEATURES])
print(choose_k(x).to_string(index=False))
labels, profile = fit_clusters(table, k=4)
print(profile.to_string(index=False))
O valor k=4 é um exemplo de uso, não uma recomendação derivada de resultados. Primeiro leia a tabela de candidatos. A silhueta contrasta proximidade dentro do grupo com separação em relação aos outros grupos. A estabilidade do projeto repete ajustes sobre subamostras de 80%, prevê rótulos sobre o conjunto completo e compara partições pelo Rand ajustado. Procure grupos interpretáveis que não desapareçam quando a amostra varia ligeiramente.
Do rótulo ao perfil
Leia quantidade de municípios, população mediana, população total, renda e pedidos por grupo. Um grupo com mais pedidos pode simplesmente conter mais pessoas. Compare taxas e dispersão, além das médias. Os números dos rótulos não têm significado intrínseco; o código os reordena por população mediana para facilitar a leitura, sem transformá-los em uma classificação de qualidade.
Pergunte se os perfis ajudam a desenhar cenários ou a localizar erros do modelo de demanda. Se apenas produzirem nomes chamativos, talvez uma tabela por porte e região seja suficiente. O K-means favorece grupos compactos na geometria escolhida e pode esconder formas irregulares ou municípios atípicos. Também não demonstra causas: pertencer a um grupo não explica, por si só, por que uma cidade compra mais.
Fontes e evidências
Próximo: Scoring de candidatos: aprender a filtrar sem perder boas decisões