K-means: descubrir perfiles municipales sin inventar categorías naturales
Normalización, elección de k, silueta y estabilidad para interpretar agrupamientos territoriales.

Serie: de los datos a la decisión logística
- De los pedidos a la red logística: un proyecto de optimización y aprendizaje automático
- MILP: convertir una decisión logística en un modelo verificable
- Relajación lineal: cuánto puede mejorar una solución
- Voraz y búsqueda local: construir rápido y mejorar con criterio
- LNS: reorganizar parte de la red para escapar del óptimo local
- Predecir demanda: de una referencia poblacional a Poisson y boosting
- Previsión poblacional: tendencias, amortiguación y prueba temporal
- K-means: descubrir perfiles municipales sin inventar categorías naturales
- Scoring de candidatos: aprender a filtrar sin perder buenas decisiones
- Escenarios y SAA: decidir antes de conocer la demanda
Agrupar responde a una pregunta distinta
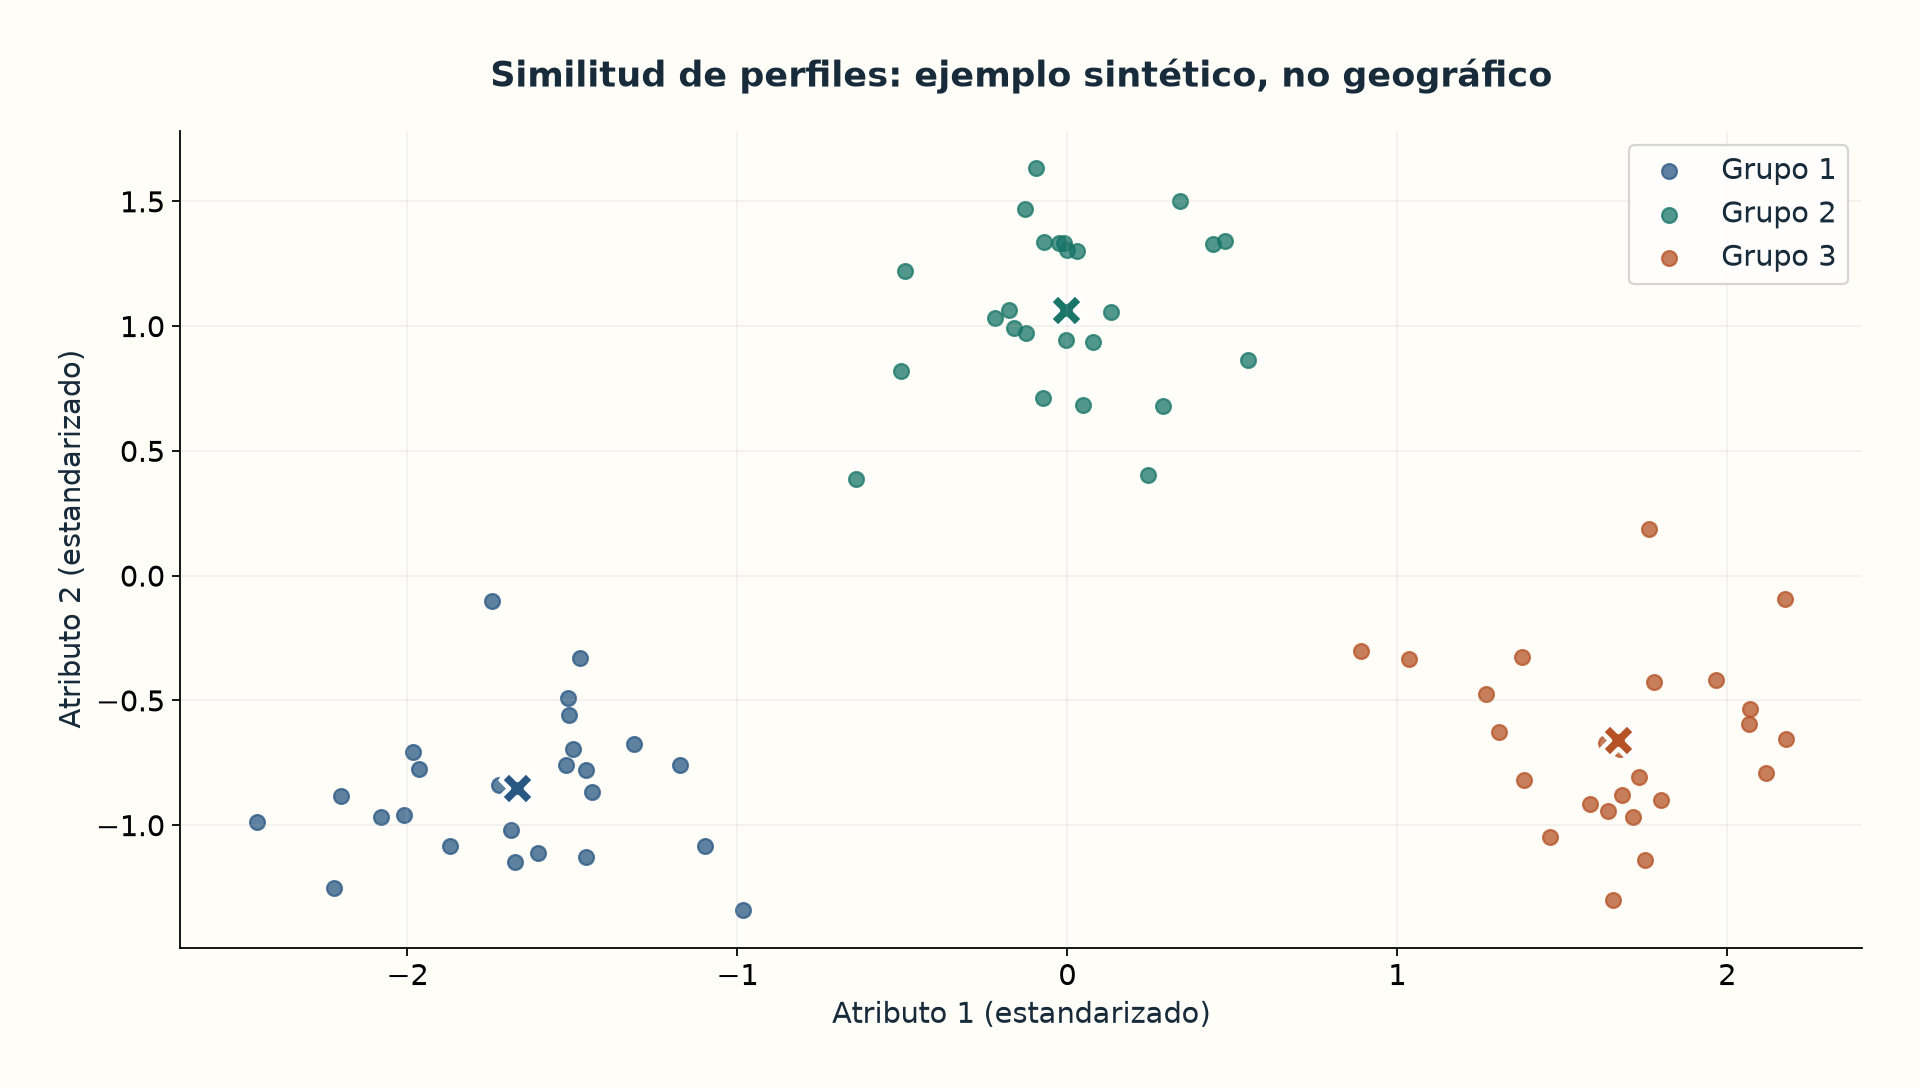
Predecir pedidos busca una cantidad; agrupar municipios busca similitudes. K-means organiza observaciones alrededor de k centroides y reduce la suma de distancias cuadradas a esos centros en el espacio de atributos. En el proyecto, ese espacio incluye población, crecimiento, edad, renta y distancia a polos. Un centroide es un perfil numérico: no es una ubicación recomendada para un almacén.
Piense en organizar una biblioteca por semejanza de contenido: las categorías ayudan a explorar, pero dependen de los criterios elegidos. Si cambia los atributos, cambia la noción de cercanía. Sin normalización, una variable con números grandes puede dominar a otra medida en proporciones. El módulo aplica StandardScaler y utiliza varias inicializaciones para reducir dependencia de un punto de partida desfavorable.
Preparar y ejecutar
import pandas as pd
from sklearn.preprocessing import StandardScaler
from alocacao_capacitada.ml.clustering import CLUSTER_FEATURES, choose_k, fit_clusters

table = pd.read_csv("results/estudo_integrado_20261001/dados_municipais.csv")
complete = table[table["completo"]].copy()
x = StandardScaler().fit_transform(complete[CLUSTER_FEATURES])
print(choose_k(x).to_string(index=False))
labels, profile = fit_clusters(table, k=4)
print(profile.to_string(index=False))
El valor k=4 es un ejemplo de uso, no una recomendación derivada de resultados. Primero lea la tabla de candidatos. La silueta contrasta cercanía dentro del grupo con separación respecto a otros grupos. La estabilidad del proyecto repite ajustes sobre submuestras del 80%, predice etiquetas sobre el conjunto completo y compara particiones mediante Rand ajustado. Busque grupos interpretables que no desaparezcan al variar ligeramente la muestra.
De la etiqueta al perfil
Lea número de municipios, población mediana, población total, renta y pedidos por grupo. Un grupo con más pedidos puede simplemente contener más personas. Compare tasas y dispersión, además de medias. Los números de las etiquetas no tienen significado intrínseco; el código los reordena por población mediana para facilitar lectura, sin convertirlos en una clasificación de calidad.
Pregunte si los perfiles ayudan a diseñar escenarios o a localizar errores del modelo de demanda. Si solo producen nombres vistosos, quizá una tabla por tamaño y región sea suficiente. K-means favorece grupos compactos en la geometría elegida y puede ocultar formas irregulares o municipios atípicos. Tampoco demuestra causas: pertenecer a un grupo no explica por sí mismo por qué una ciudad compra más.
Fuentes y evidencias
Siguiente: Scoring de candidatos: aprender a filtrar sin perder buenas decisiones