LNS: reorganizar parte de la red para escapar del óptimo local
Destrucción, reparación con MILP, semillas y curvas de convergencia en una búsqueda de vecindad grande.

Serie: de los datos a la decisión logística
- De los pedidos a la red logística: un proyecto de optimización y aprendizaje automático
- MILP: convertir una decisión logística en un modelo verificable
- Relajación lineal: cuánto puede mejorar una solución
- Voraz y búsqueda local: construir rápido y mejorar con criterio
- LNS: reorganizar parte de la red para escapar del óptimo local
- Predecir demanda: de una referencia poblacional a Poisson y boosting
- Previsión poblacional: tendencias, amortiguación y prueba temporal
- K-means: descubrir perfiles municipales sin inventar categorías naturales
- Scoring de candidatos: aprender a filtrar sin perder buenas decisiones
- Escenarios y SAA: decidir antes de conocer la demanda
Por qué cambiar una pieza puede no bastar
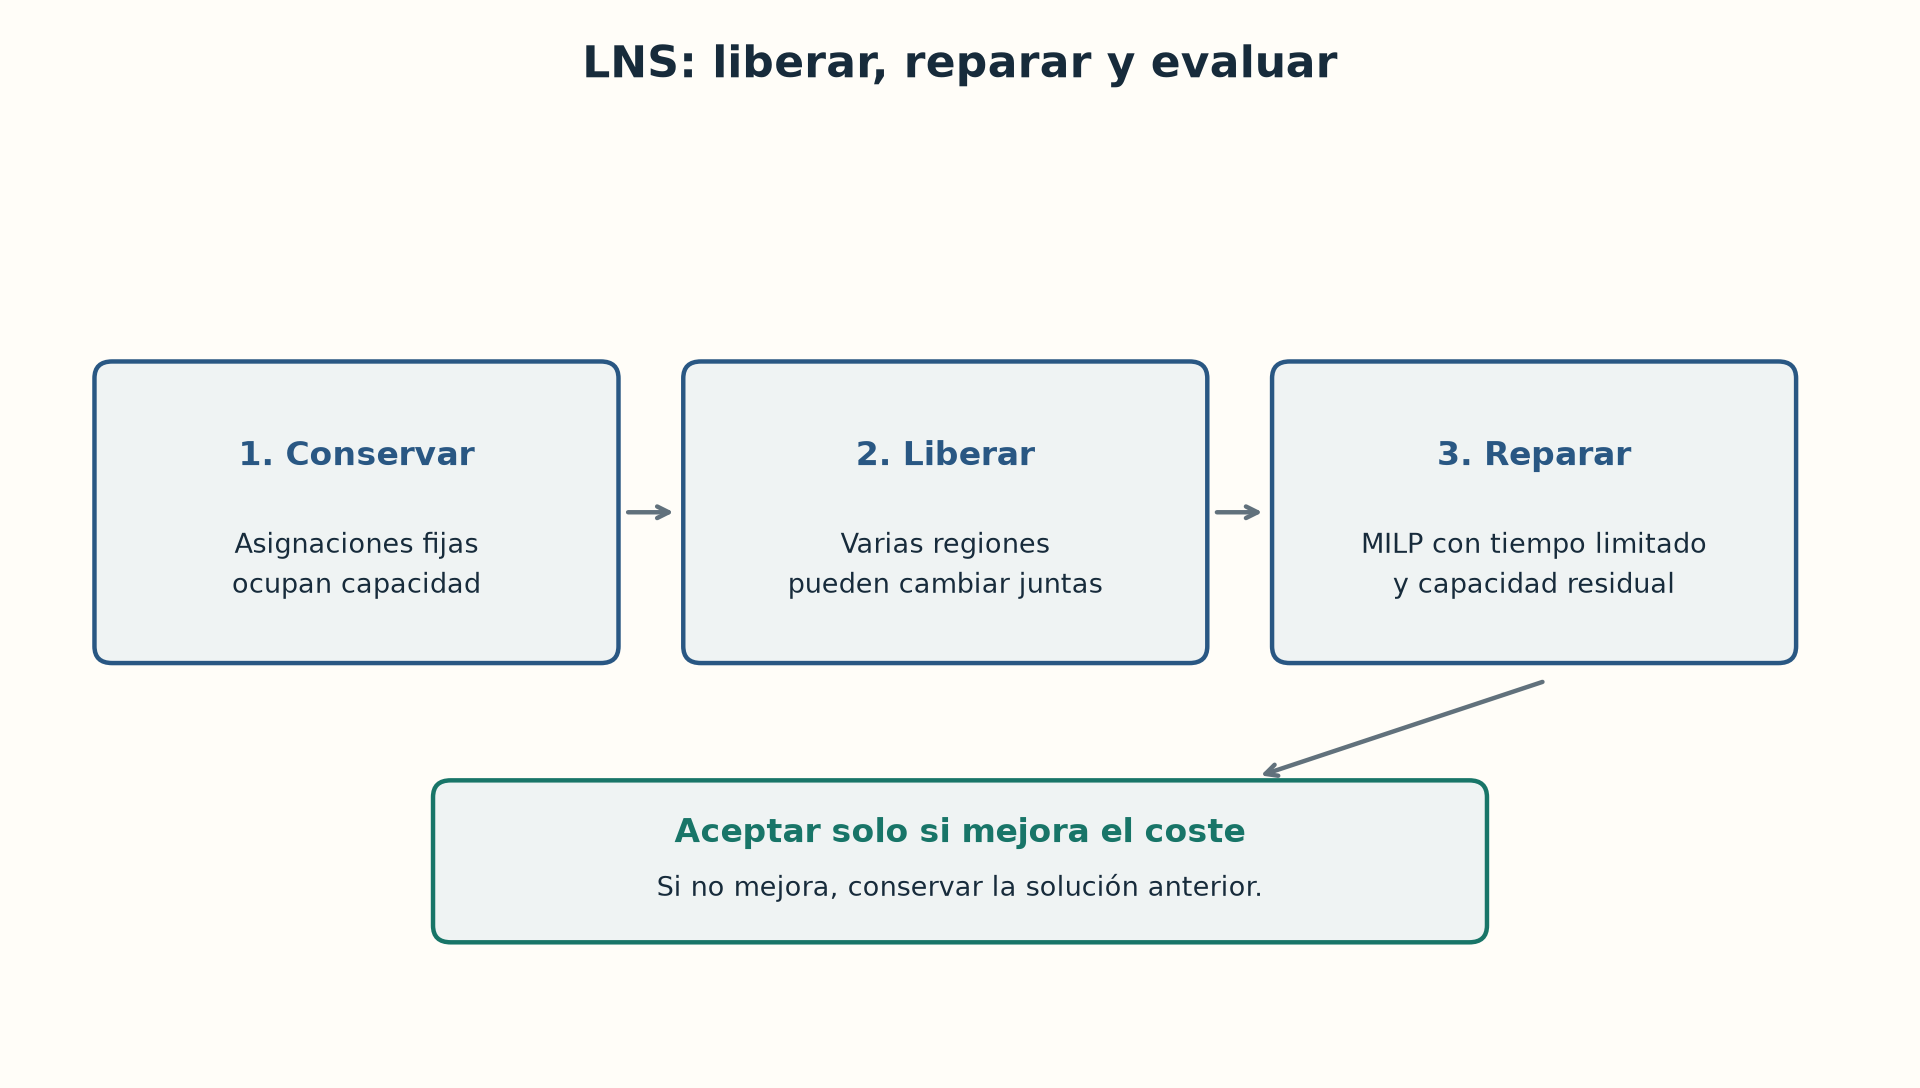
Una red puede necesitar mover varias regiones a la vez para cerrar una instalación. Si solo se aceptan cambios pequeños que mejoran inmediatamente, ese ahorro queda fuera de alcance. Large Neighborhood Search, o LNS, libera un conjunto de asignaciones, mantiene el resto y resuelve cómo reorganizar la parte liberada. La imagen útil es reformar una habitación conservando el resto de la casa: se gana libertad local sin reconstruir todo el problema.
En el proyecto, la selección alterna regiones con perfiles de coste parecidos y regiones asociadas a centros abiertos, respetando el tamaño máximo de la vecindad. El reparo usa MILP y capacidad residual: la demanda congelada sigue ocupando espacio. La nueva solución solo se acepta si mejora estrictamente el coste. Así, el coste del incumbente no aumenta, aunque algunas iteraciones no produzcan mejora.
Preparar una ejecución observable
from alocacao_capacitada.analysis.study import tiny_instance
from alocacao_capacitada.solvers.greedy import NearestFeasibleGreedy
from alocacao_capacitada.solvers.lns import LnsSolver
from alocacao_capacitada.domain.evaluation import evaluate

inst = tiny_instance()
trace = []
solver = LnsSolver(NearestFeasibleGreedy(), seed=0, free_size=5,
                   sub_time_limit_s=1.0, max_iterations=10,
                   on_progress=lambda i,t,c: trace.append((i,t,c)))
result = solver.solve(inst, 5.0)
print(evaluate(inst, result.solution).total_cost)
print(trace)
El ejemplo libera hasta cinco regiones porque solo existen cinco. En problemas mayores, pruebe tamaños pequeños y medianos con el mismo presupuesto total, incluyendo inicialización. Vecindades grandes permiten cambios más profundos, pero cada reparo cuesta más tiempo; vecindades pequeñas permiten más intentos. La semilla controla la selección aleatoria. Repita semillas y guarde cada ejecución, no solo la mejor.
Lo que una curva permite concluir
En la traza, un descenso indica una mejora aceptada y una meseta indica intentos sin mejora. Una meseta no prueba optimalidad. En 50×15, las tres ejecuciones guardadas costaron 885420,59, 893046,17 y 903462,92, con gaps frente al LP de 1,57%, 2,41% y 3,53%. La variación importa: presentar solo la primera ocultaría la sensibilidad a la semilla. Tres repeticiones describen esta muestra, pero no establecen una distribución universal de rendimiento.
Aunque el comentario inicial del módulo habla de resolver exactamente el subproblema, el código acepta también soluciones viables al límite de tiempo. La descripción precisa es reparación con MILP bajo presupuesto, sin garantía de óptimo en cada reparo. Tampoco hay certificado global de optimalidad del LNS. Para analizarlo, compare coste, servicio, tiempo real y límite inferior sobre la misma instancia; observe además cuánto mejora después de los primeros segundos.
Fuentes y evidencias
Siguiente: Predecir demanda: de una referencia poblacional a Poisson y boosting