Predecir demanda: de una referencia poblacional a Poisson y boosting
Cómo preparar el objetivo, validar por territorio y leer errores sin convertir pedidos de un marketplace en todo el mercado.

Serie: de los datos a la decisión logística
- De los pedidos a la red logística: un proyecto de optimización y aprendizaje automático
- MILP: convertir una decisión logística en un modelo verificable
- Relajación lineal: cuánto puede mejorar una solución
- Voraz y búsqueda local: construir rápido y mejorar con criterio
- LNS: reorganizar parte de la red para escapar del óptimo local
- Predecir demanda: de una referencia poblacional a Poisson y boosting
- Previsión poblacional: tendencias, amortiguación y prueba temporal
- K-means: descubrir perfiles municipales sin inventar categorías naturales
- Scoring de candidatos: aprender a filtrar sin perder buenas decisiones
- Escenarios y SAA: decidir antes de conocer la demanda
Definir qué estamos estimando
Los pedidos observados son el resultado de población, renta, acceso, oferta y participación de la plataforma. El proyecto aprende propensión relativa de compra en Olist durante una ventana histórica. Un municipio sin pedidos registrados puede tener clientes atendidos por otras empresas; cero observado no significa mercado inexistente. Antes de entrenar, defina periodo, unidad geográfica, pedidos válidos y tratamiento de municipios sin correspondencia.
La referencia más simple distribuye pedidos proporcionalmente a la población. El GLM de Poisson permite que la tasa dependa de atributos mediante un enlace logarítmico. El boosting suma árboles que corrigen errores sucesivos y puede captar relaciones no lineales. En la implementación se aprende pedidos/población con peso igual a población y se multiplica la tasa prevista por la población para recuperar pedidos. No confunda esa ponderación con duplicar filas sin control.
Cómo aplicar la validación espacial
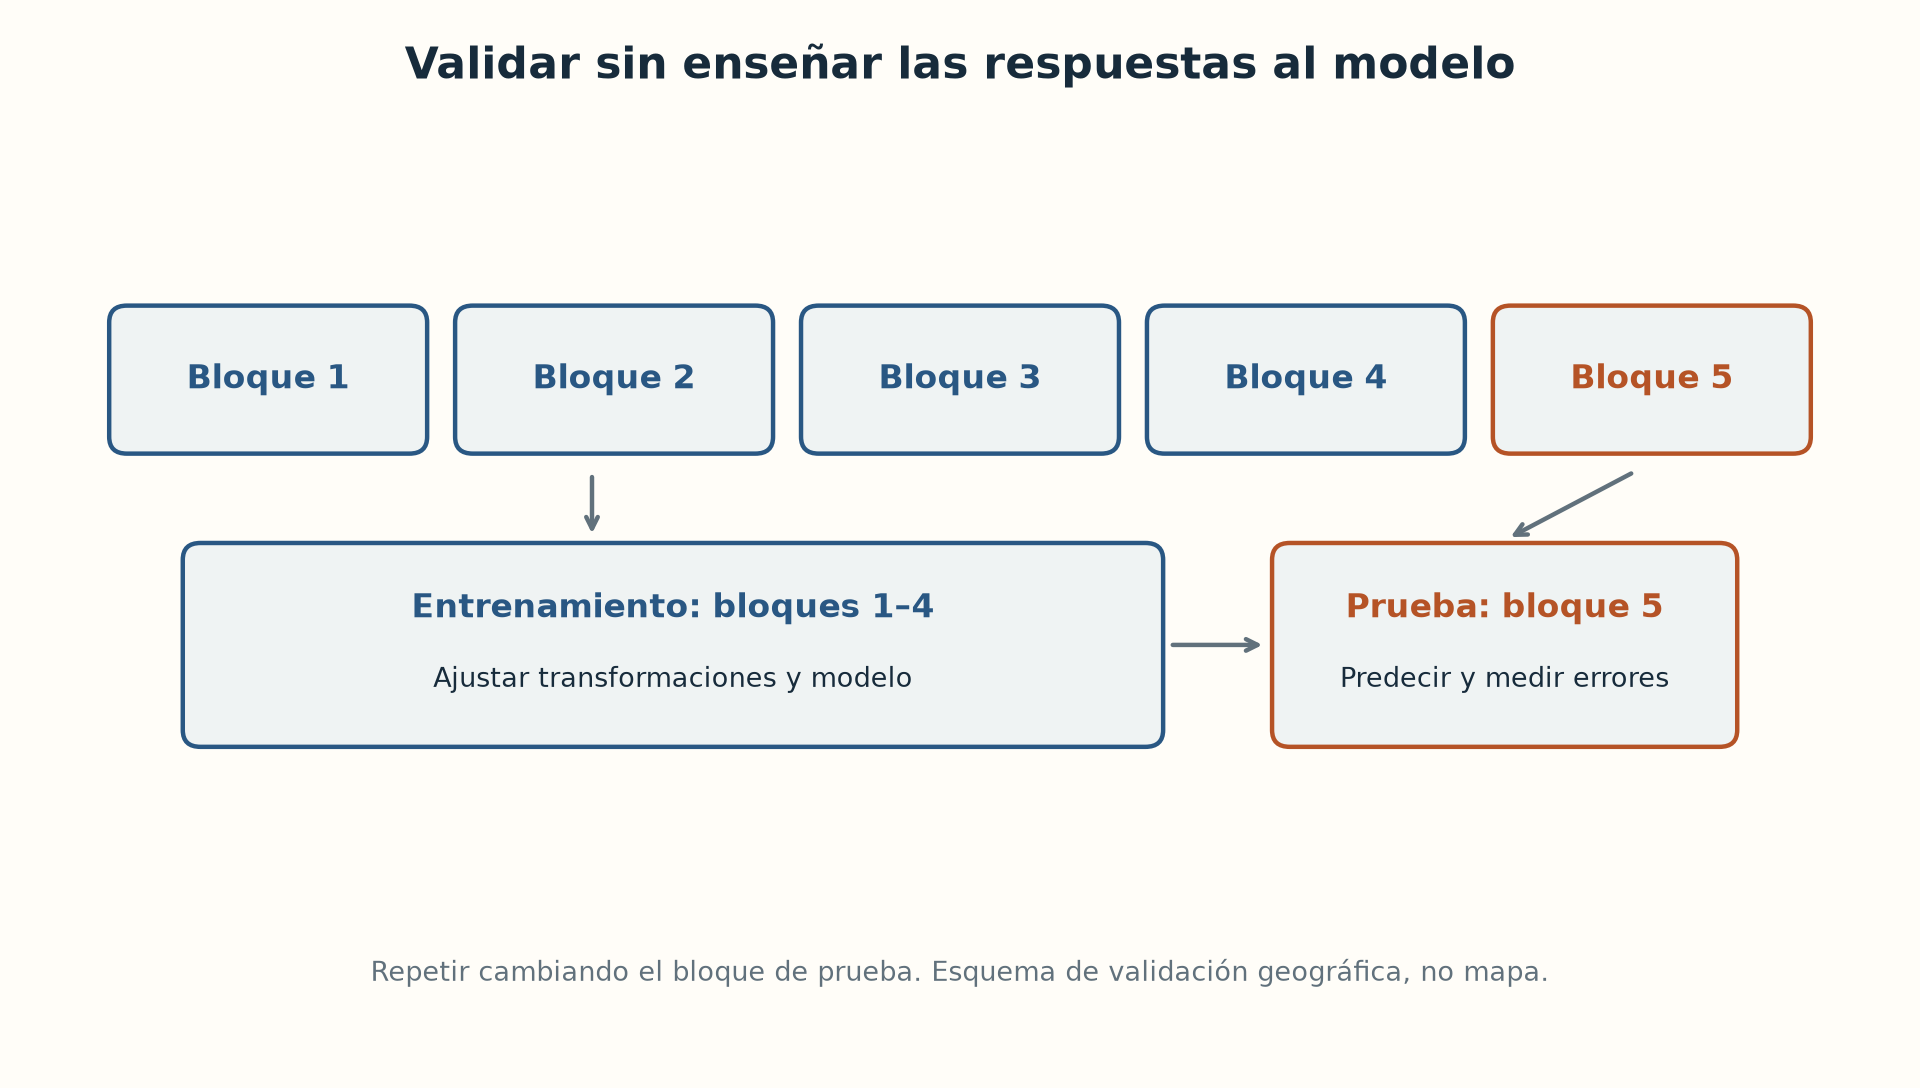
Municipios vecinos suelen parecerse. Separar filas al azar puede dejar ejemplos muy similares en entrenamiento y prueba. El proyecto usa cinco grupos de estados o deja una macrorregión fuera. Ajuste escalas y modelos únicamente con entrenamiento; calcule cada predicción de prueba con un modelo que no haya visto su bloque. Si quiere predecir el futuro, agregue también una separación temporal con atributos disponibles en la fecha de decisión.
from pathlib import Path
import pandas as pd
from alocacao_capacitada.ml.demand_model import cross_predict, evaluate_predictions

table = pd.read_csv(Path("results/estudo_integrado_20261001/dados_municipais.csv"))
predictions = cross_predict(table, scheme="uf")
print(evaluate_predictions(predictions).to_string(index=False))
Este comando ejecuta la familia del módulo demand_model; no reproduce exactamente la ablación del estudio integrado, que usa tres conjuntos de atributos y boosting con 150 iteraciones. Para esa ablación, consulte los CSV enlazados. Mantener 5564 municipios y las mismas particiones permite comparar atributos sin atribuir a un modelo la ventaja de haber recibido una muestra más fácil.
| Atributos | Desviación Poisson | MAE en pedidos | Previsto/observado |
|---|---|---|---|
| Solo población | 14.16 | 12.49 | 0.97 |
| Históricos seleccionados | 3.98 | 6.23 | 0.95 |
| Retrospectivos completos | 3.14 | 5.42 | 0.91 |
Interpretar algo más que el mejor error
MAE informa el error absoluto medio en pedidos. La desviación Poisson evalúa el ajuste de predicciones positivas a conteos; menor es mejor en la misma muestra. La razón previsto/observado muestra sesgo agregado: 0,91 indica subestimación total cercana al 9%, aunque el MAE sea menor. Analice residuos por estado y tamaño de municipio. Spearman alto indica buen orden relativo, no necesariamente cantidades bien calibradas.
La ablación completa usa información retrospectiva, incluida información posterior al periodo de pedidos. Su mejora no demuestra una previsión que habría sido posible entonces. Incluso el subconjunto histórico necesita comprobar fechas de publicación. Para decidir si merece usar el modelo, pase sus predicciones al optimizador y mida cambios de coste y servicio fuera de muestra: una mejora predictiva puede dejar casi intacta la ubicación elegida.
Fuentes y evidencias
Siguiente: Previsión poblacional: tendencias, amortiguación y prueba temporal