Previsión poblacional: tendencias, amortiguación y prueba temporal
Cómo proyectar población sin confundir revisión censal con crecimiento ni población futura con pedidos garantizados.

Serie: de los datos a la decisión logística
- De los pedidos a la red logística: un proyecto de optimización y aprendizaje automático
- MILP: convertir una decisión logística en un modelo verificable
- Relajación lineal: cuánto puede mejorar una solución
- Voraz y búsqueda local: construir rápido y mejorar con criterio
- LNS: reorganizar parte de la red para escapar del óptimo local
- Predecir demanda: de una referencia poblacional a Poisson y boosting
- Previsión poblacional: tendencias, amortiguación y prueba temporal
- K-means: descubrir perfiles municipales sin inventar categorías naturales
- Scoring de candidatos: aprender a filtrar sin perder buenas decisiones
- Escenarios y SAA: decidir antes de conocer la demanda
Proyectar con una referencia explícita
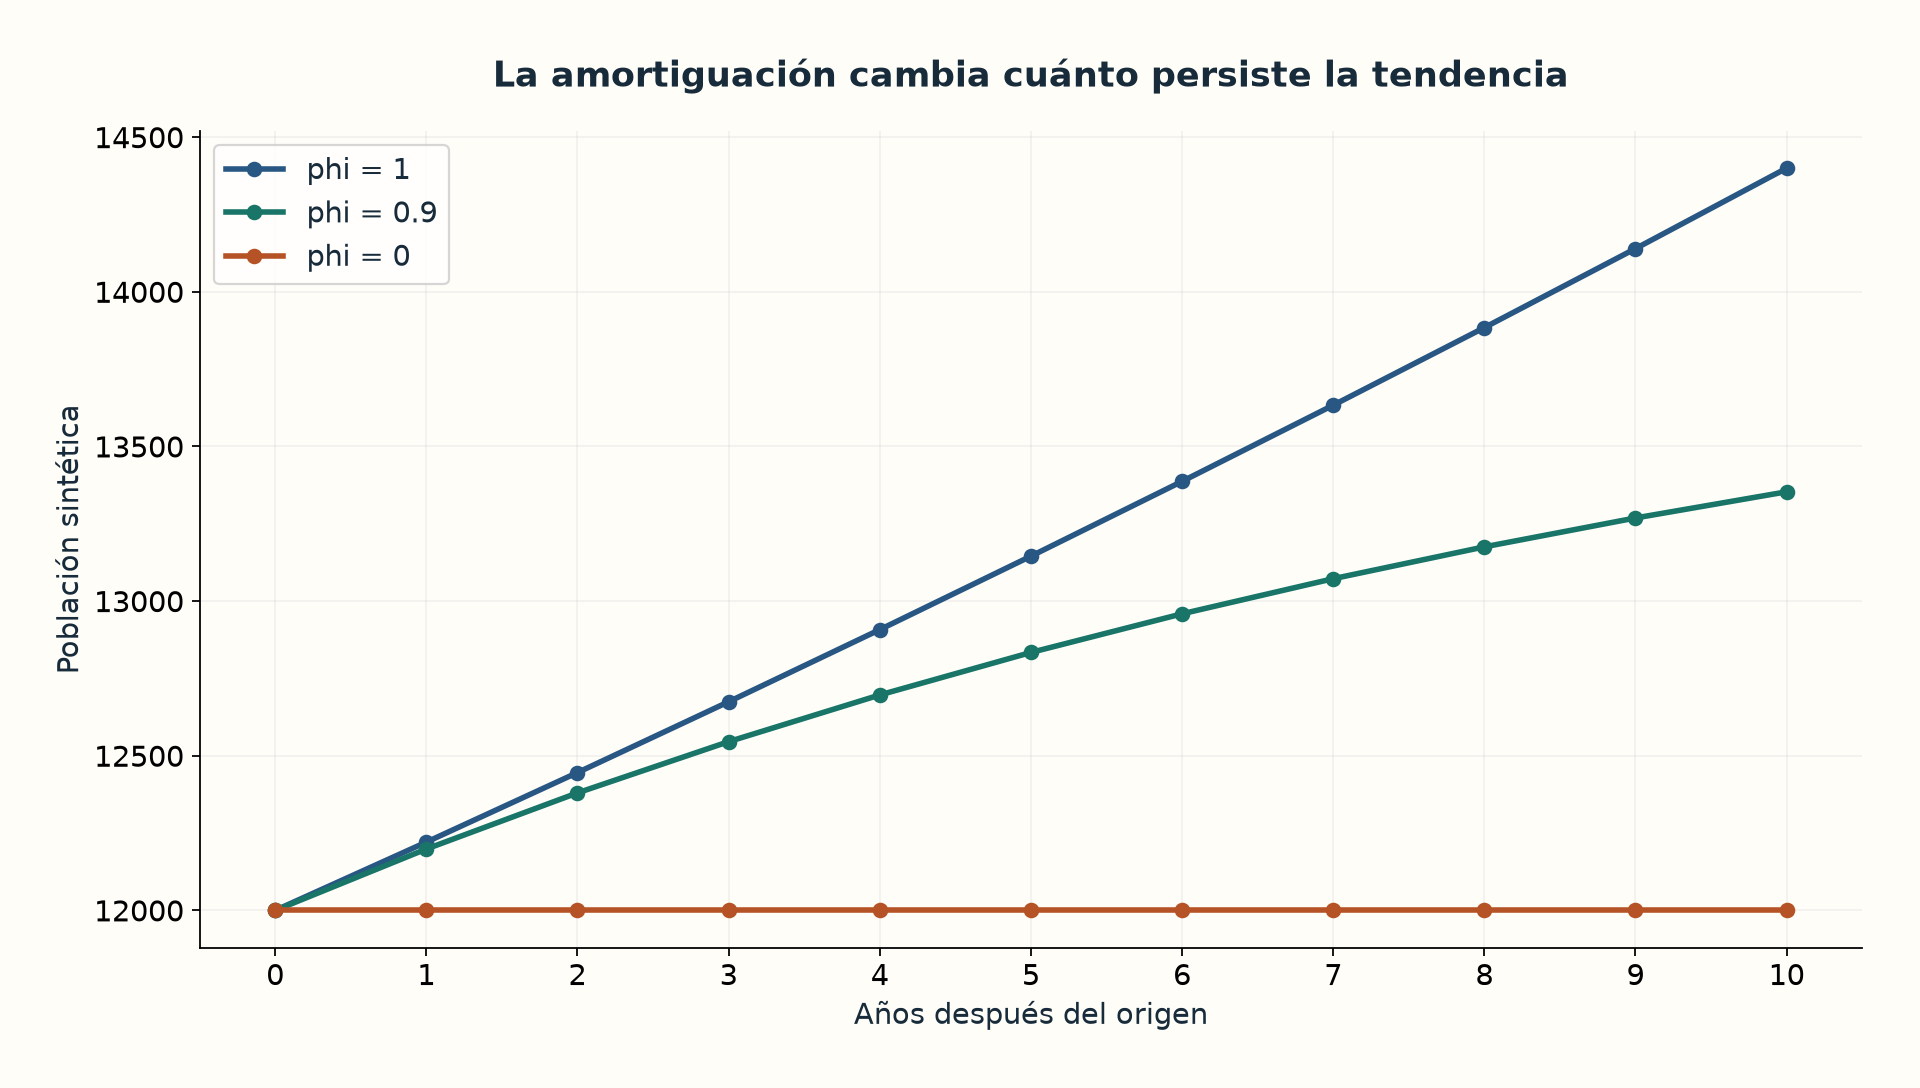
Una ciudad que creció rápidamente no mantiene necesariamente ese ritmo durante décadas. El proyecto combina su tasa reciente con la mediana de municipios del mismo estado y franja poblacional. El peso w determina cuánto confiar en la tendencia municipal; phi amortigua su persistencia. Funciona como escuchar la trayectoria individual junto con la experiencia de un grupo comparable, sin suponer que todos los municipios sean iguales.
g_local = (P_last / P_past)**(1 / window) - 1
g_effective = w*g_local + (1-w)*g_group
steps = sum(phi**k for k in range(1, horizon+1))
P_forecast = P_last * (1 + g_effective)**steps
Con w=1 se usa solo crecimiento local; con w=0, solo la referencia del grupo. Phi=1 mantiene la tasa a lo largo del horizonte; valores menores reducen su persistencia. El caso phi=0 mantiene el último nivel y sirve como referencia ingenua. Elegir parámetros requiere pruebas anteriores a la fecha evaluada, no escoger retrospectivamente el que mejor coincide con el año que se quiere predecir.
Ejecutar un ejemplo controlado
import pandas as pd
from alocacao_capacitada.ml.forecast import Config, predict

series = pd.DataFrame({2010: [10000., 20000.],
                       2020: [12000., 22000.]}, index=[1, 2])
uf = pd.Series(["SP", "SP"], index=series.index)
pred = predict(series, uf, origin=2020, horizon=5,
               config=Config(window=10, w=1.0, phi=1.0))
print(pred.round(1).to_dict())
Los datos de este ejemplo son sintéticos y deberían producir aproximadamente 13145,3 y 23073,8 habitantes. Sirven para comprobar la fórmula, no para describir municipios reales. Después cambie phi y observe cómo cambia la proyección manteniendo el nivel inicial. Para evaluar precisión necesita valores posteriores observados y múltiples orígenes temporales, comparando siempre horizontes equivalentes.
Qué observar en los datos y las métricas
Las estimaciones IBGE anteriores al Censo 2022 y las revisadas posteriormente pertenecen a series metodológicas distintas. El módulo separa esas etapas y marca años interpolados. Un salto entre versiones no debe interpretarse automáticamente como crecimiento real. También conviene preguntar si la interpolación utilizó un dato que todavía no existía en la fecha simulada: validación temporal exige reproducir la información disponible, no solo ordenar las columnas por año.
La revisión encontró que census_backtest calcula exp(|log(previsto/real)|)−1 bajo una etiqueta de APE. Si se prevén 80 y se observan 100, esa expresión produce 25%, mientras que el APE convencional |previsto−real|/real produce 20%. Ambas expresiones pueden estudiarse, pero no son intercambiables. Antes de citar porcentajes censales del repositorio, recalcule la métrica deseada a partir de las predicciones. No se modificó ese código durante la preparación de la serie.
Por último, población proyectada no equivale a demanda logística. Convertirla en pedidos requiere hipótesis adicionales de propensión, participación de mercado y frecuencia de compra. Evalúe esas hipótesis por escenarios y compruebe la red con capacidad fija. Una previsión más precisa solo justifica un modelo más complejo si mejora la decisión que realmente necesita tomar.
Fuentes y evidencias
Siguiente: K-means: descubrir perfiles municipales sin inventar categorías naturales