Scoring de candidatos: aprender a filtrar sin perder buenas decisiones
Regresión logística y boosting como filtros del optimizador: qué predicen y cómo evaluar el coste de excluir candidatos.

Serie: de los datos a la decisión logística
- De los pedidos a la red logística: un proyecto de optimización y aprendizaje automático
- MILP: convertir una decisión logística en un modelo verificable
- Relajación lineal: cuánto puede mejorar una solución
- Voraz y búsqueda local: construir rápido y mejorar con criterio
- LNS: reorganizar parte de la red para escapar del óptimo local
- Predecir demanda: de una referencia poblacional a Poisson y boosting
- Previsión poblacional: tendencias, amortiguación y prueba temporal
- K-means: descubrir perfiles municipales sin inventar categorías naturales
- Scoring de candidatos: aprender a filtrar sin perder buenas decisiones
- Escenarios y SAA: decidir antes de conocer la demanda
El filtro es una decisión con consecuencias
Con muchos candidatos, resolver la red completa puede ser costoso. El scoring aprende cuáles suelen recibir una instalación en soluciones anteriores y propone una lista reducida. Es una preselección para un examen más detallado: descartar al candidato adecuado en esta etapa impide que el optimizador lo recupere después. Por eso el objetivo no es solo clasificar bien, sino conservar buenas redes con menos esfuerzo computacional.
El rótulo abierto indica que un municipio recibió al menos un módulo en la solución utilizada para entrenar. No es una verdad geográfica universal: depende de costes, demanda, capacidades y calidad de esa solución. Las entradas incluyen demanda local y cercana, distancia ponderada, renta, alquiler y variables del escenario. Si las soluciones docentes son aproximadas, el clasificador también aprende sus limitaciones.
Dos familias y una validación común
La regresión logística transforma una combinación de atributos en un score entre cero y uno; el boosting combina árboles y admite interacciones más flexibles. El módulo deja una macrorregión fuera en cada ajuste y produce scores fuera de muestra. Ese número puede ordenar candidatos, pero no debe presentarse como probabilidad calibrada de éxito comercial sin una evaluación adicional.
Para utilizar el pipeline completo, prepare primero los datos territoriales, escenarios y soluciones que originan las etiquetas. Ejecute el comando siguiente en la raíz del repositorio, con una carpeta de salida nueva. Realiza experimentos de scoring; no es un ejemplo instantáneo ni funciona solo con los CSV resumidos de esta serie. Antes de la ejecución larga, consulte --help y confirme la disponibilidad de matrices y tablas de referencia.
python -m alocacao_capacitada.network.run_scoring --help
python -m alocacao_capacitada.network.run_scoring --iterations 100 --out results/scoring_tutorial_new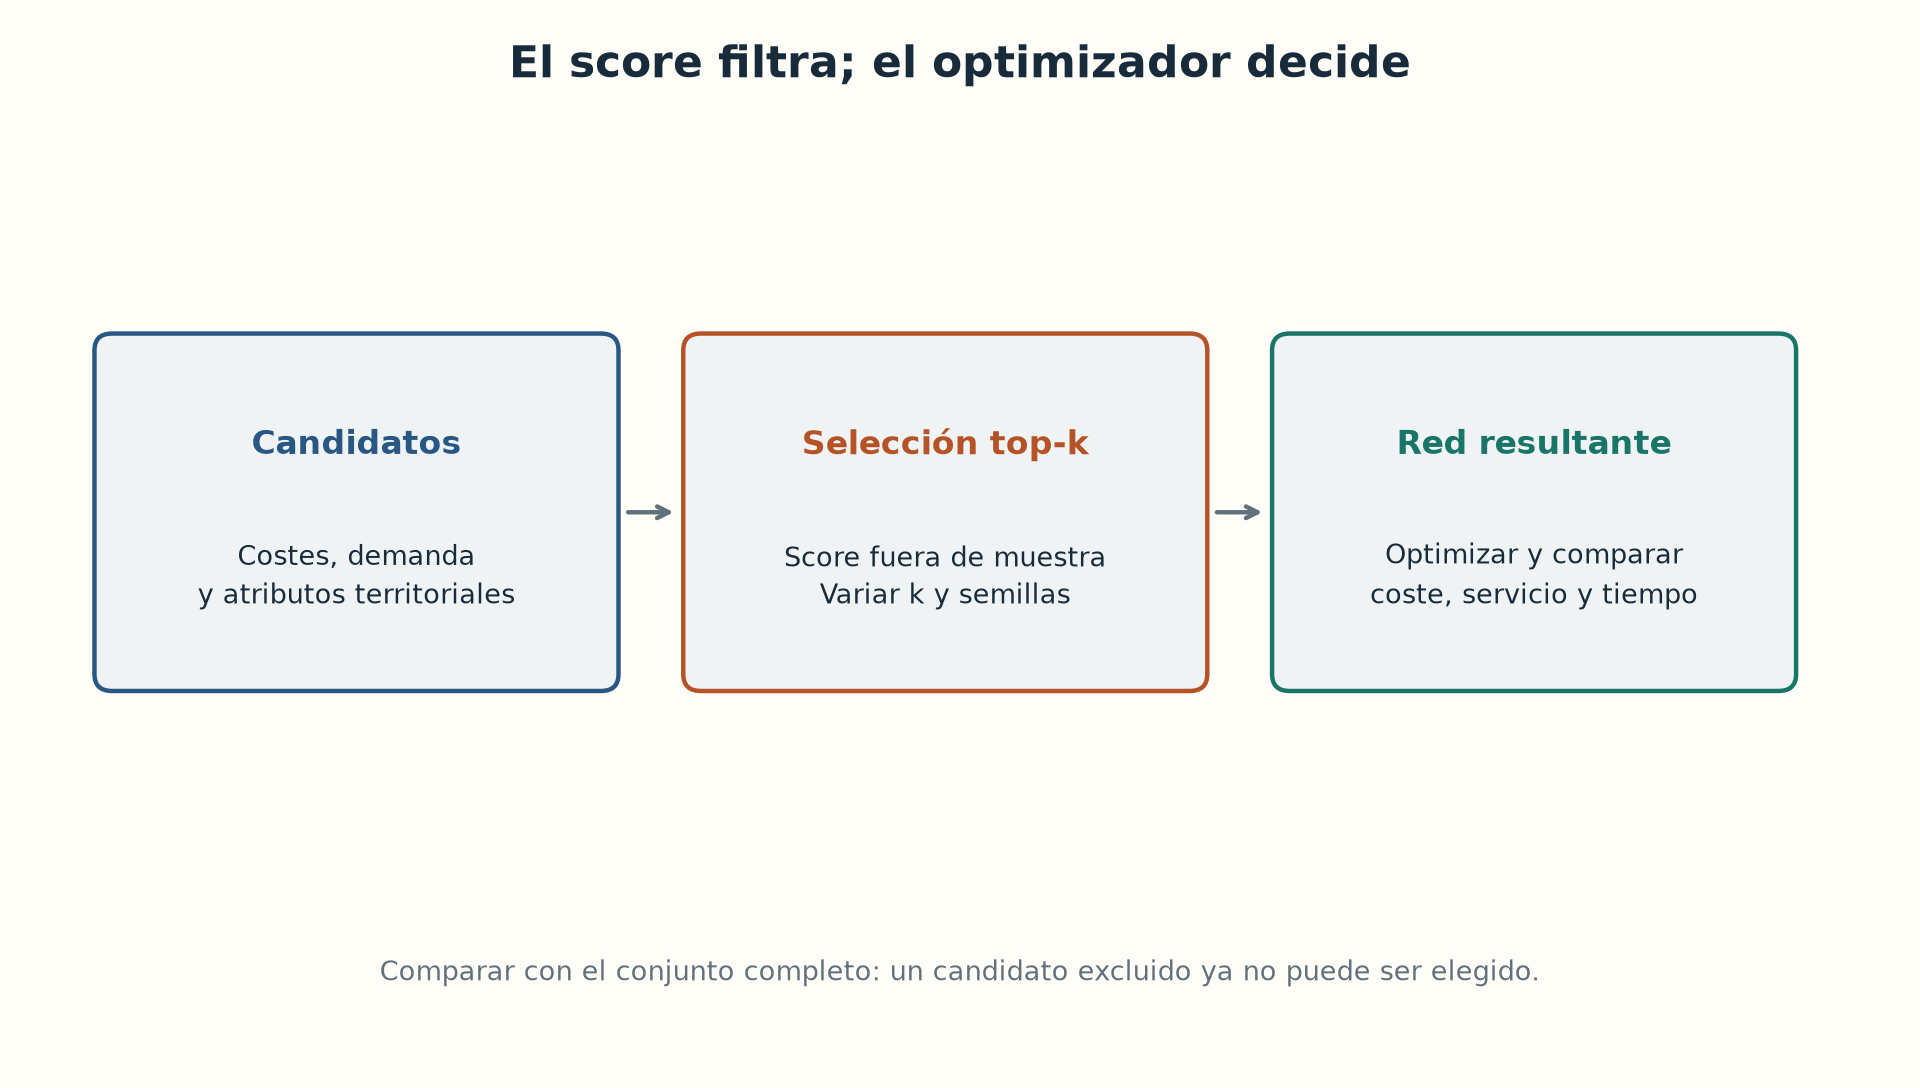
La métrica final es la decisión
AUC mide ordenación general y precision@k mide la proporción de positivos entre los k primeros. Ambas son útiles, pero excluir un único centro estratégico puede encarecer mucho la red aunque esas métricas sean altas. Resuelva la red con todos los candidatos y con el filtro bajo presupuestos comparables. Evalúe ambas sobre la misma demanda y matriz de transporte; compare coste, servicio, tiempo y límites disponibles.
excess_pct = 100 * (cost_filtered - cost_reference) / cost_referenceSi la referencia completa es heurística, llame al resultado exceso frente a la referencia, no distancia al óptimo. Un valor negativo puede ocurrir porque el problema reducido fue más fácil de resolver dentro del tiempo; no demuestra que eliminar alternativas mejore el óptimo matemático. Varíe k, repita semillas y compruebe capacidad territorial. Un filtro que acelera el cálculo pero impide atender regiones importantes no cumplió su función.
Fuentes y evidencias
Siguiente: Escenarios y SAA: decidir antes de conocer la demanda