Por que 10.000 chunks de 20 documentos não são 10.000 casos
Incerteza em RAG, parte 1: por que contar trechos não basta para saber quanta informação uma amostra de documentos traz.

Neste artigo
Imagine 20 documentos divididos em 10.000 chunks. Se a taxa é 18%, tratá-los como Bernoulli iid dá um erro-padrão próximo de 0,4 ponto e um intervalo de aproximadamente ±0,8 ponto. É um exemplo, não o tamanho da amostra TAESA. No caso real, o procedimento iid cobriu menos de um terço das repetições de amostras de 20 documentos.
A série anterior sobre esse caso mostrou o sintoma. Esta série de três artigos constrói a teoria que o explica e a põe à prova com os mesmos dados. Aqui respondo a uma pergunta: por que 10.000 chunks de 20 documentos não equivalem a 10.000 casos independentes. A segunda parte justifica qual unidade o bootstrap deve reamostrar. A terceira mostra como calcular a incerteza sem usar o chunk como réplica artificial.
Série anterior: 33.503 chunks não são 33.503 provas
A pergunta que define o erro-padrão
Um erro-padrão depende do estimador e do mecanismo de repetição do estudo. Não se deduz apenas do número de linhas. Aqui distingo dois mecanismos: voltar a amostrar chunks de documentos fixos ou selecionar outros documentos e observar todos os seus chunks. Meu experimento avalia o segundo.
Com documentos fixos, reamostrar chunks dentro de cada um descreve outra fonte de variação. Mesmo ali é preciso distinguir probabilidades diferentes e dependência local: não basta aplicar uma única fórmula binomial. No meu experimento, todos os chunks do documento selecionado são observados; a incerteza que estudo vem de selecionar documentos.
De onde vem o acaso
No experimento ANEEL–TAESA, o índice de busca é fixo e o resultado de cada chunk foi calculado uma única vez. Dado o índice, o resultado de um chunk não tem nada de aleatório: se a consulta for repetida, sai o mesmo. Quando um documento entra na amostra, entram todos os seus chunks, de modo que dentro do documento não há amostragem, há censo. O único passo aleatório de todo o procedimento é o sorteio de quais documentos são avaliados.
Isso tem uma consequência que soa paradoxal. Para os 20 documentos sorteados, a taxa de acerto é conhecida sem erro: todos os seus chunks já foram medidos. Para o acervo, a incerteza depende só de quanto os documentos variam entre si. A fórmula binomial não acerta em nenhum dos dois casos: atribui uma incerteza pequena a uma quantidade que não tem incerteza e a empresta a outra cuja incerteza é muito maior.
A mesma ideia como modelo
A leitura anterior é a da amostragem de populações finitas, que corresponde exatamente ao desenho validado. Se se preferir um modelo, a intuição é a mesma. Suponha que o resultado do chunk c do documento d se componha de um nível geral μ, de um efeito próprio do documento b_d e de um ruído do chunk e_dc:
y_dc = μ + b_d + e_dc        Var(b_d) = σ_b²      Var(e_dc) = σ_e²

Var(ȳ) = σ_b² / K  +  σ_e² / (K · m)
Essa fórmula supõe documentos independentes, tamanhos iguais, efeitos com variância constante e resíduos independentes entre si e dos efeitos documentais. Sob esse modelo, aumentar m reduz o segundo termo e deixa σ_b²/K. É uma ilustração; mudar a segmentação de textos fixos não equivale a obter novos resíduos desse modelo.
A correlação intraclasse, ρ = σ_b² / (σ_b² + σ_e²), mede que parte da variação total pertence ao documento. Dela saem o efeito de desenho de Kish (1965) e o tamanho efetivo:
DEFF = 1 + (m − 1) · ρ

n_eff = K · m / DEFF   →   K / ρ     (m → ∞)

DEFF_Kish = 1 + ((1 + CV²) · m̄ − 1) · ρ      CV = sd(m) / m̄
No modelo ilustrativo, com tamanhos iguais e ρ fixo, o equivalente tende a K/ρ: com K=20 e ρ=0,293, cerca de 68. Isso não é um limite universal para este corpus. Mudar o corte muda consultas, resultados e possivelmente a correlação. Com tamanhos desiguais, o DEFF baseado em ICC e CV é um diagnóstico aproximado, não um substituto da variância do desenho.
O que os dados mostraram
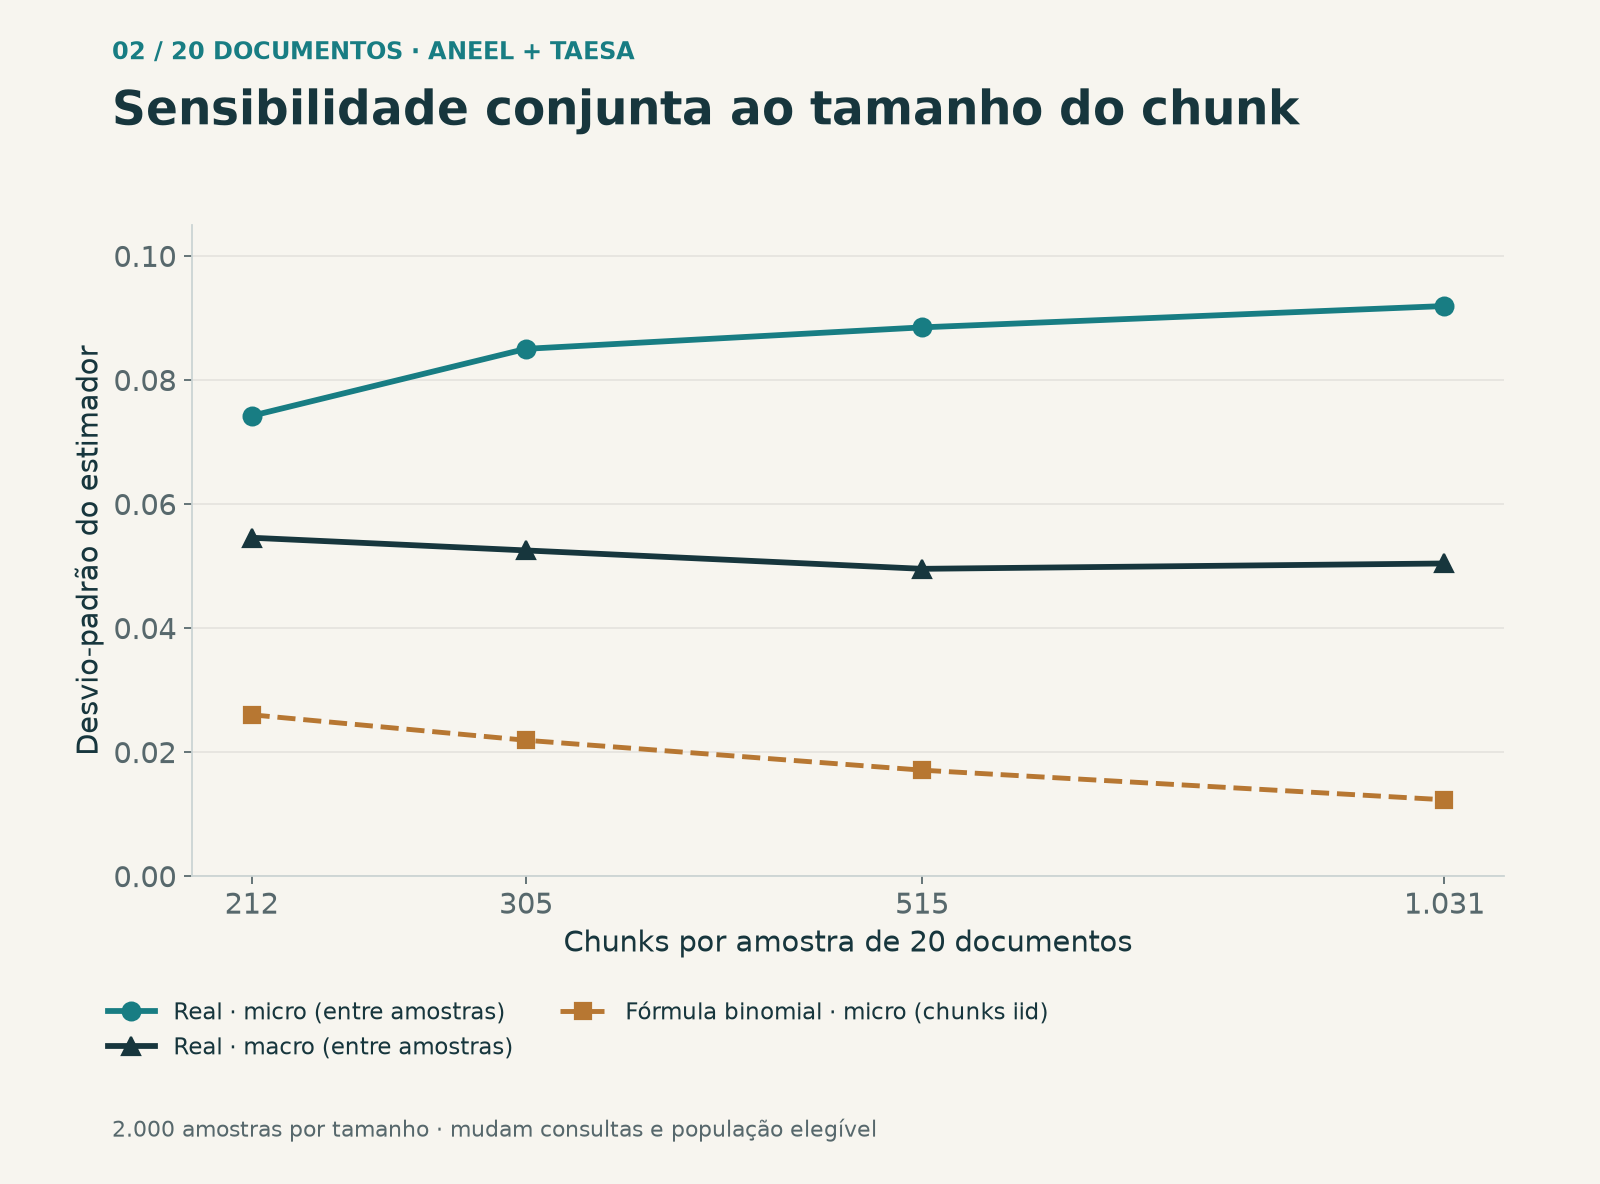
Em uma etapa adicional, sorteei 2.000 amostras de 20 documentos sobre os resultados já calculados. Com chunks de 100 palavras, o DP micro foi 0,0885; a linearização prevê 0,0915. Na macro, foram 0,0496 e 0,0497. Frente à referência binomial de 0,0171, a razão de variâncias é 26,8 usando o resultado empírico e 28,7 usando a linearização. São quantidades próximas, mas distintas.
Como referência de precisão, podemos dividir p(1−p) pela variância estimada. Com cerca de 515 chunks por amostra, o equivalente Bernoulli micro é 19,2 usando a variância empírica e 18,0 usando a linearização; o macro empírico fica perto de 54,5. Não são documentos adicionais nem uma contagem de casos independentes.
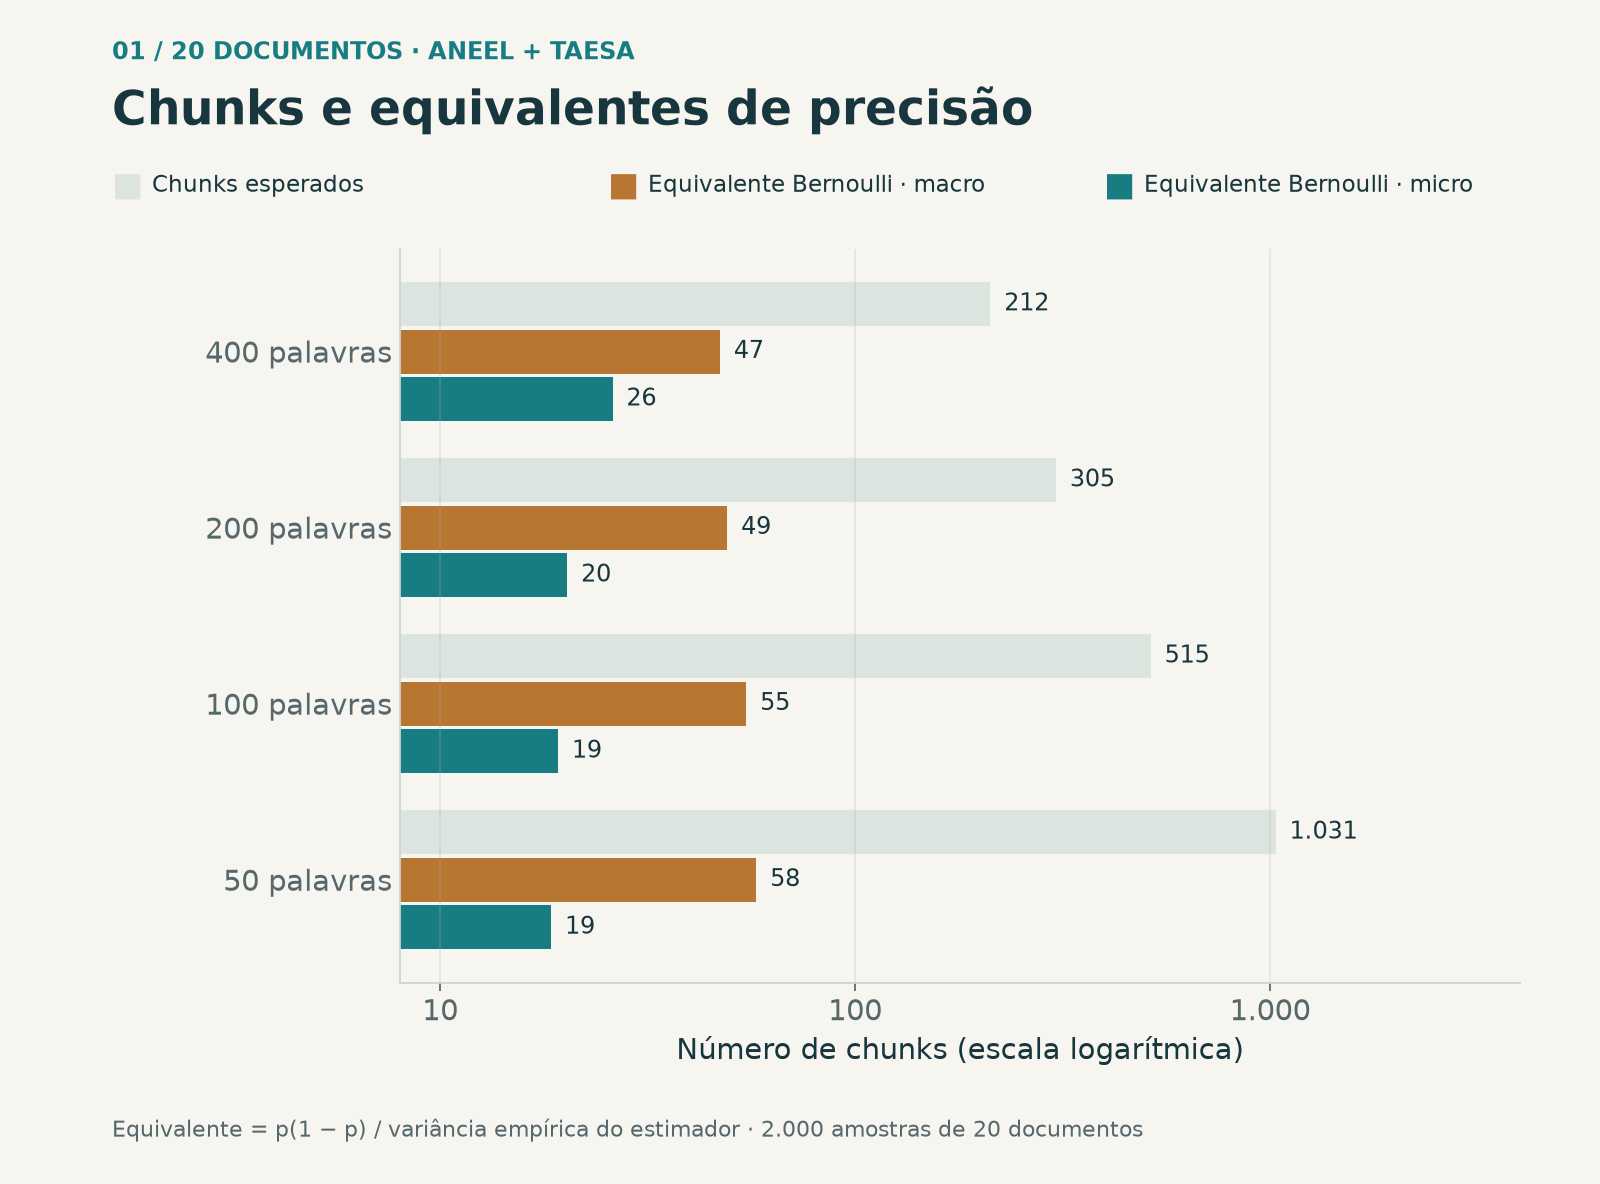
Com 50 e 100 palavras, permanecem os mesmos 1.300 documentos elegíveis, mas mudam as consultas e são sorteadas novas amostras. Os chunks esperados passam de 515 para 1.031; o DP micro empírico passa de 0,0885 para 0,0919 e o macro, de 0,0496 para 0,0504. A referência binomial diminui. Isso mostra o comportamento dessas configurações, não que toda resegmentação conserve exatamente a informação.
Na primeira versão, subtraí um componente binomial da variação entre taxas e o interpretei como um piso de incerteza. Retirei essa interpretação: ela exige independência condicional dentro do documento, que não validei. Para este desenho, basta trabalhar com as taxas documentais observadas e sua variação sob o sorteio; não é preciso atribuir a elas um ruído interno hipotético.
Por que os chunks de um documento se parecem
Os chunks de uma resolução compartilham vocabulário e estrutura, e uma versão semelhante de outro ano pode competir na busca. São mecanismos plausíveis. A ICC de 0,293 resume heterogeneidade sob o modelo usado, mas não identifica, sozinha, qual desses mecanismos causou cada erro. Essa atribuição exige examinar consultas e resultados recuperados.
Há dependência também em escala menor: descontada a média do documento, os chunks vizinhos ainda têm uma autocorrelação de 0,17. E há em escala maior: o tipo de documento explica 12,6% da variação das taxas. Isso não invalida o raciocínio. No enfoque de amostragem, o que torna a inferência válida é o sorteio de documentos, não uma suposta independência entre eles. Se os documentos foram sorteados ao acaso, a semelhança entre duas versões de uma mesma demonstração faz parte da variação entre documentos que o método precisa reproduzir.
O que este argumento não diz
- Os chunks continuam úteis para medir o resultado de cada documento. Mas recortar um texto fixo não equivale a obter novos ensaios independentes nem permite separar automaticamente ruído e dificuldade documental.
- A fórmula binomial é apropriada sob ensaios Bernoulli iid. O controle simulado sem heterogeneidade atendia a essas condições e obteve cobertura próxima de 95%. Uma ICC estimada em zero, sozinha, não demonstra independência nem descarta dependência local.
- Não cobre todas as fontes de incerteza. Com o índice fixo, a análise mede a variação devida ao sorteio de documentos. Mudar a composição do corpus, o recuperador ou o tipo de pergunta são outras repetições, com outras variâncias.
- Não é uma medida da qualidade final do RAG. O hit@1 aqui é um proxy de atribuição. O raciocínio se estende a médias de escores sob um desenho e agrupamento especificados; não automaticamente a qualquer métrica ou pergunta.
Em resumo
A conclusão é concreta: neste desenho, 10.000 chunks vindos de 20 documentos não são 10.000 unidades de amostragem. Os documentos são selecionados e seus chunks são observados por inteiro. Na TAESA, a amostra de K=20 tem cerca de 515 chunks em média e um equivalente micro de precisão próximo de 19,2 sob a referência empírica usada. O bootstrap precisa respeitar esse desenho, sem prometer uma calibração que os dados não sustentam.
Parte 2: qual unidade o bootstrap deve reamostrar
Procedência e referências
Dados: resultados por chunk do estudo ANEEL–TAESA (1.300 documentos, 33.503 chunks de 100 palavras, BM25, hit@1), já apresentados na série anterior. Os números novos vêm de etapa4_teoria.py, que não recalcula a recuperação: sorteia 2.000 amostras de 20 documentos sobre os resultados já calculados. Os agregados das figuras e os hashes das fontes estão no arquivo JSON.
Baixar os agregados e os hashes das fontes (JSON)
- Kish, L. (1965). Survey Sampling. Wiley.
- Cochran, W. G. (1977). Sampling Techniques (3rd ed.). Wiley.
- Miller, E. (2024). Adding Error Bars to Evals: A Statistical Approach to Language Model Evaluations. arXiv:2411.00640.
Revisão metodológica · 11 de outubro de 2026
Os experimentos são de minha autoria, Jean M. Estevez Alvarez. Esta revisão distingue os resultados originais das verificações posteriores: preserva os desfechos e coberturas originais, corrige as quantidades derivadas e acrescenta 5.000 repetições do desenho de dois estágios. Não houve nova recuperação, treinamento ou avaliação em produção.
Resultados da revisão do desenho (JSON)
Field e Welsh (2007): modelos e limites do bootstrap agrupado