Calcular a incerteza sem réplicas artificiais: um procedimento por documento
Incerteza em RAG, parte 3: mostro o cálculo por documento, com fórmulas e código, e como o uso para comparar sistemas e planejar a amostra.

Neste artigo
Neste estudo, a seleção de documentos gera a incerteza amostral. Esta parte explica o cálculo para médias de resultados agrupados: hit@k, MRR ou outros escores por consulta, desde que o desenho e o agrupamento permitam. Não é uma receita automática para métricas não aditivas, perguntas multidocumentais ou juízes aleatórios.
Parte 1: por que 10.000 chunks não são 10.000 casos
Parte 2: qual unidade o bootstrap deve reamostrar
Passo 1: uma linha por documento
Para as médias e os métodos agrupados deste estudo, bastam n_d, o número de resultados observados, e s_d, sua soma. Essas colunas permitem recalcular micro, macro e suas aproximações de variância. Não substituem os registros detalhados para auditar rankings, dependência local ou erros temporais. Métricas não aditivas e perguntas multidocumentais exigem outra especificação.
Se a métrica não é binária, guarda-se também a soma dos quadrados. Se a comparação é entre dois sistemas sobre as mesmas consultas, s_d passa a ser a soma das diferenças por consulta dentro do documento.
Passo 2: declarar o estimando
Com tamanhos desiguais há duas médias distintas, e cada uma responde a uma pergunta. A micro-média, R = Σ s_d / Σ n_d, é a taxa de um chunk sorteado ao acaso: que fração dos trechos do acervo o sistema atribui bem. A macro-média, r̄, a média das taxas s_d / n_d, é a taxa esperada num documento típico. No acervo ANEEL–TAESA, valem 0,1846 e 0,1596. Não é uma escolha técnica; precisa ser decidida antes de calcular e escrita no relatório.
Se a pergunta permitir, a macro-média é mais fácil de estimar: com 20 documentos, a raiz do seu erro quadrático médio foi 0,050, contra 0,089 da micro-média, que depende muito de alguns poucos documentos grandes.
Passo 3: o erro-padrão vem dos documentos
A macro-média é uma média de K números, um por documento, e seu erro-padrão é o de qualquer média. A micro-média é um quociente, e seu erro-padrão sai da linearização clássica do estimador de razão: cada documento contribui com um resíduo u_d = s_d − R·n_d, que mede quanto o seu total se afasta do que daria a taxa global. Nas fórmulas, se(·) é o erro-padrão e ν, os graus de liberdade.
macro   r_d = s_d / n_d      r̄ = (1/K) · Σ r_d
        se(r̄) = sd(r_d) / √K                       ν = K − 1

micro   N = Σ n_d            R = Σ s_d / N        u_d = s_d − R · n_d
  CR1   se(R) = √( K/(K−1) · Σ u_d² ) / N          ν = K − 1
  CR2   se(R) = √( Σ u_d² / (1 − n_d/N) ) / N      ν = Imbens–Kolesár

95%     θ̂ ± t(0.975; ν) · se(θ̂)
O CR1 aplica a correção K/(K−1). O CR2 ajusta os resíduos sob um modelo de trabalho; aqui se usa o de independência. Os graus de liberdade aproximados de Imbens–Kolesár refletem o desequilíbrio de pesos. Com tamanhos iguais, coincidem; na macro, coincidem com o t sobre taxas. São aproximações: esses ajustes não garantem cobertura nominal com poucos documentos.
Nenhum passo usa o número de chunks como tamanho de amostra. n_d entra só como peso do documento. Essa é a diferença em relação à fórmula binomial, em que N aparece no denominador como se cada chunk fosse um caso.
Passo 4: o intervalo, com os graus de liberdade à vista
Os graus de liberdade descrevem a aproximação do intervalo, não um número literal de documentos independentes. Com 20 documentos e 764 chunks, o CR2 obteve ν=3,76 e um intervalo micro de [−0,023; 0,308]. O Wald iid deu [0,118; 0,167], que não continha o alvo de 0,185. Informo K e ν separadamente: são intervalos nominais cuja cobertura precisa ser avaliada.
O código reproduz as fórmulas determinísticas. Seu bootstrap usa 9.999 réplicas e semente 1; o original usou 999 e outra sequência. Os limites podem diferir por Monte Carlo. Primeiro é preciso selecionar os documentos da amostra: o censo completo já tem uma taxa conhecida.
import numpy as np
from scipy import stats

# df: one row per chunk (or query), columns doc_id and hit (0/1 or any score)
g = df.groupby("doc_id")["hit"].agg(n="size", s="sum")
n, s = g["n"].to_numpy(float), g["s"].to_numpy(float)
K, N = len(n), n.sum()
if K < 2 or np.any(n <= 0) or not np.isfinite(s).all():
    raise ValueError("Need at least two valid documents")

# micro: ratio estimator, CR2 with Imbens-Kolesar degrees of freedom
R = s.sum() / N
u = s - R * n
h = n / N
se_micro = np.sqrt(np.sum(u**2 / (1 - h))) / N
a = 1 / np.sqrt(1 - h)
M = -np.outer(a * n, a * n) / N
M[np.diag_indices(K)] += a**2 * n
df_micro = np.trace(M)**2 / np.sum(M * M)
ci_micro = R + np.array([-1, 1]) * stats.t.ppf(0.975, df_micro) * se_micro

# macro: mean of per-document rates, t with K - 1 degrees of freedom
r = s / n
se_macro = r.std(ddof=1) / np.sqrt(K)
ci_macro = r.mean() + np.array([-1, 1]) * stats.t.ppf(0.975, K - 1) * se_macro

# document bootstrap-t (macro): resample documents, studentise each replicate
rng = np.random.default_rng(1)
rb = r[rng.integers(0, K, (9999, K))]
sd = rb.std(1, ddof=1)
degenerate_fraction = np.mean(sd == 0)
if not np.any(sd > 0):
    raise ValueError("All bootstrap replicates have zero SE; interval unavailable")
tb = (rb.mean(1)[sd > 0] - r.mean()) / (sd[sd > 0] / np.sqrt(K))
lo, hi = np.quantile(tb, [0.025, 0.975])
ci_boot_t = (r.mean() - hi * se_macro, r.mean() - lo * se_macro)
Para a micro-média, o bootstrap-t segue a mesma lógica: em cada réplica sorteiam-se documentos, recalcula-se o quociente e divide-se pelo CR1 da própria réplica. As réplicas em que todos os documentos têm a mesma taxa não têm erro-padrão e são descartadas.
Passo 5: escolher o método conforme a situação
Não há um método que domine em todos os casos. As coberturas do estudo, com intervalos nominais de 95%, sugerem um guia:
| Situação | Aproximação avaliada | Limite ou cuidado |
|---|---|---|
| Macro-média, 20 documentos ou mais | t com K − 1 gl sobre as taxas (93,0%) | Wald iid e bootstrap de chunks (59,7%) |
| Micro-média, tamanhos desiguais | CR2 com gl de Imbens–Kolesár (85,7%) ou bootstrap-t (88,4%) | CR1 (77,1%) e Wald iid (29,5%) |
| Cinco documentos | CR2 (86,6% micro), avisando que o nominal não está garantido | Bootstrap-t (71,1%) e percentil (75,0%) |
| Taxa perto de 0 ou de 1 | Intervalo em escala logit (não avaliado aqui) | Logit não garante cobertura; tratar 0 e 1 |
| Foram sorteados tipos e depois documentos | Aproximação por tipo; revisão de dois estágios: t 91,42% | O comparador original de estratos não isolou um único erro |
Logit mantém os limites no domínio quando a transformação está definida, mas exige tratar estimativas em zero ou um e não garante cobertura. Não o avaliei aqui. Intersectar um intervalo com [0,1] preserva a cobertura para uma proporção e também não a melhora. Convém informar zeros, uns e réplicas degeneradas, sem escondê-los atrás de uma transformação.
Comparar dois sistemas: diferenças por documento
Comparo os recuperadores nas mesmas consultas e agrego as diferenças por documento. O pareamento aproveita a variação compartilhada e pode reduzir a variância: Var(A−B)=Var(A)+Var(B)−2Cov(A,B). Não elimina interações entre sistema e documento nem muda, sozinho, a unidade amostral.
No acervo ANEEL–TAESA, a vantagem do BM25 sobre o TF-IDF foi de 0,62 ponto na micro-média e de 0,27 na macro-média, com empate exato em 70% dos documentos. Com diferenças tão pequenas, discretas e cheias de zeros, os bootstraps por documento cobriram entre 85% e 89%. O CR2 da micro-média (95,7%) e o t da macro-média (97,4%) foram os únicos que chegaram ao nominal ou o superaram. Antes de anunciar que um sistema é melhor, vale a pena verificar o método numa simulação com os próprios dados, como fez este estudo.
Planejar: precisão se compra com documentos
Para planejar com M=1.300 documentos, usei t × S/√K × √(1−K/M). A aproximação dá 76 documentos para uma semiamplitude de 0,05 na macro e 220 na micro; sem correção finita, 80 e 264. Não garante cobertura nem usa graus de liberdade CR2 específicos. Também é preciso verificar assimetria e influência documental.
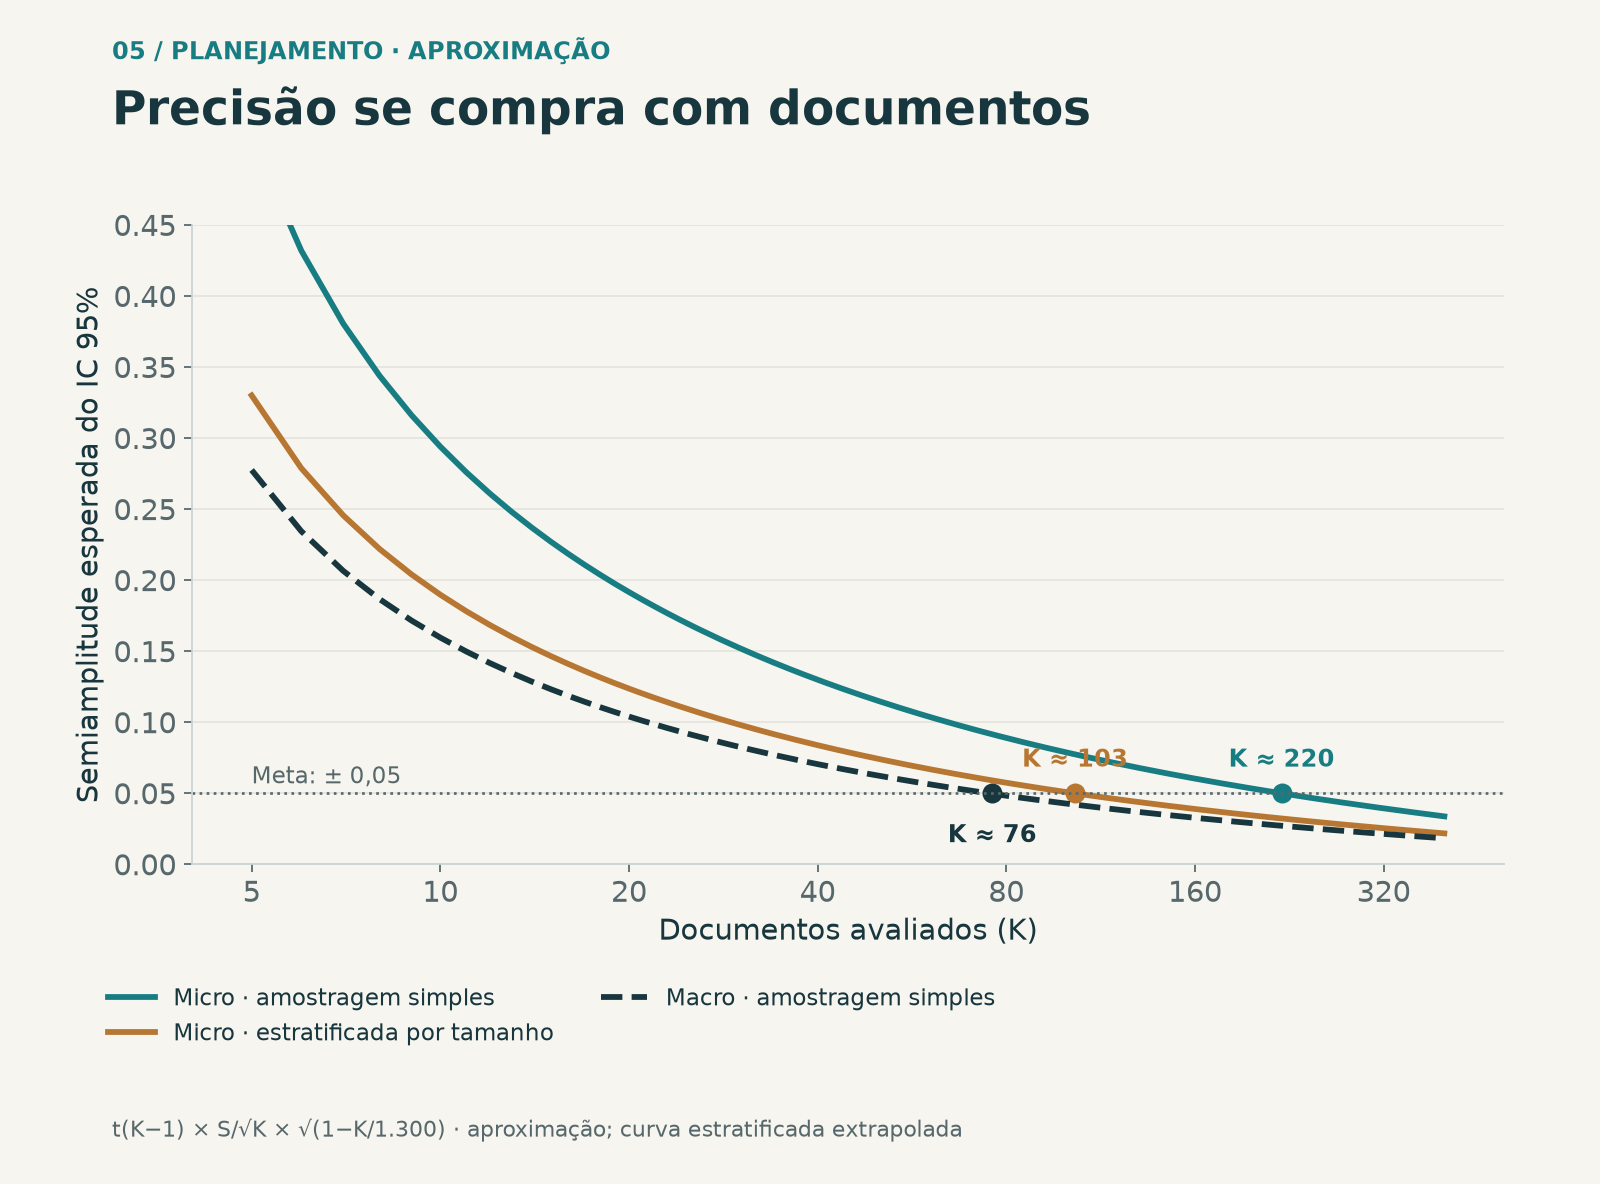
A micro-média é cara porque alguns poucos documentos grandes decidem o resultado. O remédio é de desenho, não de cálculo: estratificar o sorteio por tamanho. Testei separar os 129 documentos com mais de 76 chunks, que concentram 59% de todos os chunks, e sortear 10 entre eles e 10 entre os demais, com o estimador de razão combinado e seu erro-padrão estratificado. Coerente com a parte 2, os estratos são fixos e os documentos são sorteados dentro de cada um.
O desvio-padrão da micro-média caiu de 0,092 para 0,059, e a largura média do intervalo, de 0,39 com CR2 para 0,22. A cobertura subiu para 88,6%, ainda abaixo de 95%: dentro do estrato de documentos pequenos continua havendo muita assimetria. Estratificar não substitui ter mais documentos, mas faz cada documento render mais.
O que informar
- A população e o desenho: o que foi sorteado, em quais níveis e com que fração.
- O estimando, micro ou macro, e por que ele responde à pergunta.
- K, N e a distribuição do número de chunks por documento.
- O método de intervalo, a unidade de reamostragem e os graus de liberdade efetivos.
- A correlação intraclasse e o efeito de desenho, como diagnóstico e não como substituto do cálculo.
- A fração de documentos com taxa zero ou um e a distribuição das taxas por documento.
- O que fica de fora: o índice fixo, o recuperador e a população de perguntas.
Sobre o diagnóstico: o tamanho efetivo N/DEFF ajuda a explicar o problema, mas usá-lo como se fossem N/DEFF casos independentes é outra aproximação frágil. No estudo, esse «Wald com n efetivo» cobriu 89% com 20 documentos e caiu para 74% com cinco.
Fechamento da série
Começo pelo desenho: o que foi selecionado, qual é a população e qual média responde à pergunta. Aqui, agrego por documento e preservo esse agrupamento na inferência. Outros desenhos exigem pesos, estratos, estágios ou perguntas que dependem de vários documentos. Os 10.000 chunks de 20 documentos ilustram a diferença entre medições e unidades amostrais; essas contagens não determinam, sozinhas, o erro-padrão.
Procedência e referências
Coberturas dos métodos e comparação pareada: estudo ANEEL–TAESA, com 5.000 repetições para K = 20 e 2.000 nas sensibilidades. Estratificação por tamanho e planejamento: etapa4_teoria.py, com 2.000 amostras. A curva estratificada da figura extrapola o desvio-padrão observado com K = 20 e é apenas indicativa.
Baixar os agregados e os hashes das fontes (JSON)
- Bell, R. M., & McCaffrey, D. F. (2002). Bias reduction in standard errors for linear regression with multi-stage samples. Survey Methodology, 28(2), 169–181.
- Imbens, G. W., & Kolesár, M. (2016). Robust standard errors in small samples: some practical advice. The Review of Economics and Statistics, 98(4), 701–712.
- Pustejovsky, J. E., & Tipton, E. (2018). Small-sample methods for cluster-robust variance estimation and hypothesis testing in fixed effects models. Journal of Business & Economic Statistics, 36(4), 672–683.
- Cochran, W. G. (1977). Sampling Techniques (3rd ed.). Wiley.
- Miller, E. (2024). Adding Error Bars to Evals: A Statistical Approach to Language Model Evaluations. arXiv:2411.00640.
Revisão metodológica · 11 de outubro de 2026
Os experimentos são de minha autoria, Jean M. Estevez Alvarez. Esta revisão distingue os resultados originais das verificações posteriores: preserva os desfechos e coberturas originais, corrige as quantidades derivadas e acrescenta 5.000 repetições do desenho de dois estágios. Não houve nova recuperação, treinamento ou avaliação em produção.
Os métodos da tabela são aproximações avaliadas, não uma receita calibrada: os 93,0% do t macro continuam abaixo dos 95% nominais. O bootstrap-t original descarta réplicas com erro-padrão zero e devolve intervalo pontual se todas degeneram; essa política faz parte dos resultados históricos e não demonstra certeza. Na revisão de dois estágios, a variância corrigida funciona em média, mas o intervalo t ainda cobre 91,42%.
As fórmulas CR1 e macro apresentadas sem correção finita são aproximações apropriadas quando a fração selecionada é pequena. Para AAS sem reposição, a variância macro inclui (1−K/M); a micro admite essa correção em sua linearização. Não aplico uma única correção global a desenhos de vários estágios. As referências originais fundamentam os métodos sob suas condições, não validam, por si sós, este corpus.
Resultados da revisão do desenho (JSON)
Field e Welsh (2007): modelos e limites do bootstrap agrupado