O que reamostrar: a unidade do bootstrap em avaliações por chunks
Incerteza em RAG, parte 2: comparo seis formas de reamostrar os dados da ANEEL e da TAESA e explico como escolher a unidade do bootstrap.

Neste artigo
O bootstrap tem fama de método que não precisa de suposições: reamostra-se, recalcula-se e os quantis dão o intervalo. No caso ANEEL–TAESA, o bootstrap de chunks conteve o valor real em 25% das repetições, pior ainda que a fórmula binomial. Não falhou por falta de réplicas. Falhou porque reamostrou a unidade errada, e nenhuma quantidade de réplicas corrige isso.
Na primeira parte vimos que, numa avaliação por chunks, o acaso vem do sorteio de documentos. Aqui tiro a consequência para o bootstrap: o que ele precisa reamostrar, o que cada alternativa capta e o que muda quando, acima do documento, há outro nível sorteado.
Parte 1: por que 10.000 chunks não são 10.000 casos
O bootstrap imita um sorteio
O bootstrap empírico de Efron (1979) usa a amostra para aproximar a distribuição do estimador. Na versão iid, seleciona com reposição o mesmo número de unidades. Aqui, o sorteio original é sem reposição: o bootstrap documental simples o aproxima, não o copia exatamente. Quando a fração amostral importa, é preciso incorporar o desenho finito.
A decisão central é qual variação a reamostragem deve representar. Aqui, seleciono documentos e observo todos os seus chunks. Por isso, o bootstrap documental se aproxima da fonte de incerteza de interesse. Em outros desenhos, é preciso preservar pesos, estratos e estágios; não basta escolher automaticamente o nível mais alto nem supor independência entre seleções sem reposição.
Na avaliação por chunks, essa unidade é o documento. Cada réplica sorteia K identificadores de documento com reposição, leva todos os resultados de cada documento sorteado e recalcula o mesmo estimador. Um documento que sai duas vezes conta duas vezes. Dentro do documento nada é mexido, porque dentro do documento não houve sorteio.
O que cada esquema capta
Antes de olhar os dados, a teoria já diz o que esperar de cada alternativa.
- Chunks dentro do documento. Cada documento conserva seu tamanho e sorteiam-se chunks dentro dele. A variância das réplicas é, em média, Σ n_d·p_d·(1 − p_d) / N²: só o ruído interno. A diferença entre documentos, que é a fonte real de variação, não aparece.
- Blocos vizinhos. Minha implementação reamostra blocos disjuntos dentro de cada documento. Mantém fixos os documentos, não suas médias: as médias reamostradas mudam. Com um único bloco por documento, desaparece a variação interna. Isso não avalia todas as variantes para séries estacionárias de Künsch (1989).
- Documentos em um nível. Cada réplica conserva todos os resultados do documento escolhido. É uma aproximação pertinente para amostragem documental com fração pequena. Os resultados de consistência de Field e Welsh (2007) dependem do modelo e do regime assintótico; não garantem calibração com vinte documentos.
- Documentos e depois chunks. Esse segundo sorteio acrescenta variabilidade interna que não pertence ao desenho avaliado, no qual cada documento selecionado é observado por inteiro. Aumentar a variância bootstrap não garante superar a variância real nem obter cobertura conservadora. Field e Welsh (2007) distinguem essas questões sob modelos e regimes assintóticos explícitos.
- Selvagem por documento. Em vez de sortear documentos, multiplica o resíduo de cada documento por um peso aleatório de média zero. É a referência em econometria para poucos clusters (Cameron, Gelbach e Miller, 2008), mas com tamanhos muito desiguais pode funcionar mal (MacKinnon e Webb, 2017).
Seis esquemas postos à prova
Para verificar, sorteei 2.000 amostras de 20 documentos do acervo ANEEL–TAESA, apliquei os seis esquemas com 999 réplicas cada um e comparei a variância média das réplicas com a variância real do estimador entre amostras. Se um esquema imita bem o sorteio, a razão deve ficar perto de 100%.
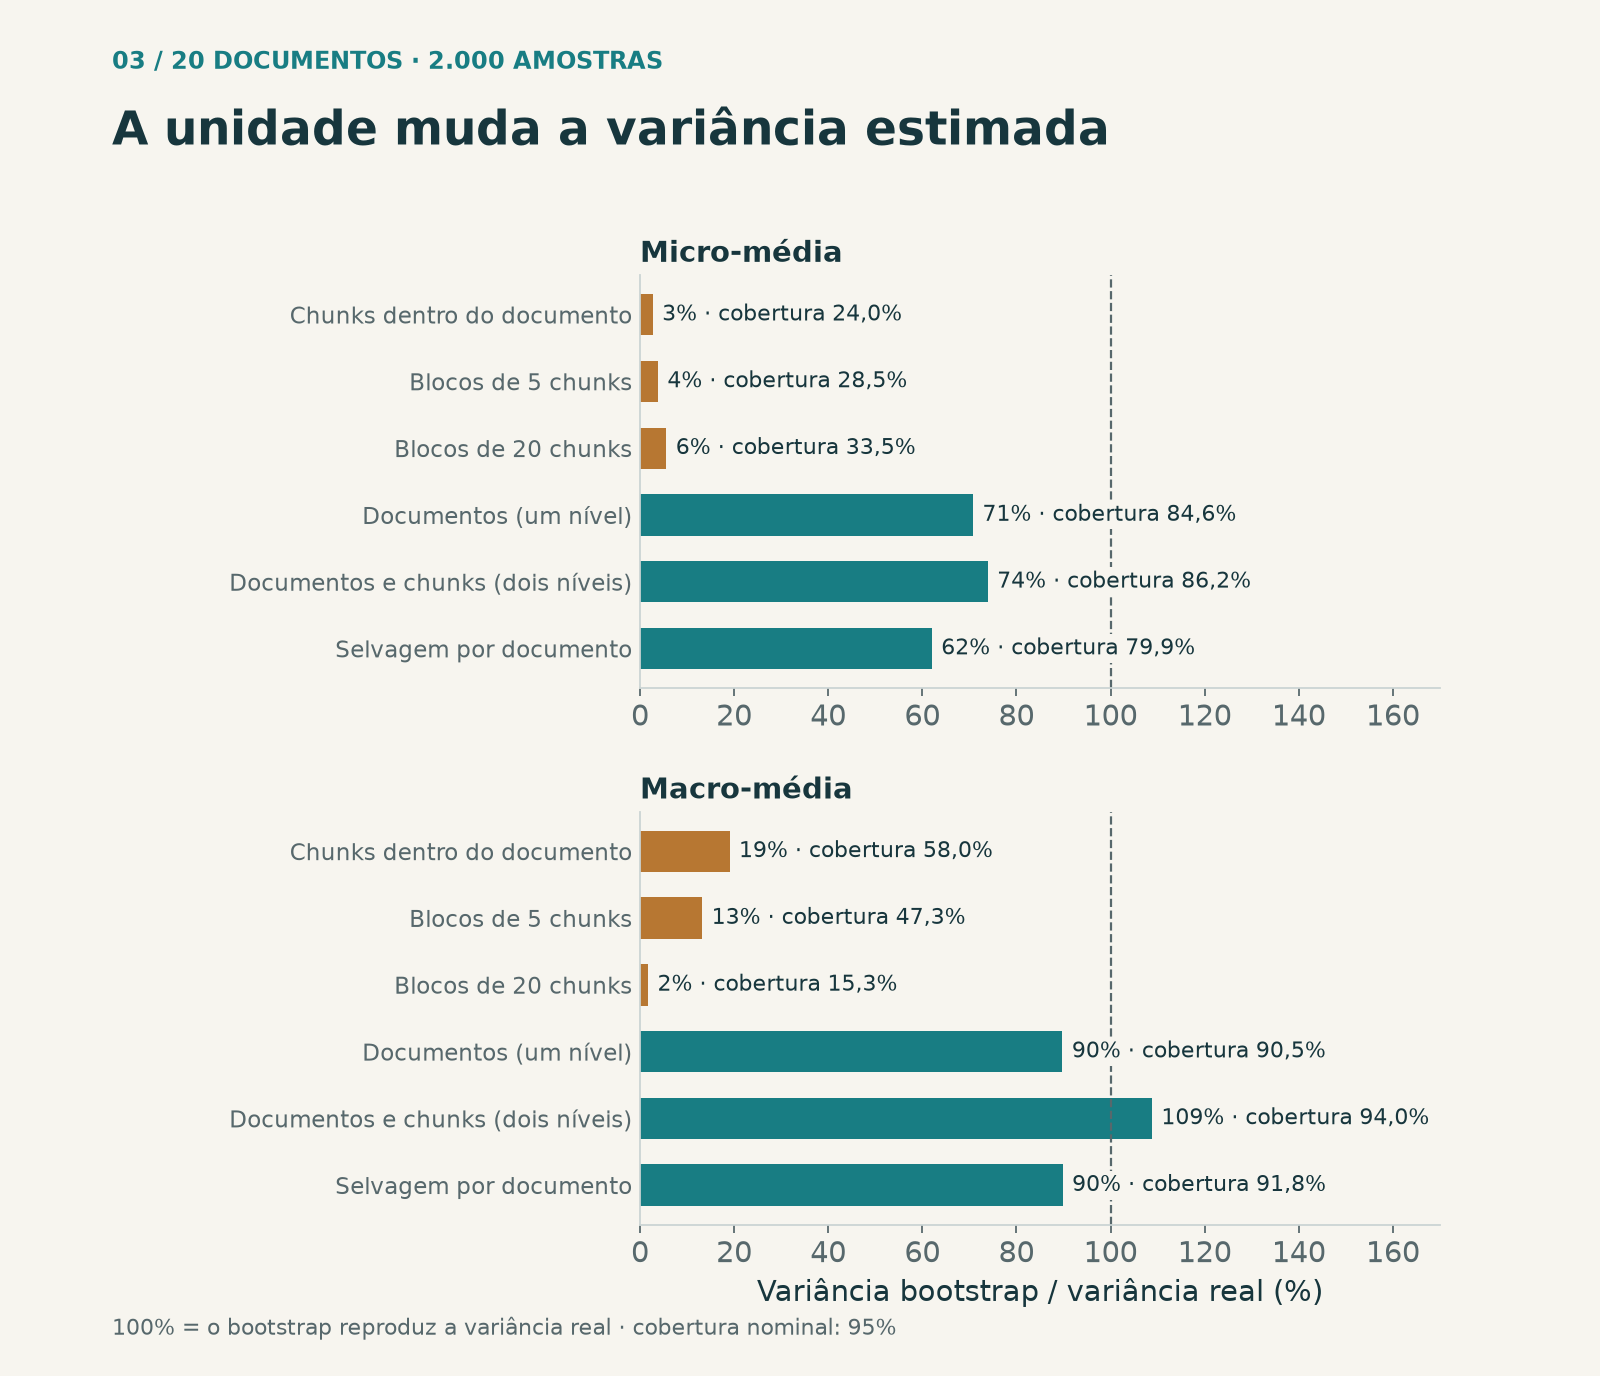
Os três esquemas que reamostram dentro do documento captaram entre 3% e 6% da variância real da micro-média e não passaram de 34% de cobertura. Os blocos confirmam a teoria: passar de blocos de 5 para blocos de 20 chunks quase não muda nada na micro-média e piora a macro-média, que cai para 15% de cobertura porque muitos documentos curtos ficam com um único bloco. Respeitar a dependência local não basta quando o problema está no nível do documento.
Os esquemas que atuam sobre documentos estimaram entre 62% e 109% da variância empírica. Com dois níveis, a razão foi 0,739 na micro e 1,088 na macro, com coberturas de 86,25% e 93,95%. Acrescentar um nível não garante um intervalo conservador. A variante wild não restrita que implementei foi pior que o bootstrap documental nesses cenários; isso não descarta outras variantes.
Por que até o esquema correto fica aquém
O bootstrap documental estimou cerca de 71% da variância empírica micro. A concentração de peso torna a razão sensível à amostra, mas não demonstra o mecanismo de cada falha. Corrigi uma explicação anterior: com 129 documentos de mais de 76 chunks entre 1.300, a probabilidade de não selecionar nenhum em uma amostra de 20 é 12,17%, não a maioria. Um subconjunto de documentos grandes e fáceis exigiria definição e cálculo próprios.
Por isso, com poucos documentos, além da unidade importa o método de intervalo. O percentil herda a assimetria da amostra. O bootstrap-t, que divide cada réplica pelo seu próprio erro-padrão, corrige parte dela: no estudo original, levou a micro-média de 85,4% para 88,4% e a macro-média de 91,5% para 97,2%, ao custo de intervalos mais largos. Com cinco documentos, nenhum dos dois é confiável. A unidade correta é condição necessária, não suficiente.
Quando há um nível acima do documento
A regra do sorteio diz mais do que «use o documento». Diz: use o que foi sorteado. O estudo original testou isso com um desenho em dois estágios. Primeiro sorteiam-se 6 dos 21 tipos de documento com pelo menos oito exemplares (resoluções autorizativas, despachos, informes trimestrais, ratings...) e depois 4 documentos dentro de cada tipo. A pergunta passa a ser a média entre tipos.
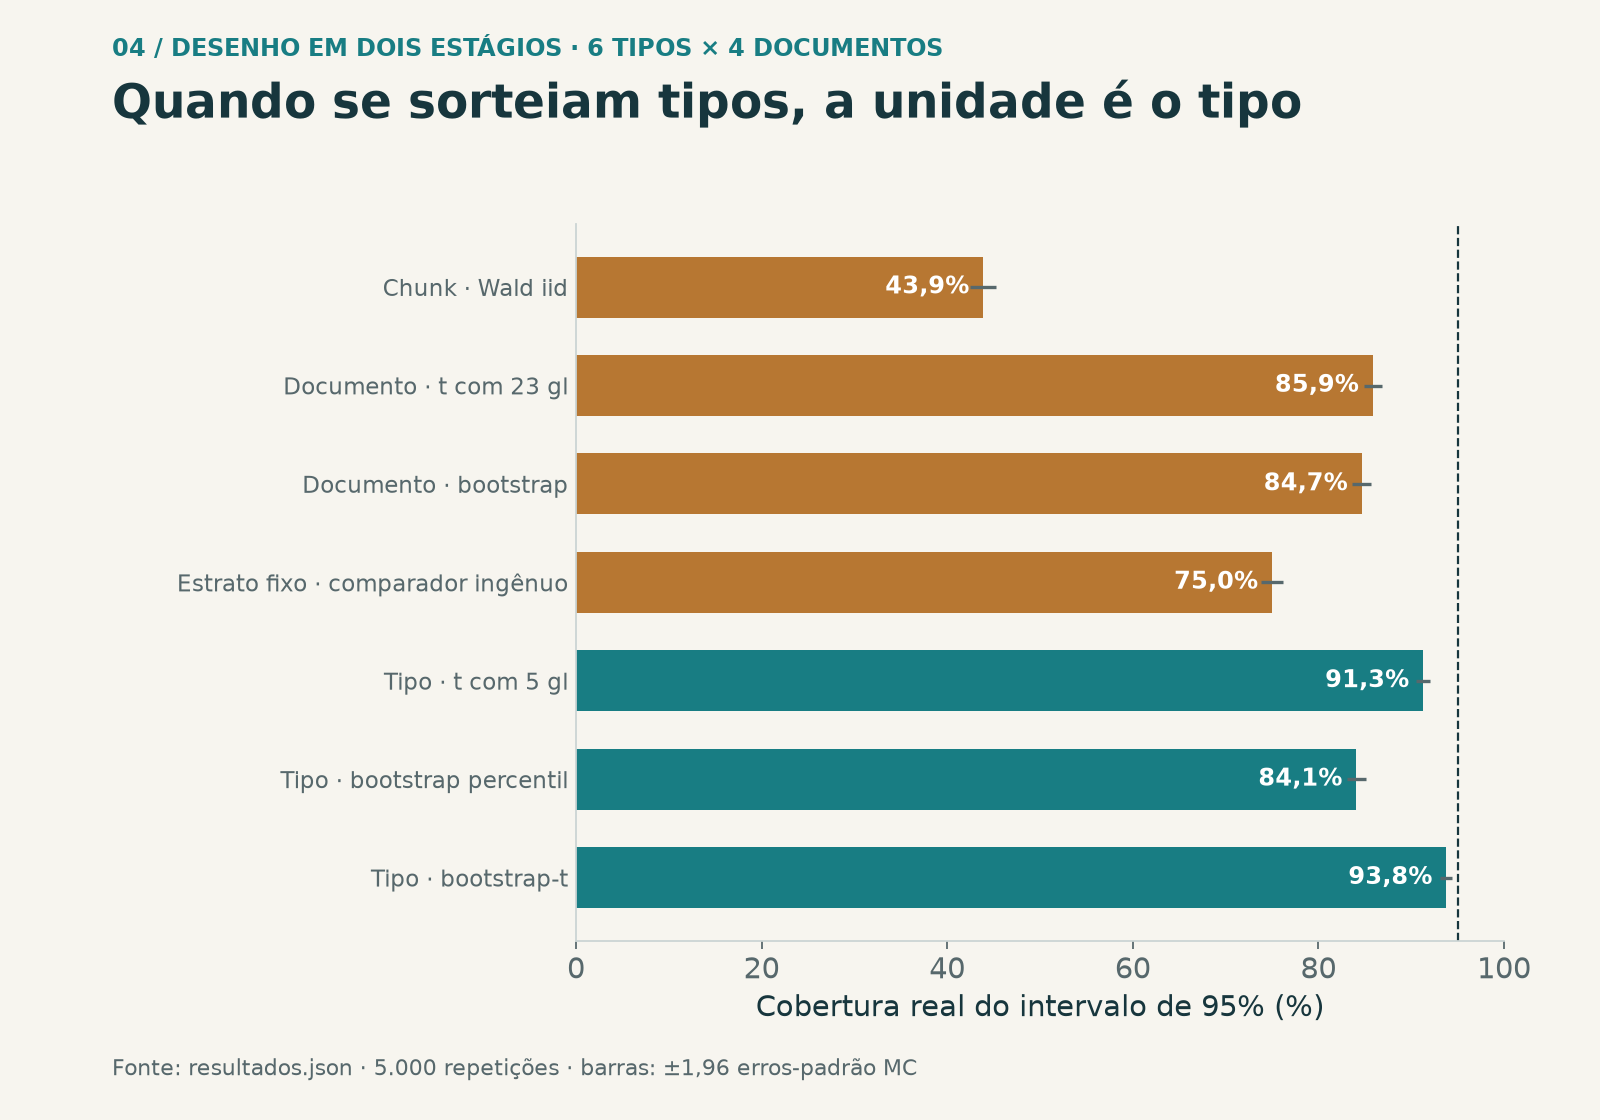
Os métodos documentais originais cobriram cerca de 85–86%. O comparador de “estratos fixos” cobriu 75%, mas também usava divisor k e quantis normais com quatro documentos por tipo: não isolava um único erro. Na revisão, separei o alvo condicional dos seis tipos escolhidos e corrigi a variância; a cobertura foi 93,76% para esse alvo, diferente da média de todos os tipos. Esses percentuais não respondem à mesma pergunta.
O bootstrap simples de tipos é uma aproximação de conglomerado último, não uma reprodução exata de dois estágios sem reposição. Importam tanto a fração de 6 entre 21 tipos quanto o sorteio interno. Na revisão, incluí uma variância com os dois estágios e suas correções finitas, verificada por enumeração em uma população pequena. Em 5.000 novas repetições, o intervalo t cobriu 91,42%: melhorar a variância não garante calibrar os quantis. A unidade, os pesos e os estágios precisam responder ao desenho.
E se os documentos não foram sorteados
Muitas avaliações usam os documentos que estavam à mão. Então não existe um sorteio a imitar, e o bootstrap perde sua justificativa de desenho. Continua sendo possível usá-lo, mas apoiado num modelo: a suposição de que os documentos avaliados são intercambiáveis com aqueles sobre os quais se quer concluir. Nesse caso, quem define a unidade é o objetivo da generalização. Se a conclusão é sobre outros documentos do mesmo tipo, a unidade é o documento; se é sobre outros tipos, é o tipo.
Essa suposição precisa ficar escrita no relatório. Nenhuma reamostragem corrige uma seleção enviesada: se os 20 documentos foram escolhidos porque eram os mais limpos, as réplicas vão reproduzir fielmente a incerteza de uma amostra de documentos limpos.
Quatro perguntas antes de reamostrar
- O que foi sorteado, e em que ordem? A resposta define a unidade do bootstrap.
- Sobre qual população se quer concluir? Se não houve sorteio, é ela que define a unidade.
- Quantas unidades há? Com poucas, comparar aproximações e declarar cobertura e graus de liberdade; bootstrap-t e CR2 também não garantem o nominal.
- Que fração da população foi sorteada nesse nível? Se for grande, corrija para população finita.
A terceira parte transforma tudo isso num procedimento de cálculo, com fórmulas, código e uma forma de planejar quantos documentos avaliar.
Parte 3: calcular a incerteza sem réplicas artificiais
Procedência e referências
Os números dos seis esquemas vêm de etapa4_teoria.py: 2.000 amostras de 20 documentos e 999 réplicas por esquema; o bootstrap selvagem usa pesos de Webb e é estudentizado com CR1. Os do desenho em dois estágios e os do bootstrap-t vêm do estudo original, com 5.000 repetições. Não houve nova execução da recuperação.
Baixar os agregados e os hashes das fontes (JSON)
- Efron, B. (1979). Bootstrap methods: another look at the jackknife. The Annals of Statistics, 7(1), 1–26.
- Künsch, H. R. (1989). The jackknife and the bootstrap for general stationary observations. The Annals of Statistics, 17(3), 1217–1241.
- Davison, A. C., & Hinkley, D. V. (1997). Bootstrap Methods and their Application. Cambridge University Press.
- Field, C. A., & Welsh, A. H. (2007). Bootstrapping clustered data. Journal of the Royal Statistical Society: Series B, 69(3), 369–390.
- Cameron, A. C., Gelbach, J. B., & Miller, D. L. (2008). Bootstrap-based improvements for inference with clustered errors. The Review of Economics and Statistics, 90(3), 414–427.
- MacKinnon, J. G., & Webb, M. D. (2017). Wild bootstrap inference for wildly different cluster sizes. Journal of Applied Econometrics, 32(2), 233–254.
- Rao, J. N. K., & Wu, C. F. J. (1988). Resampling inference with complex survey data. Journal of the American Statistical Association, 83(401), 231–241.
Revisão metodológica · 11 de outubro de 2026
Os experimentos são de minha autoria, Jean M. Estevez Alvarez. Esta revisão distingue os resultados originais das verificações posteriores: preserva os desfechos e coberturas originais, corrige as quantidades derivadas e acrescenta 5.000 repetições do desenho de dois estágios. Não houve nova recuperação, treinamento ou avaliação em produção.
Os métodos da tabela são aproximações avaliadas, não uma receita calibrada: os 93,0% do t macro continuam abaixo dos 95% nominais. O bootstrap-t original descarta réplicas com erro-padrão zero e devolve intervalo pontual se todas degeneram; essa política faz parte dos resultados históricos e não demonstra certeza. Na revisão de dois estágios, a variância corrigida funciona em média, mas o intervalo t ainda cobre 91,42%.
As fórmulas CR1 e macro apresentadas sem correção finita são aproximações apropriadas quando a fração selecionada é pequena. Para AAS sem reposição, a variância macro inclui (1−K/M); a micro admite essa correção em sua linearização. Não aplico uma única correção global a desenhos de vários estágios. As referências originais fundamentam os métodos sob suas condições, não validam, por si sós, este corpus.
Resultados da revisão do desenho (JSON)
Field e Welsh (2007): modelos e limites do bootstrap agrupado