Qué remuestrear: la unidad del bootstrap en evaluaciones por fragmentos
Incertidumbre en RAG, parte 2: comparo seis formas de remuestrear los datos de ANEEL y TAESA y explico cómo elegir la unidad del bootstrap.

En este artículo
El bootstrap tiene fama de método que no necesita suposiciones: se remuestrea, se recalcula y los cuantiles dan el intervalo. En el caso ANEEL–TAESA, el bootstrap de fragmentos contuvo el valor real en el 25% de las repeticiones, peor aún que la fórmula binomial. No falló por falta de réplicas. Falló porque remuestreó la unidad equivocada, y ninguna cantidad de réplicas corrige eso.
En la primera parte vimos que, en una evaluación por fragmentos, el azar viene del sorteo de documentos. Aquí saco la consecuencia para el bootstrap: qué tiene que remuestrear, qué capta cada alternativa y qué cambia cuando por encima del documento hay otro nivel sorteado.
Parte 1: por qué 10.000 fragmentos no son 10.000 casos
El bootstrap imita un sorteo
El bootstrap empírico de Efron (1979) usa la muestra para aproximar la distribución del estimador. En su versión iid, selecciona con reemplazo el mismo número de unidades. Aquí el sorteo original es sin reemplazo: el bootstrap documental simple lo aproxima, no lo copia exactamente. Cuando la fracción muestral importa, hay que incorporar el diseño finito.
La decisión central es qué variación debe representar el remuestreo. Aquí selecciono documentos y observo todos sus fragmentos. Por eso el bootstrap documental se aproxima a la fuente de incertidumbre de interés. En otros diseños hay que conservar pesos, estratos y etapas; no basta elegir automáticamente el nivel más alto ni suponer independencia entre selecciones sin reemplazo.
En la evaluación por fragmentos, esa unidad es el documento. Cada réplica sortea K identificadores de documento con reemplazo, se lleva todos los resultados de cada documento sorteado y recalcula el mismo estimador. Un documento que sale dos veces cuenta dos veces. Dentro del documento no se toca nada, porque dentro del documento no hubo sorteo.
Qué capta cada esquema
Antes de mirar los datos, la teoría ya dice qué esperar de cada alternativa.
- Fragmentos dentro del documento. Cada documento conserva su tamaño y se sortean fragmentos dentro de él. La varianza de las réplicas es, en promedio, Σ n_d·p_d·(1 − p_d) / N²: solo el ruido interno. La diferencia entre documentos, que es la fuente real de variación, no aparece.
- Bloques vecinos. Mi implementación remuestrea bloques disjuntos dentro de cada documento. Mantiene fijos los documentos, no sus medias: las medias remuestreadas cambian. Con un solo bloque por documento desaparece la variación interna. Esto no evalúa todas las variantes para series estacionarias de Künsch (1989).
- Documentos en un nivel. Cada réplica conserva todos los resultados del documento elegido. Es una aproximación pertinente para el muestreo documental con fracción pequeña. Los resultados de consistencia de Field y Welsh (2007) dependen del modelo y del régimen asintótico; no garantizan calibración con veinte documentos.
- Documentos y después fragmentos. Este segundo sorteo añade variabilidad interna que no pertenece al diseño evaluado, donde se observa completo cada documento seleccionado. Aumentar la varianza bootstrap no garantiza superar la varianza real ni obtener cobertura conservadora. Field y Welsh (2007) distinguen esas cuestiones bajo modelos y regímenes asintóticos explícitos.
- Salvaje por documento. En lugar de sortear documentos, multiplica el residuo de cada documento por un peso aleatorio de media cero. Es la referencia en econometría para pocos conglomerados (Cameron, Gelbach y Miller, 2008), pero con tamaños muy desiguales puede funcionar mal (MacKinnon y Webb, 2017).
Seis esquemas puestos a prueba
Para comprobarlo, sorteé 2.000 muestras de 20 documentos del acervo ANEEL–TAESA, apliqué los seis esquemas con 999 réplicas cada uno y comparé la varianza media de las réplicas con la varianza real del estimador entre muestras. Si un esquema imita bien el sorteo, la razón debe quedar cerca del 100%.
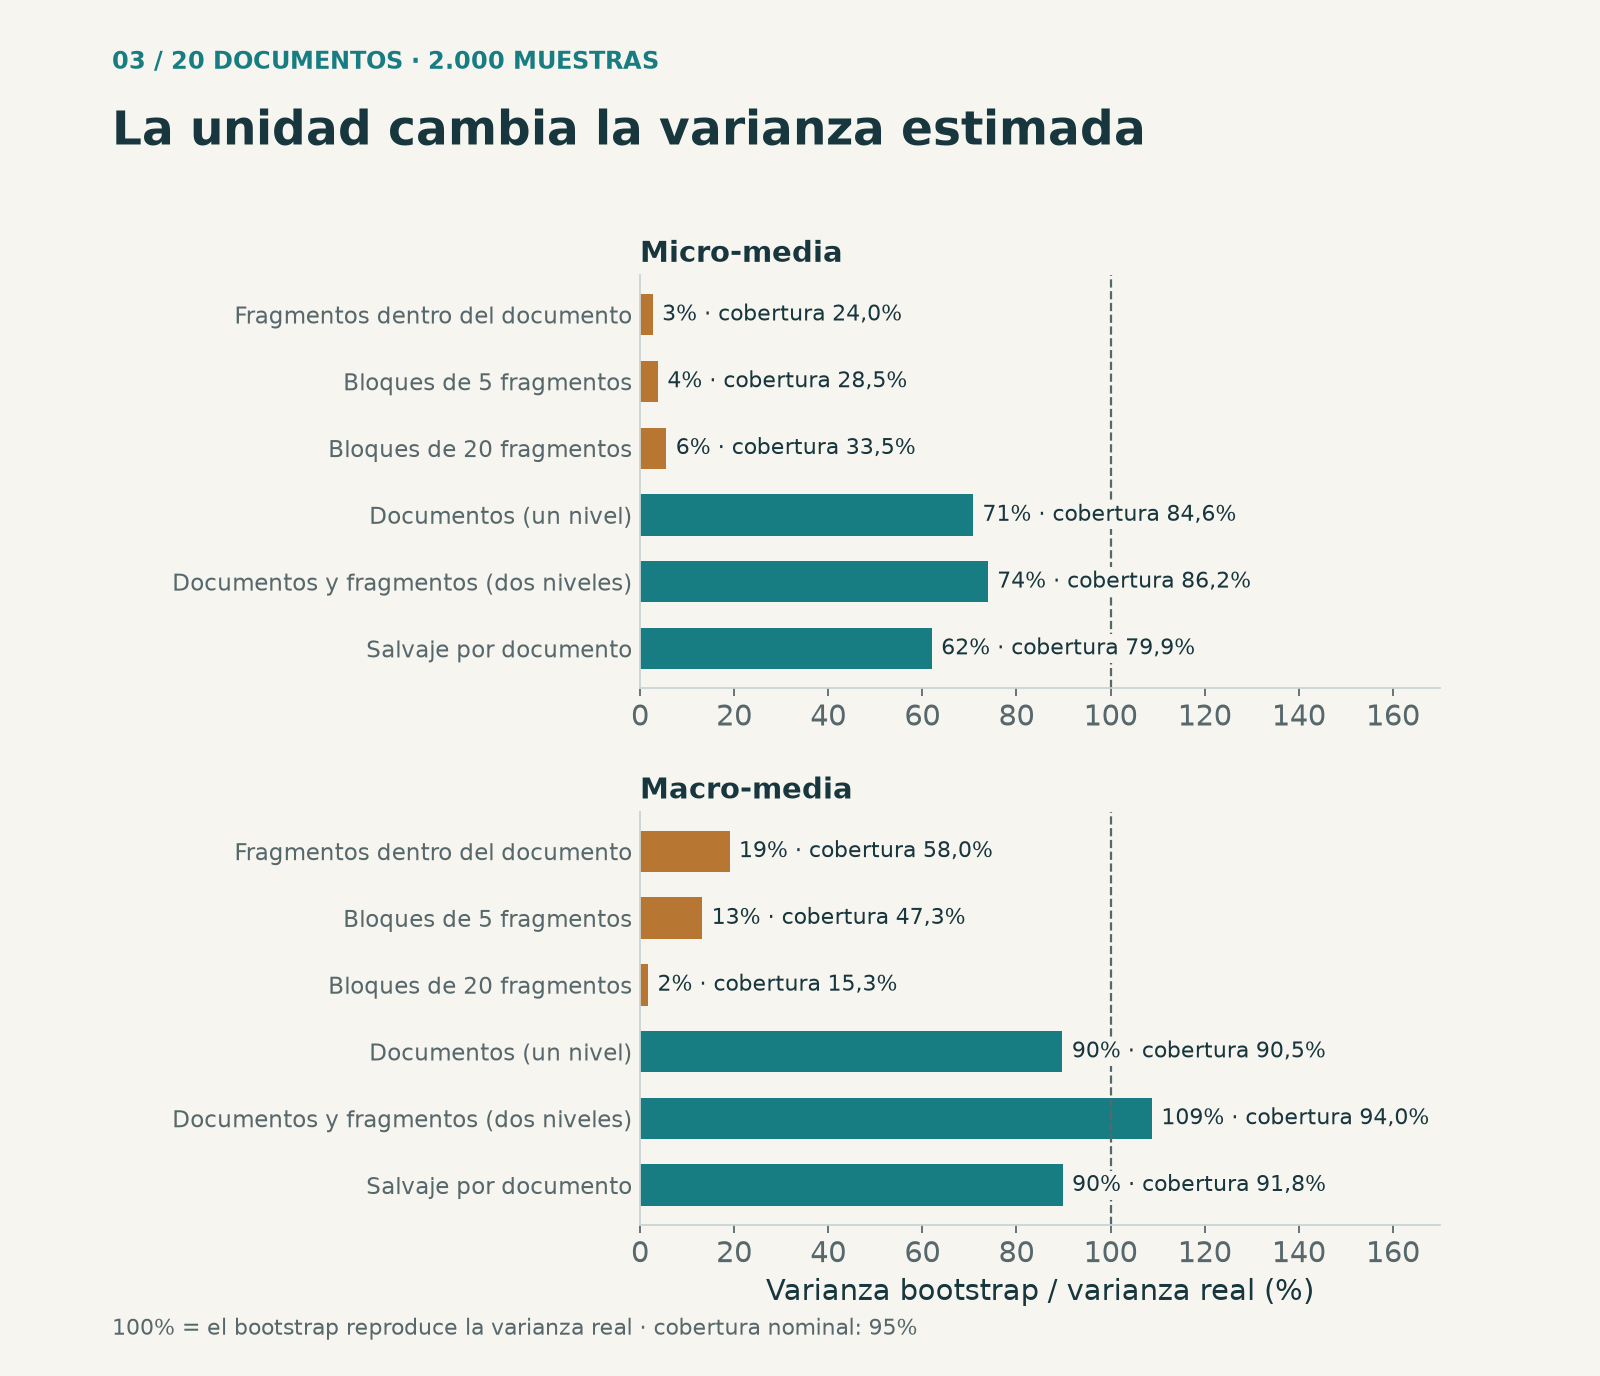
Los tres esquemas que remuestrean dentro del documento captaron entre el 3% y el 6% de la varianza real de la micro-media y no pasaron del 34% de cobertura. Los bloques confirman la teoría: pasar de bloques de 5 a bloques de 20 fragmentos casi no cambia nada en la micro-media y empeora la macro-media, que cae al 15% de cobertura porque muchos documentos cortos quedan con un único bloque. Respetar la dependencia local no basta cuando el problema está en el nivel del documento.
Los esquemas que actúan sobre documentos estimaron entre el 62% y el 109% de la varianza empírica. Con dos niveles, la razón fue 0,739 en micro y 1,088 en macro, con coberturas del 86,25% y 93,95%. Añadir un nivel no garantiza un intervalo conservador. La variante wild no restringida que implementé rindió peor que el bootstrap documental en estos escenarios; eso no descarta otras variantes.
Por qué incluso el esquema correcto se queda corto
El bootstrap documental estimó cerca del 71% de la varianza empírica micro. La concentración de peso vuelve sensible el cociente a la muestra, pero no demuestra el mecanismo de cada fallo. Corregí una explicación anterior: con 129 documentos de más de 76 fragmentos entre 1.300, la probabilidad de no seleccionar ninguno en una muestra de 20 es del 12,17%, no la mayoría. Un subconjunto de documentos grandes y fáciles requeriría su propia definición y cálculo.
Por eso, con pocos documentos, además de la unidad importa el método de intervalo. El percentil hereda la asimetría de la muestra. El bootstrap-t, que divide cada réplica por su propio error estándar, corrige parte de ella: en el estudio original llevó la micro-media del 85,4% al 88,4% y la macro-media del 91,5% al 97,2%, a cambio de intervalos más anchos. Con cinco documentos, ninguno de los dos es fiable. La unidad correcta es una condición necesaria, no suficiente.
Cuando hay un nivel por encima del documento
La regla del sorteo dice más que «use el documento». Dice: use lo que se sorteó. El estudio original lo probó con un diseño en dos etapas. Primero se sortean 6 de los 21 tipos de documento con al menos ocho ejemplares (resoluciones autorizativas, despachos, informes trimestrales, calificaciones de riesgo...) y después 4 documentos dentro de cada tipo. La pregunta pasa a ser la media entre tipos.
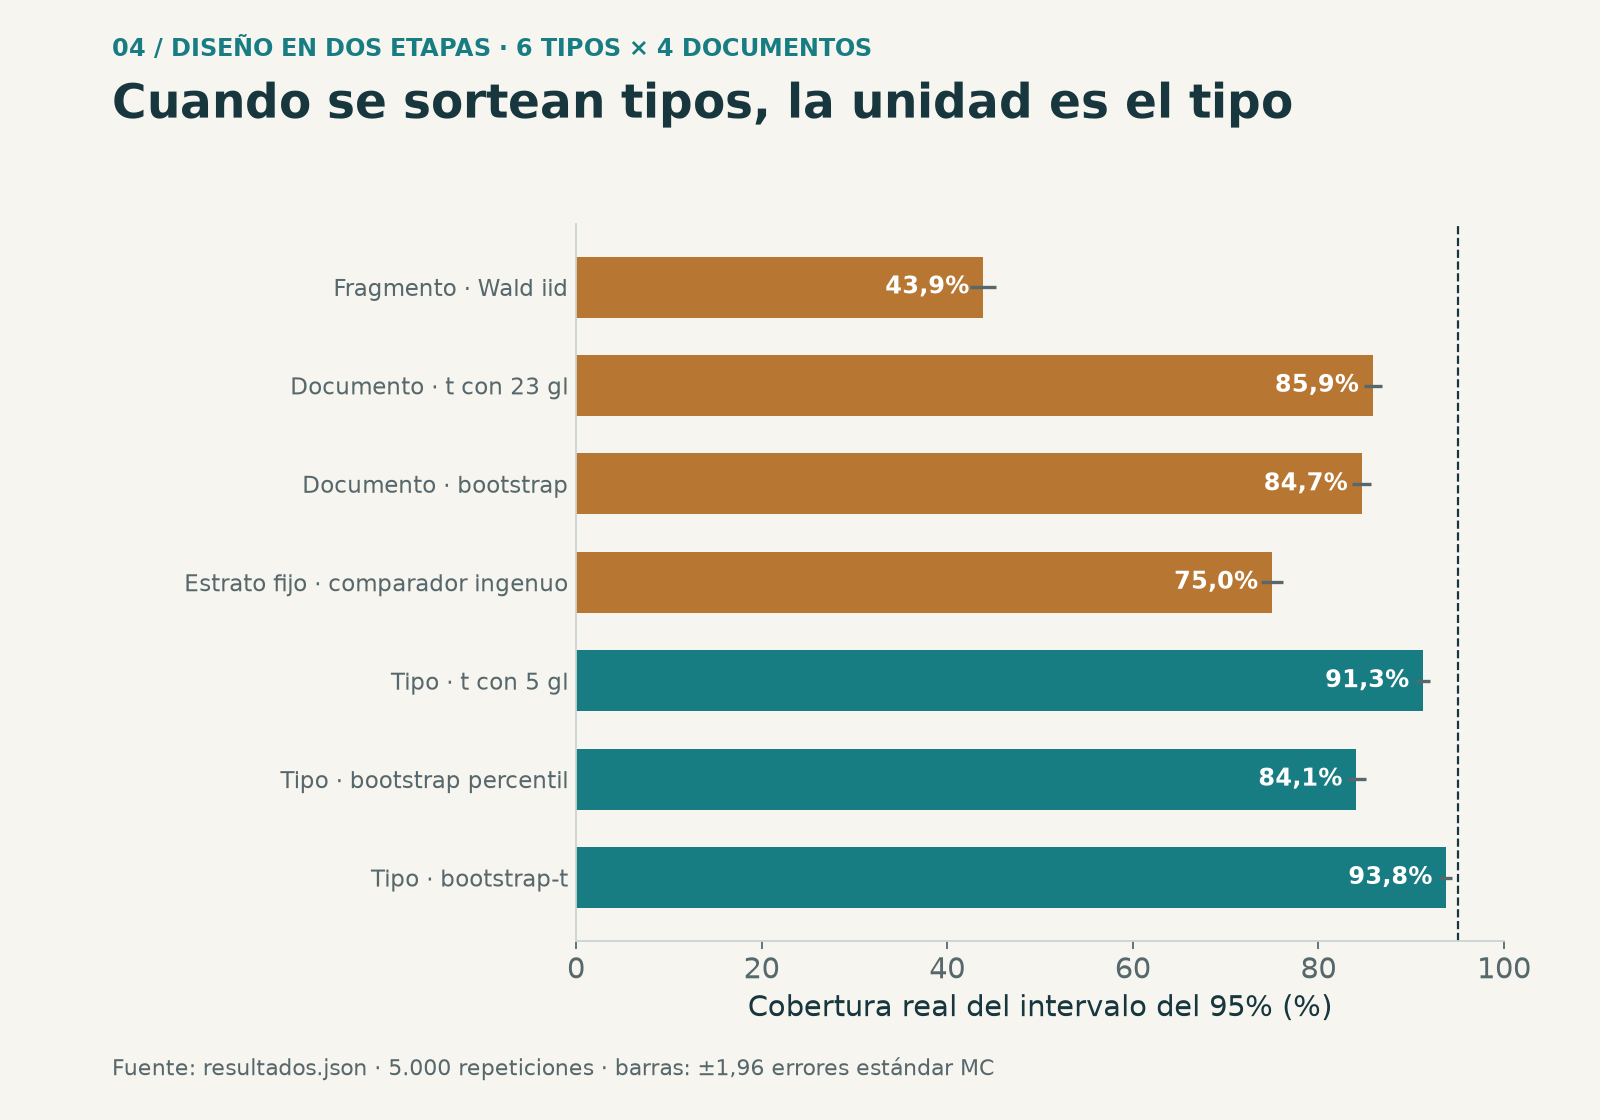
Los métodos documentales originales cubrieron alrededor del 85–86%. El comparador de «estratos fijos» cubrió el 75%, pero también usaba divisor k y cuantiles normales con cuatro documentos por tipo: no aislaba un único error. En la revisión separé el objetivo condicional de los seis tipos elegidos y corregí la varianza; la cobertura fue del 93,76% para ese objetivo, distinto de la media de todos los tipos. Estos porcentajes no responden a la misma pregunta.
El bootstrap simple de tipos es una aproximación de conglomerado último, no una reproducción exacta de dos etapas sin reemplazo. Importan tanto la fracción de 6 entre 21 tipos como el sorteo interno. En la revisión incorporé una varianza con ambas etapas y sus correcciones finitas, verificada por enumeración en una población pequeña. En 5.000 nuevas repeticiones, el intervalo t cubrió el 91,42%: mejorar la varianza no garantiza calibrar los cuantiles. La unidad, los pesos y las etapas deben responder al diseño.
Y si los documentos no se sortearon
Muchas evaluaciones usan los documentos que había a mano. Entonces no existe un sorteo que imitar, y el bootstrap pierde su justificación de diseño. Sigue siendo posible usarlo, pero apoyado en un modelo: la suposición de que los documentos evaluados son intercambiables con aquellos sobre los que se quiere concluir. En ese caso, la unidad la define el objetivo de la generalización. Si la conclusión es sobre otros documentos del mismo tipo, la unidad es el documento; si es sobre otros tipos, es el tipo.
Esa suposición debe quedar escrita en el informe. Ningún remuestreo corrige una selección sesgada: si los 20 documentos se eligieron porque eran los más limpios, las réplicas reproducirán con fidelidad la incertidumbre de una muestra de documentos limpios.
Cuatro preguntas antes de remuestrear
- ¿Qué se sorteó, y en qué orden? La respuesta define la unidad del bootstrap.
- ¿Sobre qué población se quiere concluir? Si no hubo sorteo, es ella la que define la unidad.
- ¿Cuántas unidades hay? Con pocas, comparar aproximaciones y declarar cobertura y grados de libertad; bootstrap-t y CR2 tampoco garantizan el nominal.
- ¿Qué fracción de la población se sorteó en ese nivel? Si es grande, corrija por población finita.
La tercera parte convierte todo esto en un procedimiento de cálculo, con fórmulas, código y una forma de planificar cuántos documentos evaluar.
Parte 3: calcular la incertidumbre sin réplicas artificiales
Procedencia y referencias
Las cifras de los seis esquemas vienen de etapa4_teoria.py: 2.000 muestras de 20 documentos y 999 réplicas por esquema; el bootstrap salvaje usa pesos de Webb y se estudentiza con CR1. Las del diseño en dos etapas y las del bootstrap-t vienen del estudio original, con 5.000 repeticiones. No hubo una nueva ejecución de la recuperación.
Descargar los agregados y los hashes de las fuentes (JSON)
- Efron, B. (1979). Bootstrap methods: another look at the jackknife. The Annals of Statistics, 7(1), 1–26.
- Künsch, H. R. (1989). The jackknife and the bootstrap for general stationary observations. The Annals of Statistics, 17(3), 1217–1241.
- Davison, A. C., & Hinkley, D. V. (1997). Bootstrap Methods and their Application. Cambridge University Press.
- Field, C. A., & Welsh, A. H. (2007). Bootstrapping clustered data. Journal of the Royal Statistical Society: Series B, 69(3), 369–390.
- Cameron, A. C., Gelbach, J. B., & Miller, D. L. (2008). Bootstrap-based improvements for inference with clustered errors. The Review of Economics and Statistics, 90(3), 414–427.
- MacKinnon, J. G., & Webb, M. D. (2017). Wild bootstrap inference for wildly different cluster sizes. Journal of Applied Econometrics, 32(2), 233–254.
- Rao, J. N. K., & Wu, C. F. J. (1988). Resampling inference with complex survey data. Journal of the American Statistical Association, 83(401), 231–241.
Revisión metodológica · 11 de octubre de 2026
Realicé los experimentos como Jean M. Estevez Alvarez. Esta revisión distingue los resultados originales de las verificaciones posteriores: conserva los resultados por fragmento y las coberturas originales, corrige las cantidades derivadas y añade 5.000 repeticiones del diseño de dos etapas. No hubo nueva recuperación, entrenamiento ni evaluación en producción.
Los métodos de la tabla son aproximaciones evaluadas, no una receta calibrada: el 93,0% del t macro sigue por debajo del 95% nominal. El bootstrap-t original descarta réplicas con error estándar cero y devuelve un intervalo puntual si todas degeneran; esa política forma parte de los resultados históricos y no demuestra certeza. En la revisión de dos etapas, la varianza corregida funciona en promedio, pero el intervalo t aún cubre el 91,42%.
Las fórmulas CR1 y macro mostradas sin corrección finita son aproximaciones apropiadas cuando la fracción seleccionada es pequeña. Para AAS sin reemplazo, la varianza macro incluye (1−K/M); la micro admite esa corrección en su linealización. No aplico una única corrección global a diseños de varias etapas. Las referencias originales fundamentan los métodos bajo sus condiciones, no validan por sí solas este corpus.
Resultados de la revisión del diseño (JSON)
Field y Welsh (2007): modelos y límites del bootstrap agrupado