Calcular la incertidumbre sin réplicas artificiales: un procedimiento por documento
Incertidumbre en RAG, parte 3: muestro el cálculo por documento, con fórmulas y código, y cómo lo uso para comparar sistemas y planificar la muestra.

En este artículo
En este estudio, la selección de documentos genera la incertidumbre amostral. Esta parte explica el cálculo para medias de resultados agrupados: hit@k, MRR u otros escores por consulta, siempre que el diseño y el agrupamiento lo permitan. No es una receta automática para métricas no aditivas, preguntas multidocumentales o jueces aleatorios.
Parte 1: por qué 10.000 fragmentos no son 10.000 casos
Parte 2: qué unidad debe remuestrear el bootstrap
Paso 1: una fila por documento
Para las medias y los métodos agrupados de este estudio bastan n_d, el número de resultados observados, y s_d, su suma. Esas columnas permiten recalcular micro, macro y sus aproximaciones de varianza. No sustituyen los registros detallados para auditar rankings, dependencia local o errores temporales. Las métricas no aditivas y las preguntas multidocumentales requieren otra especificación.
Si la métrica no es binaria, se guarda también la suma de los cuadrados. Si la comparación es entre dos sistemas sobre las mismas consultas, s_d pasa a ser la suma de las diferencias por consulta dentro del documento.
Paso 2: declarar el estimando
Con tamaños desiguales hay dos medias distintas, y cada una responde a una pregunta. La micro-media, R = Σ s_d / Σ n_d, es la tasa de un fragmento sorteado al azar: qué fracción de los trechos del acervo atribuye bien el sistema. La macro-media, r̄, la media de las tasas s_d / n_d, es la tasa esperada en un documento típico. En el acervo ANEEL–TAESA valen 0,1846 y 0,1596. No es una elección técnica; hay que decidirla antes de calcular y escribirla en el informe.
Si la pregunta lo admite, la macro-media es más fácil de estimar: con 20 documentos, su raíz del error cuadrático medio fue 0,050, contra 0,089 de la micro-media, que depende mucho de unos pocos documentos grandes.
Paso 3: el error estándar sale de los documentos
La macro-media es una media de K números, uno por documento, y su error estándar es el de cualquier media. La micro-media es un cociente, y su error estándar sale de la linealización clásica del estimador de razón: cada documento contribuye con un residuo u_d = s_d − R·n_d, que mide cuánto se aparta su total de lo que daría la tasa global. En las fórmulas, se(·) es el error estándar y ν, los grados de libertad.
macro   r_d = s_d / n_d      r̄ = (1/K) · Σ r_d
        se(r̄) = sd(r_d) / √K                       ν = K − 1

micro   N = Σ n_d            R = Σ s_d / N        u_d = s_d − R · n_d
  CR1   se(R) = √( K/(K−1) · Σ u_d² ) / N          ν = K − 1
  CR2   se(R) = √( Σ u_d² / (1 − n_d/N) ) / N      ν = Imbens–Kolesár

95%     θ̂ ± t(0.975; ν) · se(θ̂)
CR1 aplica la corrección K/(K−1). CR2 ajusta los residuos bajo un modelo de trabajo; aquí se usa el de independencia. Los grados de libertad aproximados de Imbens–Kolesár reflejan el desequilibrio de pesos. Con tamaños iguales coinciden; para la macro coinciden con el t sobre tasas. Son aproximaciones: estos ajustes no garantizan cobertura nominal con pocos documentos.
Ningún paso usa el número de fragmentos como tamaño de muestra. n_d entra solo como peso del documento. Esa es la diferencia con la fórmula binomial, en la que N aparece en el denominador como si cada fragmento fuera un caso.
Paso 4: el intervalo, con los grados de libertad a la vista
Los grados de libertad describen la aproximación del intervalo, no un número literal de documentos independientes. Con 20 documentos y 764 fragmentos, CR2 obtuvo ν=3,76 y un intervalo micro de [−0,023; 0,308]. El Wald iid dio [0,118; 0,167], que no contenía el objetivo de 0,185. Informo K y ν por separado: son intervalos nominales cuya cobertura debe evaluarse.
El código reproduce las fórmulas deterministas. Su bootstrap usa 9.999 réplicas y semilla 1; el original usó 999 y otra secuencia. Sus límites pueden diferir por Monte Carlo. Primero hay que seleccionar los documentos de la muestra: el censo completo ya tiene una tasa conocida.
import numpy as np
from scipy import stats

# df: one row per chunk (or query), columns doc_id and hit (0/1 or any score)
g = df.groupby("doc_id")["hit"].agg(n="size", s="sum")
n, s = g["n"].to_numpy(float), g["s"].to_numpy(float)
K, N = len(n), n.sum()
if K < 2 or np.any(n <= 0) or not np.isfinite(s).all():
    raise ValueError("Need at least two valid documents")

# micro: ratio estimator, CR2 with Imbens-Kolesar degrees of freedom
R = s.sum() / N
u = s - R * n
h = n / N
se_micro = np.sqrt(np.sum(u**2 / (1 - h))) / N
a = 1 / np.sqrt(1 - h)
M = -np.outer(a * n, a * n) / N
M[np.diag_indices(K)] += a**2 * n
df_micro = np.trace(M)**2 / np.sum(M * M)
ci_micro = R + np.array([-1, 1]) * stats.t.ppf(0.975, df_micro) * se_micro

# macro: mean of per-document rates, t with K - 1 degrees of freedom
r = s / n
se_macro = r.std(ddof=1) / np.sqrt(K)
ci_macro = r.mean() + np.array([-1, 1]) * stats.t.ppf(0.975, K - 1) * se_macro

# document bootstrap-t (macro): resample documents, studentise each replicate
rng = np.random.default_rng(1)
rb = r[rng.integers(0, K, (9999, K))]
sd = rb.std(1, ddof=1)
degenerate_fraction = np.mean(sd == 0)
if not np.any(sd > 0):
    raise ValueError("All bootstrap replicates have zero SE; interval unavailable")
tb = (rb.mean(1)[sd > 0] - r.mean()) / (sd[sd > 0] / np.sqrt(K))
lo, hi = np.quantile(tb, [0.025, 0.975])
ci_boot_t = (r.mean() - hi * se_macro, r.mean() - lo * se_macro)
Para la micro-media, el bootstrap-t sigue la misma lógica: en cada réplica se sortean documentos, se recalcula el cociente y se divide por el CR1 de la propia réplica. Las réplicas en las que todos los documentos tienen la misma tasa no tienen error estándar y se descartan.
Paso 5: elegir el método según la situación
No hay un método que domine en todos los casos. Las coberturas del estudio, con intervalos nominales del 95%, sugieren una guía:
| Situación | Aproximación evaluada | Límite o precaución |
|---|---|---|
| Macro-media, 20 documentos o más | t con K − 1 gl sobre las tasas (93,0%) | Wald iid y bootstrap de fragmentos (59,7%) |
| Micro-media, tamaños desiguales | CR2 con gl de Imbens–Kolesár (85,7%) o bootstrap-t (88,4%) | CR1 (77,1%) y Wald iid (29,5%) |
| Cinco documentos | CR2 (86,6% micro), avisando que el nominal no está garantizado | Bootstrap-t (71,1%) y percentil (75,0%) |
| Tasa cerca de 0 o de 1 | Intervalo en escala logit (no evaluado aquí) | Logit no garantiza cobertura; tratar 0 y 1 |
| Se sortearon tipos y después documentos | Aproximación por tipo; revisión de dos etapas: t 91,42% | El comparador original de estratos no aisló un único error |
Logit mantiene los límites en el dominio cuando la transformación está definida, pero requiere tratar estimaciones en cero o uno y no garantiza cobertura. No lo evalué aquí. Intersectar un intervalo con [0,1] conserva la cobertura para una proporción y tampoco la mejora. Conviene informar ceros, unos y réplicas degeneradas, no esconderlos detrás de una transformación.
Comparar dos sistemas: diferencias por documento
Comparo los recuperadores sobre las mismas consultas y agrego las diferencias por documento. El pareamiento aprovecha la variación compartida y puede reducir la varianza: Var(A−B)=Var(A)+Var(B)−2Cov(A,B). No elimina las interacciones entre sistema y documento ni cambia por sí solo la unidad muestral.
En el acervo ANEEL–TAESA, la ventaja de BM25 sobre TF-IDF fue de 0,62 puntos en la micro-media y de 0,27 en la macro-media, con empate exacto en el 70% de los documentos. Con diferencias tan pequeñas, discretas y llenas de ceros, los bootstraps por documento cubrieron entre el 85% y el 89%. El CR2 de la micro-media (95,7%) y el t de la macro-media (97,4%) fueron los únicos que llegaron al nominal o lo superaron. Antes de anunciar que un sistema es mejor, vale la pena comprobar el método en una simulación con los propios datos, como hizo este estudio.
Planificar: la precisión se compra con documentos
Para planificar con M=1.300 documentos usé t × S/√K × √(1−K/M). La aproximación da 76 documentos para una semiamplitud de 0,05 en macro y 220 en micro; sin corrección finita, 80 y 264. No garantiza cobertura ni utiliza grados de libertad CR2 específicos. También hay que comprobar asimetría e influencia documental.
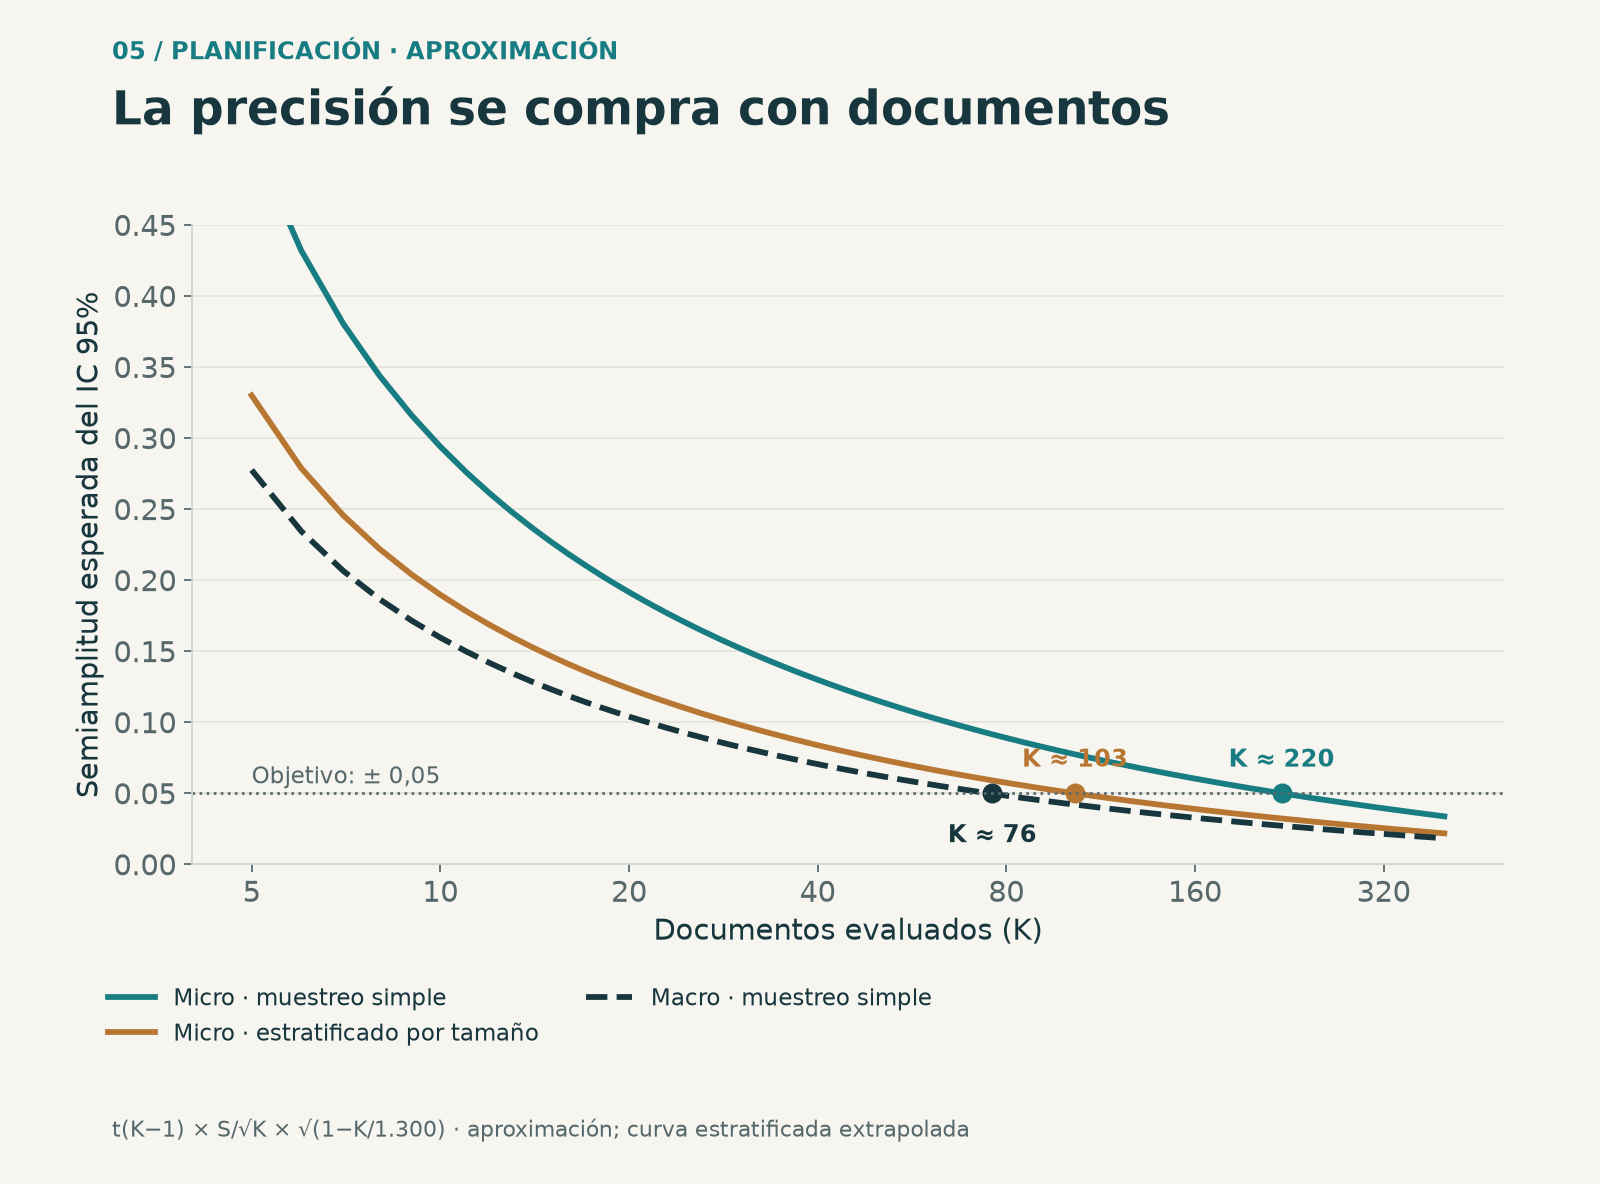
La micro-media es cara porque unos pocos documentos grandes deciden el resultado. El remedio es de diseño, no de cálculo: estratificar el sorteo por tamaño. Probé separar los 129 documentos con más de 76 fragmentos, que concentran el 59% de todos los fragmentos, y sortear 10 entre ellos y 10 entre los demás, con el estimador de razón combinado y su error estándar estratificado. Coherente con la parte 2, los estratos son fijos y los documentos se sortean dentro de cada uno.
La desviación estándar de la micro-media bajó de 0,092 a 0,059, y la anchura media del intervalo, de 0,39 con CR2 a 0,22. La cobertura subió al 88,6%, todavía por debajo del 95%: dentro del estrato de documentos pequeños sigue habiendo mucha asimetría. Estratificar no sustituye a tener más documentos, pero hace que cada documento rinda más.
Qué informar
- La población y el diseño: qué se sorteó, en qué niveles y con qué fracción.
- El estimando, micro o macro, y por qué responde a la pregunta.
- K, N y la distribución del número de fragmentos por documento.
- El método de intervalo, la unidad de remuestreo y los grados de libertad efectivos.
- La correlación intraclase y el efecto de diseño, como diagnóstico y no como sustituto del cálculo.
- La fracción de documentos con tasa cero o uno y la distribución de las tasas por documento.
- Lo que queda fuera: el índice fijo, el recuperador y la población de preguntas.
Sobre el diagnóstico: el tamaño efectivo N/DEFF ayuda a explicar el problema, pero usarlo como si fueran N/DEFF casos independientes es otra aproximación frágil. En el estudio, ese «Wald con n efectivo» cubrió el 89% con 20 documentos y cayó al 74% con cinco.
Cierre de la serie
Empiezo por el diseño: qué se seleccionó, cuál es la población y qué media responde a la pregunta. Aquí agrego por documento y conservo ese agrupamiento en la inferencia. Otros diseños requieren pesos, estratos, etapas o preguntas que dependen de varios documentos. Los 10.000 fragmentos de 20 documentos ilustran la diferencia entre mediciones y unidades muestrales; esos recuentos no determinan por sí solos el error estándar.
Procedencia y referencias
Coberturas de los métodos y comparación pareada: estudio ANEEL–TAESA, con 5.000 repeticiones para K = 20 y 2.000 en las sensibilidades. Estratificación por tamaño y planificación: etapa4_teoria.py, con 2.000 muestras. La curva estratificada de la figura extrapola la desviación estándar observada con K = 20 y es solo indicativa.
Descargar los agregados y los hashes de las fuentes (JSON)
- Bell, R. M., & McCaffrey, D. F. (2002). Bias reduction in standard errors for linear regression with multi-stage samples. Survey Methodology, 28(2), 169–181.
- Imbens, G. W., & Kolesár, M. (2016). Robust standard errors in small samples: some practical advice. The Review of Economics and Statistics, 98(4), 701–712.
- Pustejovsky, J. E., & Tipton, E. (2018). Small-sample methods for cluster-robust variance estimation and hypothesis testing in fixed effects models. Journal of Business & Economic Statistics, 36(4), 672–683.
- Cochran, W. G. (1977). Sampling Techniques (3rd ed.). Wiley.
- Miller, E. (2024). Adding Error Bars to Evals: A Statistical Approach to Language Model Evaluations. arXiv:2411.00640.
Revisión metodológica · 11 de octubre de 2026
Realicé los experimentos como Jean M. Estevez Alvarez. Esta revisión distingue los resultados originales de las verificaciones posteriores: conserva los resultados por fragmento y las coberturas originales, corrige las cantidades derivadas y añade 5.000 repeticiones del diseño de dos etapas. No hubo nueva recuperación, entrenamiento ni evaluación en producción.
Los métodos de la tabla son aproximaciones evaluadas, no una receta calibrada: el 93,0% del t macro sigue por debajo del 95% nominal. El bootstrap-t original descarta réplicas con error estándar cero y devuelve un intervalo puntual si todas degeneran; esa política forma parte de los resultados históricos y no demuestra certeza. En la revisión de dos etapas, la varianza corregida funciona en promedio, pero el intervalo t aún cubre el 91,42%.
Las fórmulas CR1 y macro mostradas sin corrección finita son aproximaciones apropiadas cuando la fracción seleccionada es pequeña. Para AAS sin reemplazo, la varianza macro incluye (1−K/M); la micro admite esa corrección en su linealización. No aplico una única corrección global a diseños de varias etapas. Las referencias originales fundamentan los métodos bajo sus condiciones, no validan por sí solas este corpus.
Resultados de la revisión del diseño (JSON)
Field y Welsh (2007): modelos y límites del bootstrap agrupado