33.503 fragmentos no son 33.503 pruebas: resultados del caso ANEEL–TAESA
Parte 1 del caso ANEEL–TAESA: al tratar fragmentos como pruebas independientes, un intervalo nominal del 95% cubrió el valor real en solo el 29,5% de las repeticiones. Aquí explico el experimento.

En este artículo
Quien evalúa un sistema de búsqueda sobre documentos suele seguir una receta conocida: corta los textos en fragmentos, convierte cada fragmento en una consulta y cuenta cuántas veces el sistema encuentra el origen correcto. Con 20 documentos salen algunos cientos de pruebas; con todo el acervo de ANEEL y TAESA que analizo aquí, 33.503. Tantas pruebas dan la sensación de una medida firme, con un margen de error de unos pocos puntos porcentuales.
La pregunta que guía este artículo es sencilla de plantear: ¿ese margen de error es verdadero? Si digo que el sistema acierta en el 18% de los casos, más o menos tres puntos, ¿cuánto puedo confiar en ese intervalo?
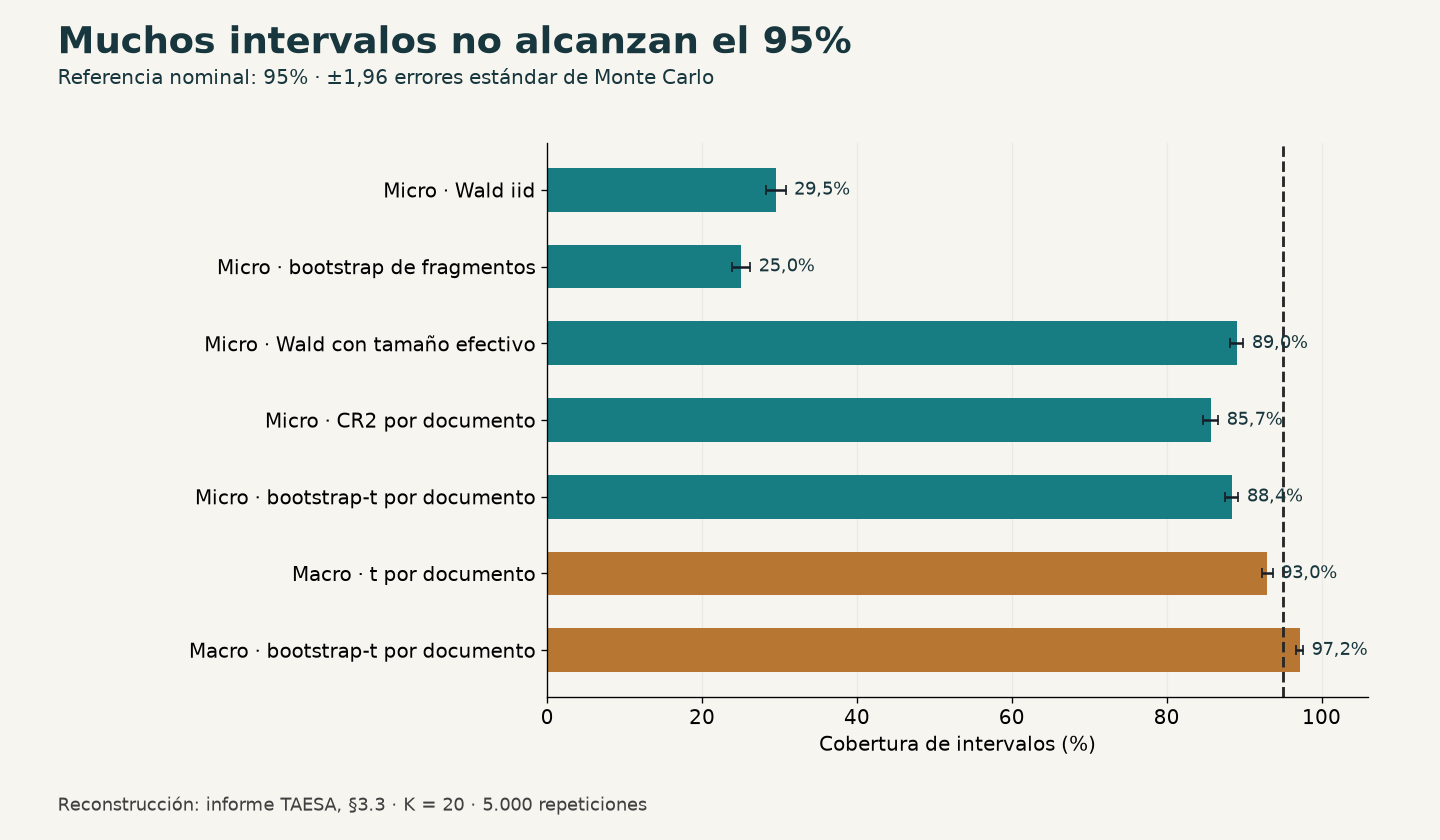
Normalmente no hay forma de comprobarlo, porque no conocemos el valor real. En este estudio sí lo conocemos. El resultado de los 33.503 fragmentos se calculó una sola vez y la tasa de acierto de todo el acervo quedó registrada. Eso permitió repetir 5.000 veces lo que haría un evaluador en la práctica: sortear 20 documentos, medir, calcular un intervalo del 95% y ver si contiene el valor real. Un intervalo del 95% honesto acertaría en cerca del 95% de las repeticiones. El método más habitual, que trata cada fragmento como una prueba independiente, acertó en el 29,5%.
Dicho de otro modo: siete de cada diez intervalos prometían una precisión que no existía. En esta primera parte cuento cómo se montó la prueba, por qué la suposición de independencia falla en un acervo regulatorio y qué cambia cuando la unidad que se cuenta pasa a ser el documento. Trabajo con resultados ya calculados del experimento, sin una nueva ejecución y sin evaluar respuestas en producción. La segunda parte usa estos hallazgos para discutir cómo preparar y segmentar los textos de un RAG regulatorio.
Parte 2: chunking, dispositivos y vigencia
Cómo se montó la prueba
El acervo reúne 1.300 documentos: 931 actos de ANEEL, como resoluciones, despachos y ordenanzas, y 369 documentos de relaciones con inversores de TAESA, como informes trimestrales, hechos relevantes y calificaciones de riesgo. Es el tipo de material que tendría que consultar un asistente de IA de la empresa. Algunas decisiones de composición pesan en el resultado. Cuando un acto existía como resumen y como texto íntegro, se quedó solo el íntegro. Los textos del DOU salieron porque repetían los PDF oficiales. Y de relaciones con inversores, que por sí solas sumaban unos 14 millones de palabras, se sortearon hasta 25 documentos válidos por tipo, con semilla fija. No es un censo del archivo ni una muestra de las preguntas que harían sus usuarios.
La tarea no necesita etiquetas humanas. Cada documento se dividió en fragmentos de 100 palabras. Las primeras 20 palabras de cada fragmento se usan como consulta, BM25 busca en el índice con todos los demás fragmentos y la prueba cuenta como acierto si el primer resultado viene del mismo documento. Es una forma barata y objetiva de preguntar: ¿el buscador reconoce de dónde salió este pedazo de texto? Los documentos con un único fragmento quedaron fuera, porque en ellos acertar es imposible: el único fragmento correcto es justo el que se excluye de la búsqueda.
Lo que dice un 18%, y lo que no dice
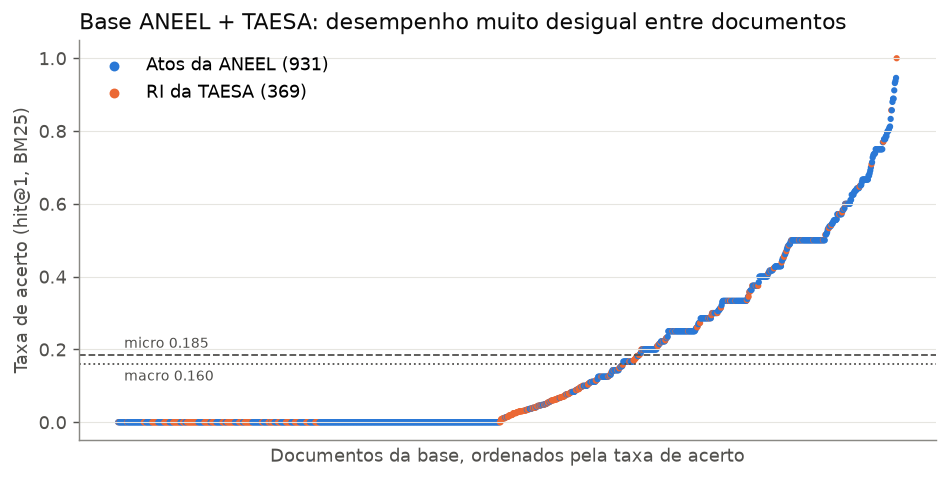
En todo el acervo, BM25 acertó el 18,46% de las consultas. Esa es la micro-media, en la que cada fragmento pesa lo mismo. Si primero se calcula la tasa de cada documento y después se promedia entre documentos, la macro-media, el resultado baja al 15,96%. Los 2,5 puntos de diferencia aparecen porque los documentos grandes tienen más fragmentos y, por tanto, más votos en la micro-media. Cuál usar depende de la pregunta: la fracción de fragmentos atribuidos correctamente o el desempeño en un documento típico.
El resultado varía por tipo: las demostraciones contables regulatorias anuales quedaron cerca del 4%, los formularios de referencia del 6% y los avisos de dividendos en cero; resoluciones normativas y despachos superaron el 40%. La semejanza entre versiones es una hipótesis plausible, pero los aciertos guardados no identifican la causa de cada error. Para comprobarla necesito consultas, rankings y revisión de los documentos recuperados.
Conviene ser preciso sobre lo que esto mide. Aquí hit@1 es un proxy de atribución de fuente, no la calidad de una respuesta: no verifica relevancia juzgada por especialistas, fidelidad, citas ni vigencia. Un pasaje idéntico de otra edición cuenta como error, aunque responda bien a una pregunta atemporal. Los documentos con tasa cero no son irrecuperables en un RAG; solo no fueron reconocidos en esta prueba. En un acervo regulatorio, sin embargo, confundir 2021 con 2022 es justo el tipo de error que importa.
Ver la figura original T1: distribución por documento (en portugués)
La suposición escondida: cada fragmento es una prueba independiente
Cuando el intervalo de confianza se calcula sobre fragmentos, la fórmula supone que cada uno es una observación nueva, como sacar bolas de una urna. Piense en una encuesta en la que entrevista a 20 personas y le hace 50 preguntas parecidas a cada una. Tiene 1.000 respuestas, pero las de una misma persona se parecen entre sí. La información real está más cerca de 20 personas que de 1.000 respuestas.
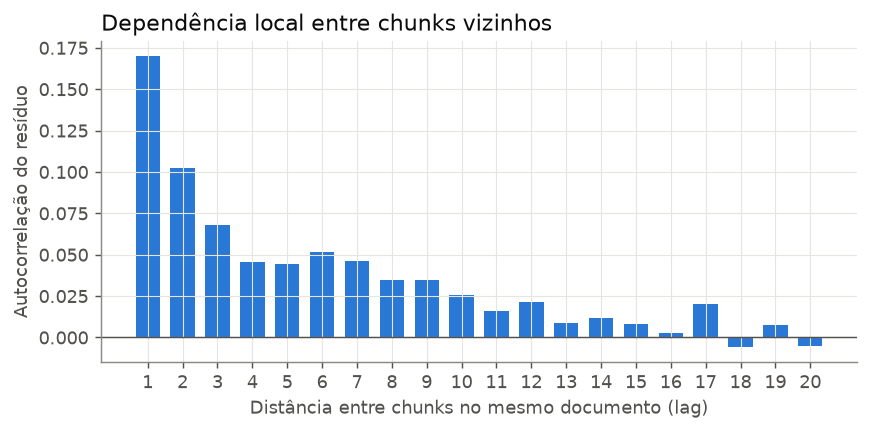
Con los documentos pasa lo mismo. Los fragmentos de una misma resolución comparten vocabulario, estructura y asunto; si uno es fácil de atribuir, sus vecinos suelen serlo también. El estudio lo midió. La correlación intraclase (ICC), que indica cuánto del resultado explica el documento, fue 0,293, cinco veces mayor que en un caso anterior con artículos científicos. Incluso descontando la media de cada documento, los fragmentos vecinos todavía tienen una autocorrelación de 0,17. Y los tamaños son muy desiguales: la mediana es de siete fragmentos por documento, pero el 10% de documentos más grandes concentra el 59% de todos los fragmentos.
La aproximación de DEFF basada en ICC y tamaños da 33,2 y un equivalente N/DEFF cercano a 1.010. Es una referencia de varianza bajo ese modelo, no 1.010 documentos ni la varianza de muestreo de un censo ya observado. Con tamaños desiguales se necesita el CV; la fórmula balanceada 1+(m−1)ρ no reproduce ese valor.
Cómo saber si un intervalo es honesto
Aquí entra el concepto de cobertura. Como se conoce el valor de toda la población, se puede repetir el muestreo miles de veces y contar cuántos intervalos contienen ese valor. Un procedimiento del 95% debería acertar en cerca del 95% de las repeticiones. La cobertura habla del método, no del sistema: no significa que el 95% de las respuestas sean correctas ni que haya un 95% de probabilidad de que el valor esté dentro de un intervalo ya calculado.
| Media | Método | Cobertura | Margen MC (p.p.) | Anchura media |
|---|---|---|---|---|
| micro | Wald iid | 29.5% | ±1.3 | 0.069 |
| micro | Bootstrap de fragmentos | 25.0% | ±1.2 | 0.057 |
| micro | Wald con tamaño efectivo | 89.0% | ±0.9 | 0.329 |
| micro | CR2 por documento | 85.7% | ±1.0 | 0.389 |
| micro | Bootstrap-t por documento | 88.4% | ±0.9 | 0.673 |
| macro | t por documento | 93.0% | ±0.7 | 0.206 |
| macro | Bootstrap-t por documento | 97.2% | ±0.5 | 0.243 |
Los dos métodos que cuentan los fragmentos como independientes, el Wald iid y el bootstrap de fragmentos, cubrieron el 29,5% y el 25%. El bootstrap merece atención porque transmite la impresión de ser un método robusto. Sortea fragmentos con reemplazo; si la unidad sorteada es la equivocada, repetir el sorteo un millón de veces solo reproduce el mismo error con más decimales.
Los métodos documentales mejoran mucho frente al iid, pero ninguno alcanzó el 95% en micro con 20 documentos: CR2 cubrió el 85,7% y bootstrap-t el 88,4%. El Wald con tamaño efectivo llegó al 89,0%, sin convertirse por eso en una solución general. En macro, t cubrió el 93,0% y bootstrap-t el 97,2%. La concentración de pesos y las tasas con muchos ceros justifican investigar la influencia de la muestra; no demuestran por sí solas una causa única de la subcobertura.
No leo estos números como una clasificación universal. Con cinco documentos, el bootstrap-t puede producir intervalos más anchos que [0,1]. Intersectar un intervalo con ese espacio conserva su evento de cobertura para una proporción, pero no corrige la subcobertura. Logit puede mantener los límites en el dominio cuando está definido; tampoco garantiza calibración. Y los 3,76 grados de libertad CR2 de una muestra no significan literalmente cuatro documentos independientes.
Pustejovsky y Tipton (2018): inferencia robusta con pocos grupos
Cómo calcular respetando el documento
En la práctica, el ajuste es menos complicado de lo que parece. Para cada documento d se guarda su número de fragmentos n_d, sus aciertos s_d y su tasa p_d = s_d / n_d. La macro-media es el promedio de las tasas; la micro-media es la suma de aciertos dividida por la suma de fragmentos. Con tamaños desiguales, las dos no coinciden, así que cada réplica tiene que recalcular exactamente el estimador elegido.
En el bootstrap por documento, cada réplica sortea 20 identificadores de documento con reemplazo y se lleva todos los resultados de cada uno. Si un documento sale dos veces, su bloque cuenta dos veces. No se crea ningún documento nuevo: la idea es imitar la variación entre muestras posibles a partir de los grupos observados. Se puede empezar con 5.000 réplicas y comprobar si los cuantiles cambian al aumentar ese número. El error estándar es la desviación estándar de las estimaciones replicadas y el intervalo percentil del 95% usa los cuantiles 2,5% y 97,5%. Esto describe la mecánica, no una recomendación: con pocos grupos, ese intervalo subcubrió en este informe. Para la macro-media hay una alternativa directa: media de las tasas ± t con K − 1 grados de libertad × desviación estándar de las tasas / raíz de K. Si antes de los documentos se sortearon tipos o familias, ese nivel también tiene que entrar en el cálculo.
Un ejemplo inventado muestra el tamaño de la diferencia. Imagine 20 documentos con 500 fragmentos cada uno: diez nunca aciertan y diez aciertan el 40% de las veces. Las dos medias dan 0,20. Si los 10.000 resultados se tratan como independientes, el error estándar sale 0,004 y el intervalo del 95% queda en torno a [0,192; 0,208]. Si la cuenta se hace con las 20 tasas, la desviación estándar es 0,2052, el error estándar 0,0459 y el intervalo t con 19 grados de libertad va aproximadamente de 0,104 a 0,296. Los datos son los mismos; el intervalo honesto es más de diez veces más ancho. Son números ilustrativos, no resultados de TAESA.
Dos salvedades. La primera: saber que hay 10.000 fragmentos y 20 documentos no basta para calcular nada; hacen falta los resultados, los tamaños y el diseño de selección. La segunda: el remuestreo mide la incertidumbre de sortear documentos con el índice fijo. No cubre lo que pasaría si se reconstruyera el corpus, se cambiara el recuperador o llegaran preguntas distintas. Y si la muestra es una fracción grande de una población finita, la corrección correspondiente también entra en la cuenta.
Cortar más fino empeora la ilusión
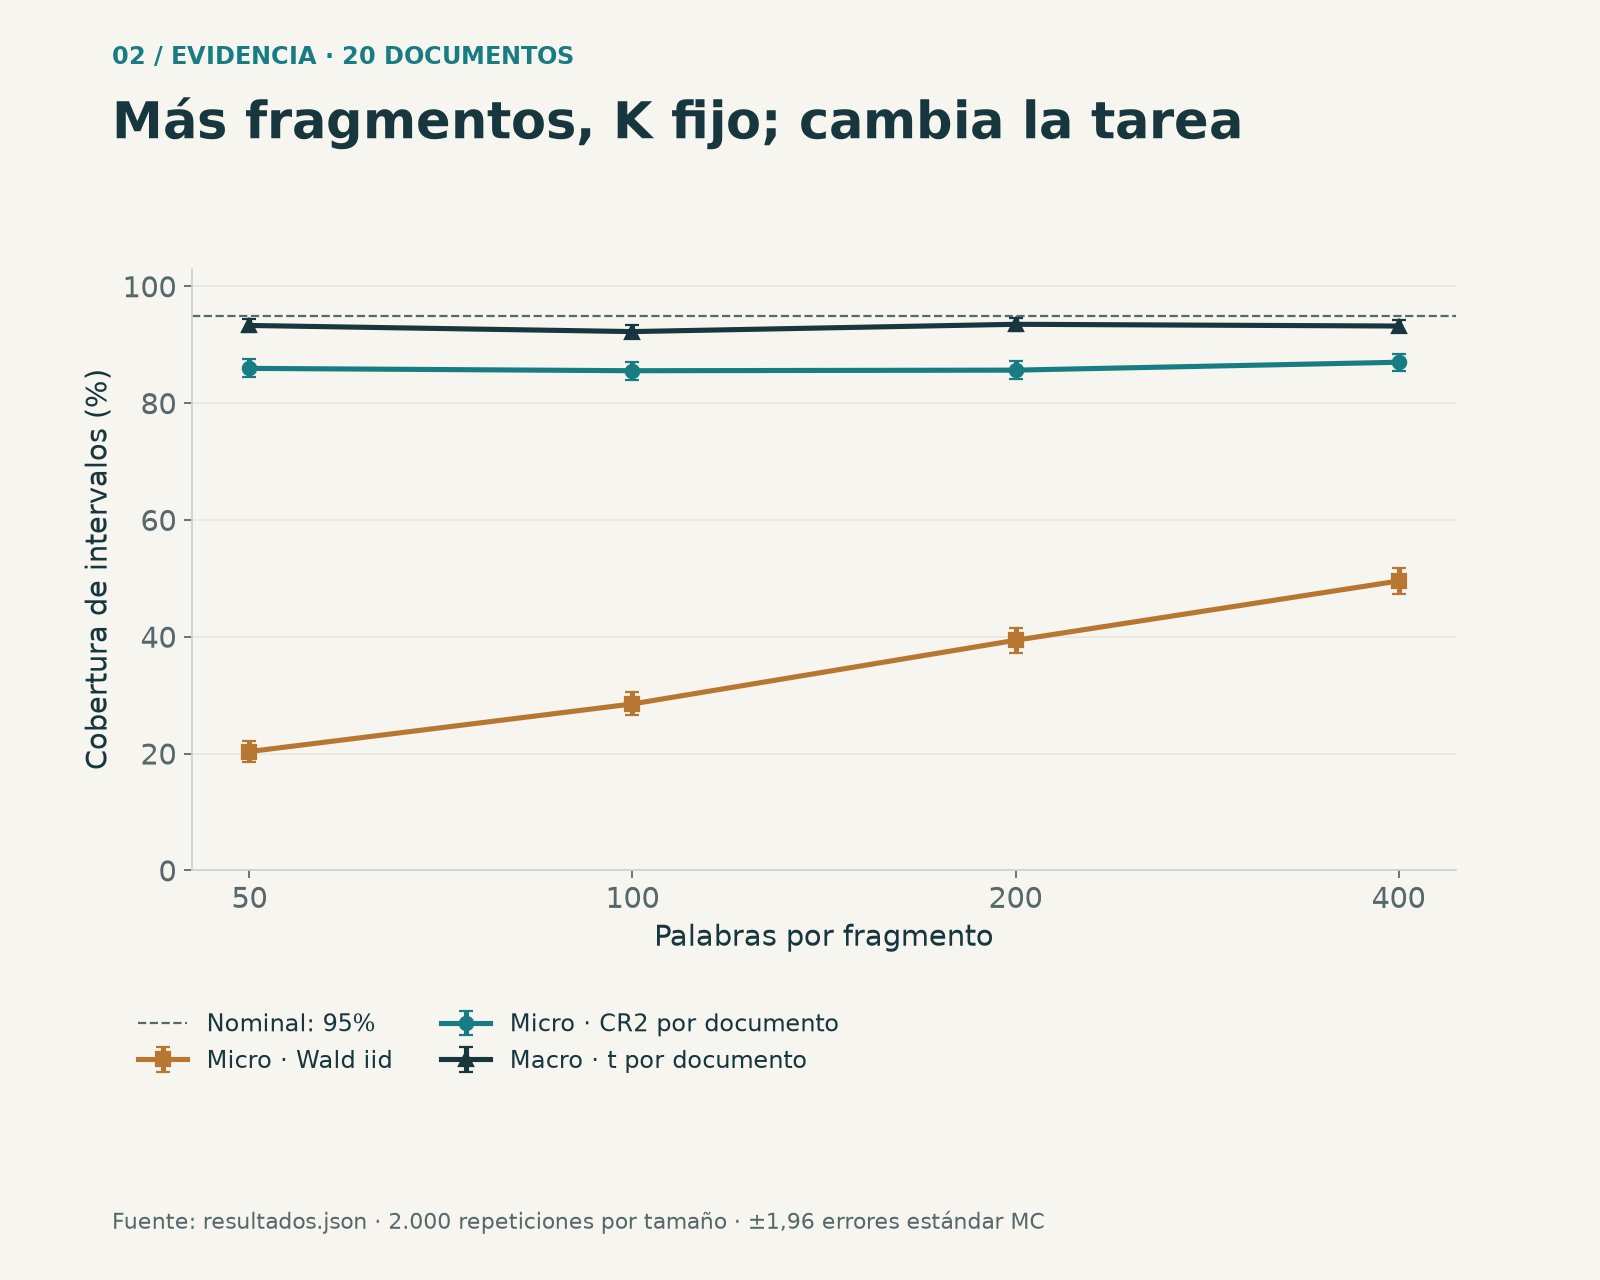
Al variar el tamaño mantuve K=20, pero no las mismas muestras ni las mismas consultas. Con fragmentos de 400 palabras fueron elegibles 749 documentos; con 50, 1.300. La cobertura Wald micro cayó del 49,5% al 20,3%, mientras los fragmentos esperados por muestra pasaron de unos 212 a 1.031. Es una sensibilidad conjunta de población, consultas y segmentación; no identifica el efecto aislado de cortar más fino.
Más documentos ayudan, y el diseño decide la unidad
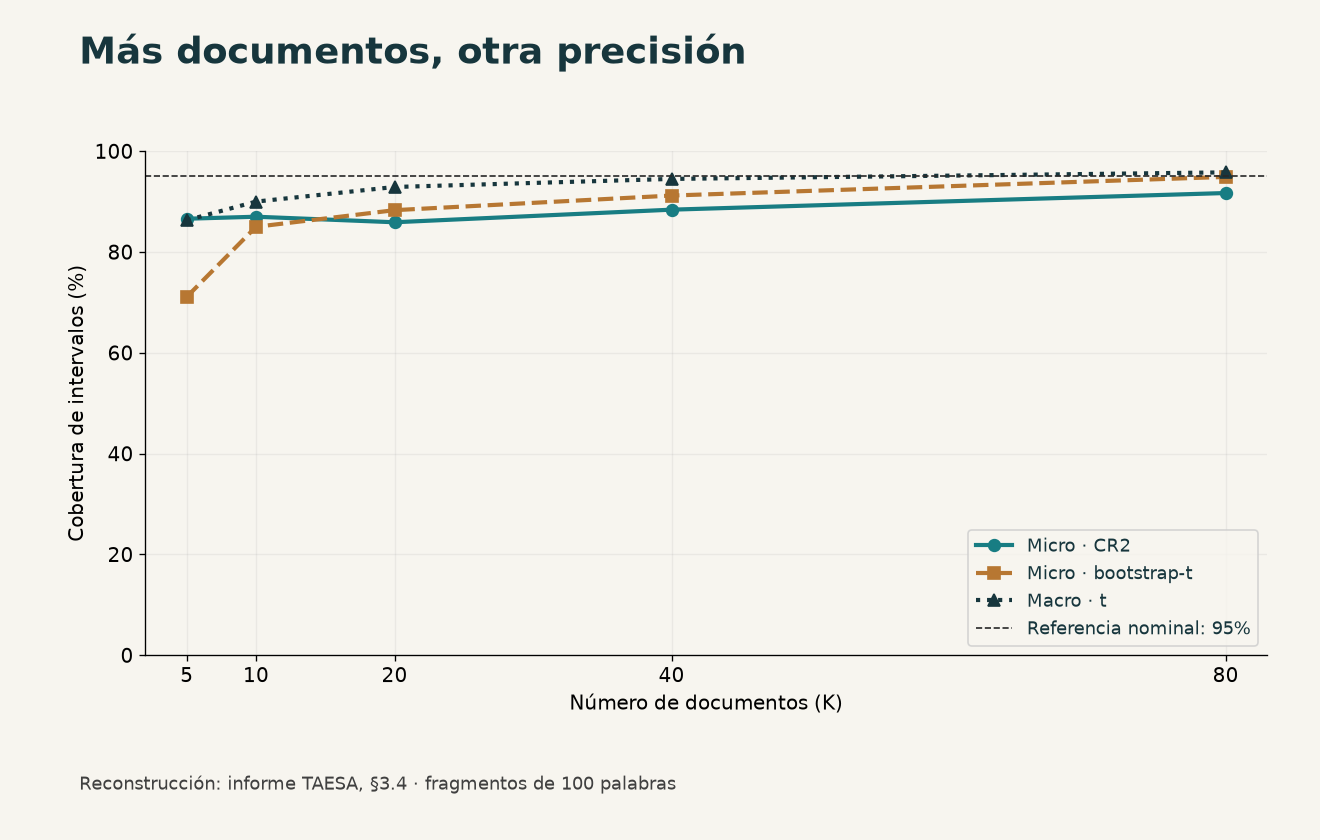
En esta población, aumentar K acercó algunos métodos al nominal: el t macro cubrió el 94,5% con 40 documentos y el 95,8% con 80; en micro, CR2 y bootstrap-t cubrieron el 91,7% y 94,9% con 80. Son resultados de configuraciones concretas, no garantías de que cierta cantidad de documentos baste para cualquier evaluación.
| K | Micro: CR2 | Micro: bootstrap-t | Macro: t |
|---|---|---|---|
| 5 | 86.6% | 71.1% | 86.3% |
| 10 | 87.0% | 85.0% | 90.0% |
| 20 | 85.9% | 88.3% | 92.9% |
| 40 | 88.4% | 91.2% | 94.5% |
| 80 | 91.7% | 94.9% | 95.8% |
También evalué seleccionar seis tipos y cuatro documentos de cada uno. El objetivo es la media entre tipos, 0,1156. Los métodos documentales y el bootstrap simple de tipos son aproximaciones distintas; este último no reproduce exactamente las dos etapas sin reemplazo. La revisión añadió una referencia con ambas correcciones finitas: en 5.000 nuevas repeticiones, el intervalo t cubrió el 91,42%, todavía por debajo del nominal. La elección depende del diseño completo, no solo de la semejanza temática.
Qué cambia en una decisión sobre RAG
Vuelvo a la situación del principio. Alguien compara dos recuperadores, ve una diferencia de dos puntos con miles de pruebas y concluye que uno es mejor. Antes de aceptar la conclusión, yo haría cuatro preguntas. ¿Cuál es la población y qué estimador responde a la pregunta de negocio? ¿La comparación usa las mismas consultas, con diferencias pareadas? ¿La unidad de remuestreo corresponde a lo que se sorteó? ¿Y el método de intervalo se verificó o solo se eligió por el nombre? En esta base, la ventaja de BM25 sobre TF-IDF fue de 0,62 puntos en la micro-media, con empate en el 70% de los documentos: una diferencia de ese tamaño necesita una evaluación bien diseñada para significar algo.
También publicaría la distribución por documento junto con la media. Un 18% de media esconde que la mitad de los documentos nunca fue reconocida y que una minoría lo es casi siempre. El estudio no muestra que una representación jurídica estructurada mejoraría la recuperación. Muestra dónde mirar primero: en cómo se representan los documentos y en cómo se evalúa, antes de atribuir cualquier ganancia al modelo. De eso trata la segunda parte.
Continuar: del fragmento al dispositivo regulatorio
Procedencia, figuras y límites de esta lectura
Fuente: informe ANEEL–TAESA de Jean M. Estevez Alvarez, revisado el 11 de octubre de 2026, y resultados guardados. Las figuras originales conservan las simulaciones históricas. Esta revisión añade una verificación de dos etapas, identificada por separado; no repite la extracción ni la recuperación. Los manifiestos actuales y anteriores permiten distinguir las versiones del informe y de los agregados.
Descargar los agregados utilizados en los gráficos (JSON)
Las seis figuras originales se ofrecen sin alterar, con rótulos en portugués, como material documental distinto de las ilustraciones traducidas. T1 muestra tasas por documento; T2, por tipo; T3, cobertura bajo muestreo simple; T4, dos etapas; T5, anchura; T6, autocorrelación. No se publican textos íntegros de la colección ni archivos brutos del experimento.
Figura original T1 (portugués)
Figura original T2 (portugués)

Figura original T3 (portugués)
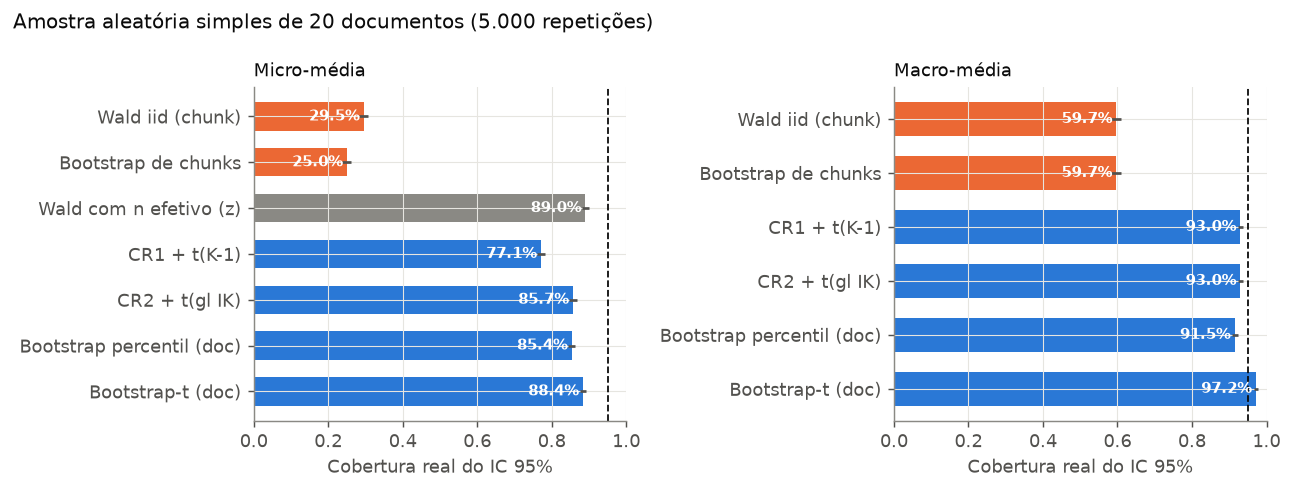
Figura original T4 (portugués)

Figura original T5 (portugués)
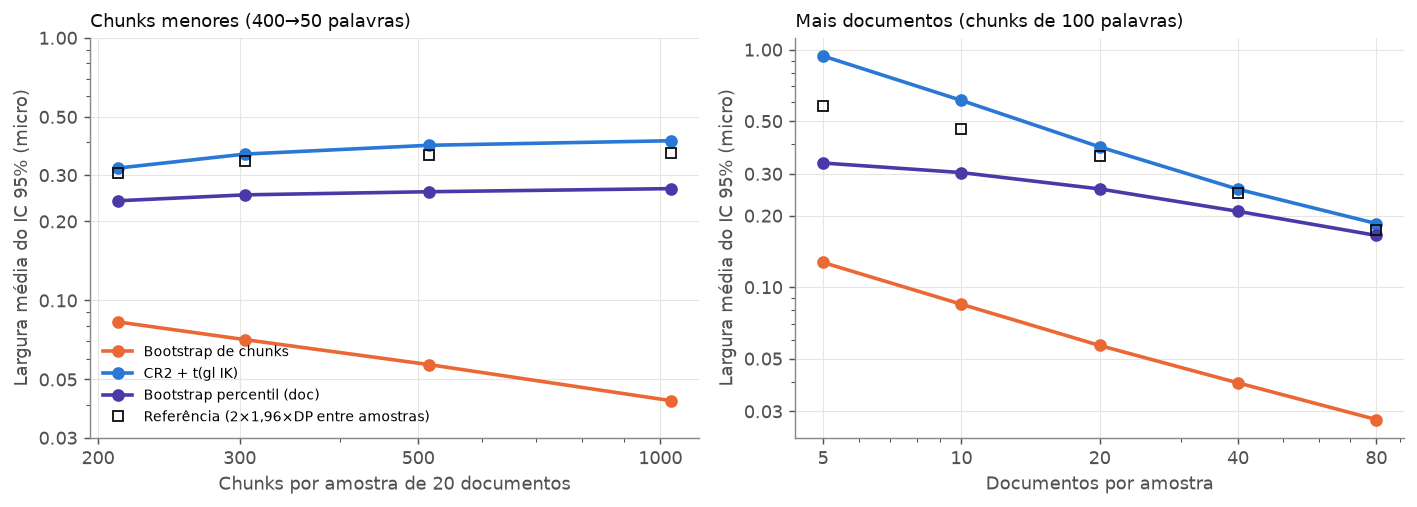
Figura original T6 (portugués)
Agregados adicionales y hashes de las fuentes (JSON)
Revisión metodológica · 11 de octubre de 2026
Realicé los experimentos como Jean M. Estevez Alvarez. Esta revisión distingue los resultados originales de las verificaciones posteriores: conserva los resultados por fragmento y las coberturas originales, corrige las cantidades derivadas y añade 5.000 repeticiones del diseño de dos etapas. No hubo nueva recuperación, entrenamiento ni evaluación en producción.
La selección del RI tuvo dos filtros: hasta 35 candidatos por tipo tras la primera revisión y hasta 25 incluidos tras limpiar y revisar el texto. No repuse automáticamente las exclusiones finales. Los rankings originales usan desempates implícitos y no conservan los candidatos recuperados; por eso no atribuyo cada error a una versión equivocada sin evidencia adicional.
Resultados de la revisión del diseño (JSON)
Field y Welsh (2007): modelos y límites del bootstrap agrupado