RAG regulatorio: del chunk al dispositivo con identidad y vigencia
Parte 2 del caso ANEEL–TAESA: examino los errores de recuperación y qué información necesita un fragmento para distinguir normas y versiones.

En este artículo
En la primera parte, la pregunta era estadística: cuánto se puede confiar en un número calculado sobre miles de fragmentos. Los resultados dejaron también una pregunta práctica. BM25 reconoció el origen de solo el 18,46% de los fragmentos, y 639 de los 1.300 documentos no fueron reconocidos ni una vez. ¿Por qué un buscador se equivoca tanto en un acervo regulatorio, y qué tendría que cambiar en la forma de guardar estos textos para que un RAG responda con la norma correcta?
Una hipótesis es la confusión entre versiones parecidas. Por ejemplo, una consulta sobre una demostración de 2021 podría recuperar la de 2022; este ejemplo es ilustrativo, no un error individual documentado por los CSV. El año se guardó como metadato, pero no se usó como filtro; también podría aparecer en el texto. Antes de atribuir los fallos a la vigencia, necesito conservar y revisar los rankings.
Mi argumento en este artículo es que la calidad de un RAG regulatorio empieza antes del embedding, en lo que se conserva y en cómo se organiza. Primero describo lo que hizo el experimento y lo que no probó. Después, lo que la preparación y el chunking dejaron por el camino. Al final propongo una representación por dispositivo y un plan de pruebas. Las propuestas son mías y todavía no se han validado.
Parte 1: resultados y límites de la evaluación ANEEL–TAESA
Qué probó el experimento y qué quedó fuera
El experimento midió atribución de documento con BM25 y TF-IDF. No implementó segmentación jurídica, resolución de vigencia, búsqueda densa ni generación de respuestas. El 18,46% y los 639 documentos sin aciertos (49,15%) son, por tanto, una señal para investigar versiones y la capacidad de distinguir documentos parecidos. No miden la exactitud de las respuestas ni prueban que toda confusión sea temporal.
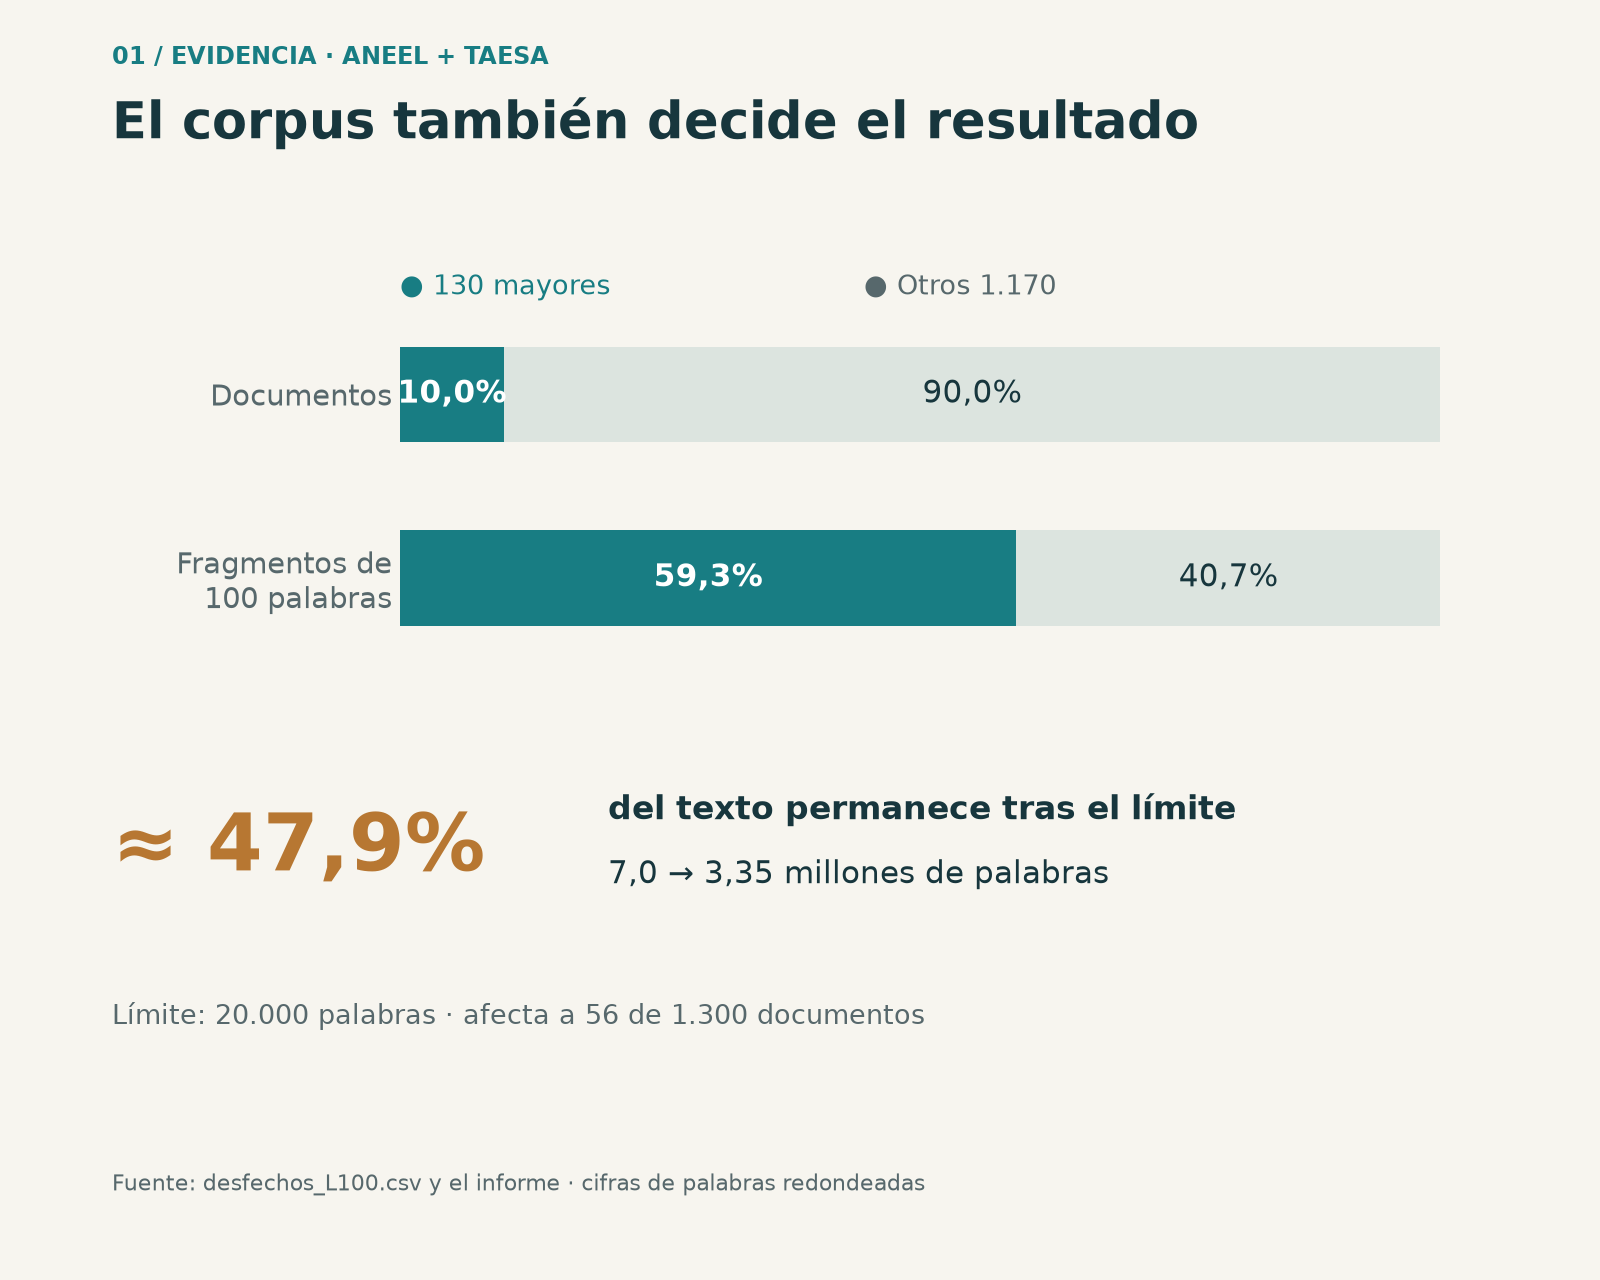
El patrón por tipo de documento apunta en la misma dirección. Los formularios de referencia y las demostraciones anuales, que se repiten con pequeños cambios, quedaron por debajo del 10%. Las resoluciones normativas y los despachos, más singulares, superaron el 40%. Hay otra asimetría en el tamaño: los 130 documentos más grandes concentran casi el 60% de los fragmentos, así que lo que les ocurre pesa mucho en cualquier media.
Chunking: qué se corta y qué se pierde
Chunking es dividir un documento en unidades que el buscador puede indexar y devolver. Parece un detalle de implementación, pero el tamaño decide cuánta información viaja junta. Un fragmento corto aísla bien un concepto y puede separar una condición de su excepción. Uno largo conserva contexto y mezcla asuntos que compiten en la búsqueda. El solapamiento repite parte del texto entre unidades para suavizar los cortes, a costa de duplicación, almacenamiento y contexto redundante.
En el código del estudio, la función fatiar divide el texto por espacios en bloques de 50, 100, 200 o 400 palabras, sin solapamiento. Si el último bloque tiene menos de la mitad del tamaño elegido, se descarta: con bloques de 100, un resto de 49 palabras desaparece. Antes de cortar se aplica un límite de 20.000 palabras por documento, y las primeras 20 palabras de cada bloque forman la consulta. Artículos, incisos y anexos no se detectan. Es una segmentación por longitud, adecuada al objetivo del experimento, y no un parser de dispositivos.
Por eso el estudio tampoco dice qué tamaño de chunk usar en producción. Al cambiar el tamaño cambian las consultas y la propia tarea. Para comparar estrategias de corte habría que fijar las preguntas reales, las evidencias aceptables, el corpus, el presupuesto de contexto y los criterios de evaluación.
Antes del corte: lo que la preparación dejó fuera
Un RAG no recupera lo que nunca entró en el índice, y la preparación del texto decide eso antes de cualquier modelo. El límite de 20.000 palabras afectó solo a 56 documentos, el 4,3% del total. Aun así, redujo el texto de 7,0 a 3,35 millones de palabras, cerca del 52% del volumen (cuentas con cifras redondeadas). Eran sobre todo formularios de referencia y prospectos de hasta 200.000 palabras. Un porcentaje pequeño de documentos puede esconder una pérdida grande de contenido. Antes de subir el top-k o cambiar de modelo, comprobaría si anexos y cláusulas finales quedaron fuera.
La limpieza deja un caso curioso. Para quitar encabezados institucionales se eliminaron las líneas presentes en al menos el 5% de los documentos de una fuente. Entre ellas estaba la fórmula estándar de entrada en vigor («Art. Xº Esta resolución entra en vigor…»), justo la línea que dice cuándo una norma empieza a valer. Para el experimento de atribución, la decisión tiene sentido, porque esa línea es igual en cientos de actos. Para un RAG que tiene que responder sobre vigencia, sería una pérdida seria. La limpieza también excluyó 20 PDF sin OCR y 279 textos con menos de 150 palabras útiles, en su mayoría despachos que, sin el encabezado, se quedaban en pocas líneas.
Son decisiones experimentales razonables que necesitan revisión antes de llegar a producción, porque una disposición breve o repetida puede ser esencial. Conservaría el original, el texto extraído y el limpio, páginas, tablas, unidades, hashes y un registro de exclusiones. Y probaría OCR y extracción de tablas sobre una muestra revisada por personas.
Lo que un fragmento tiene que llevar consigo
Si el problema es que el fragmento llega al modelo sin saber de dónde viene, de cuándo es y de qué depende, la salida es que lleve esa información consigo. En un RAG regulatorio, el documento debería representarse como un conjunto de dispositivos, cada uno con cinco elementos.
| Elemento | Qué preservar |
|---|---|
| Identidad | Identificador estable del acto y del dispositivo; versión separada de su identidad. |
| Jerarquía | Ruta título → capítulo → artículo → párrafo → inciso; padre y orden originales. |
| Relaciones | Modifica, revoca o remite a: destino, alcance y evidencia de la relación. |
| Tiempo | Publicación, inicio y fin de vigencia, periodo de referencia y fecha de incorporación al índice. |
| Procedencia | Fuente, página, posiciones en el texto, hash y estado de revisión; desconocido no significa vigente. |
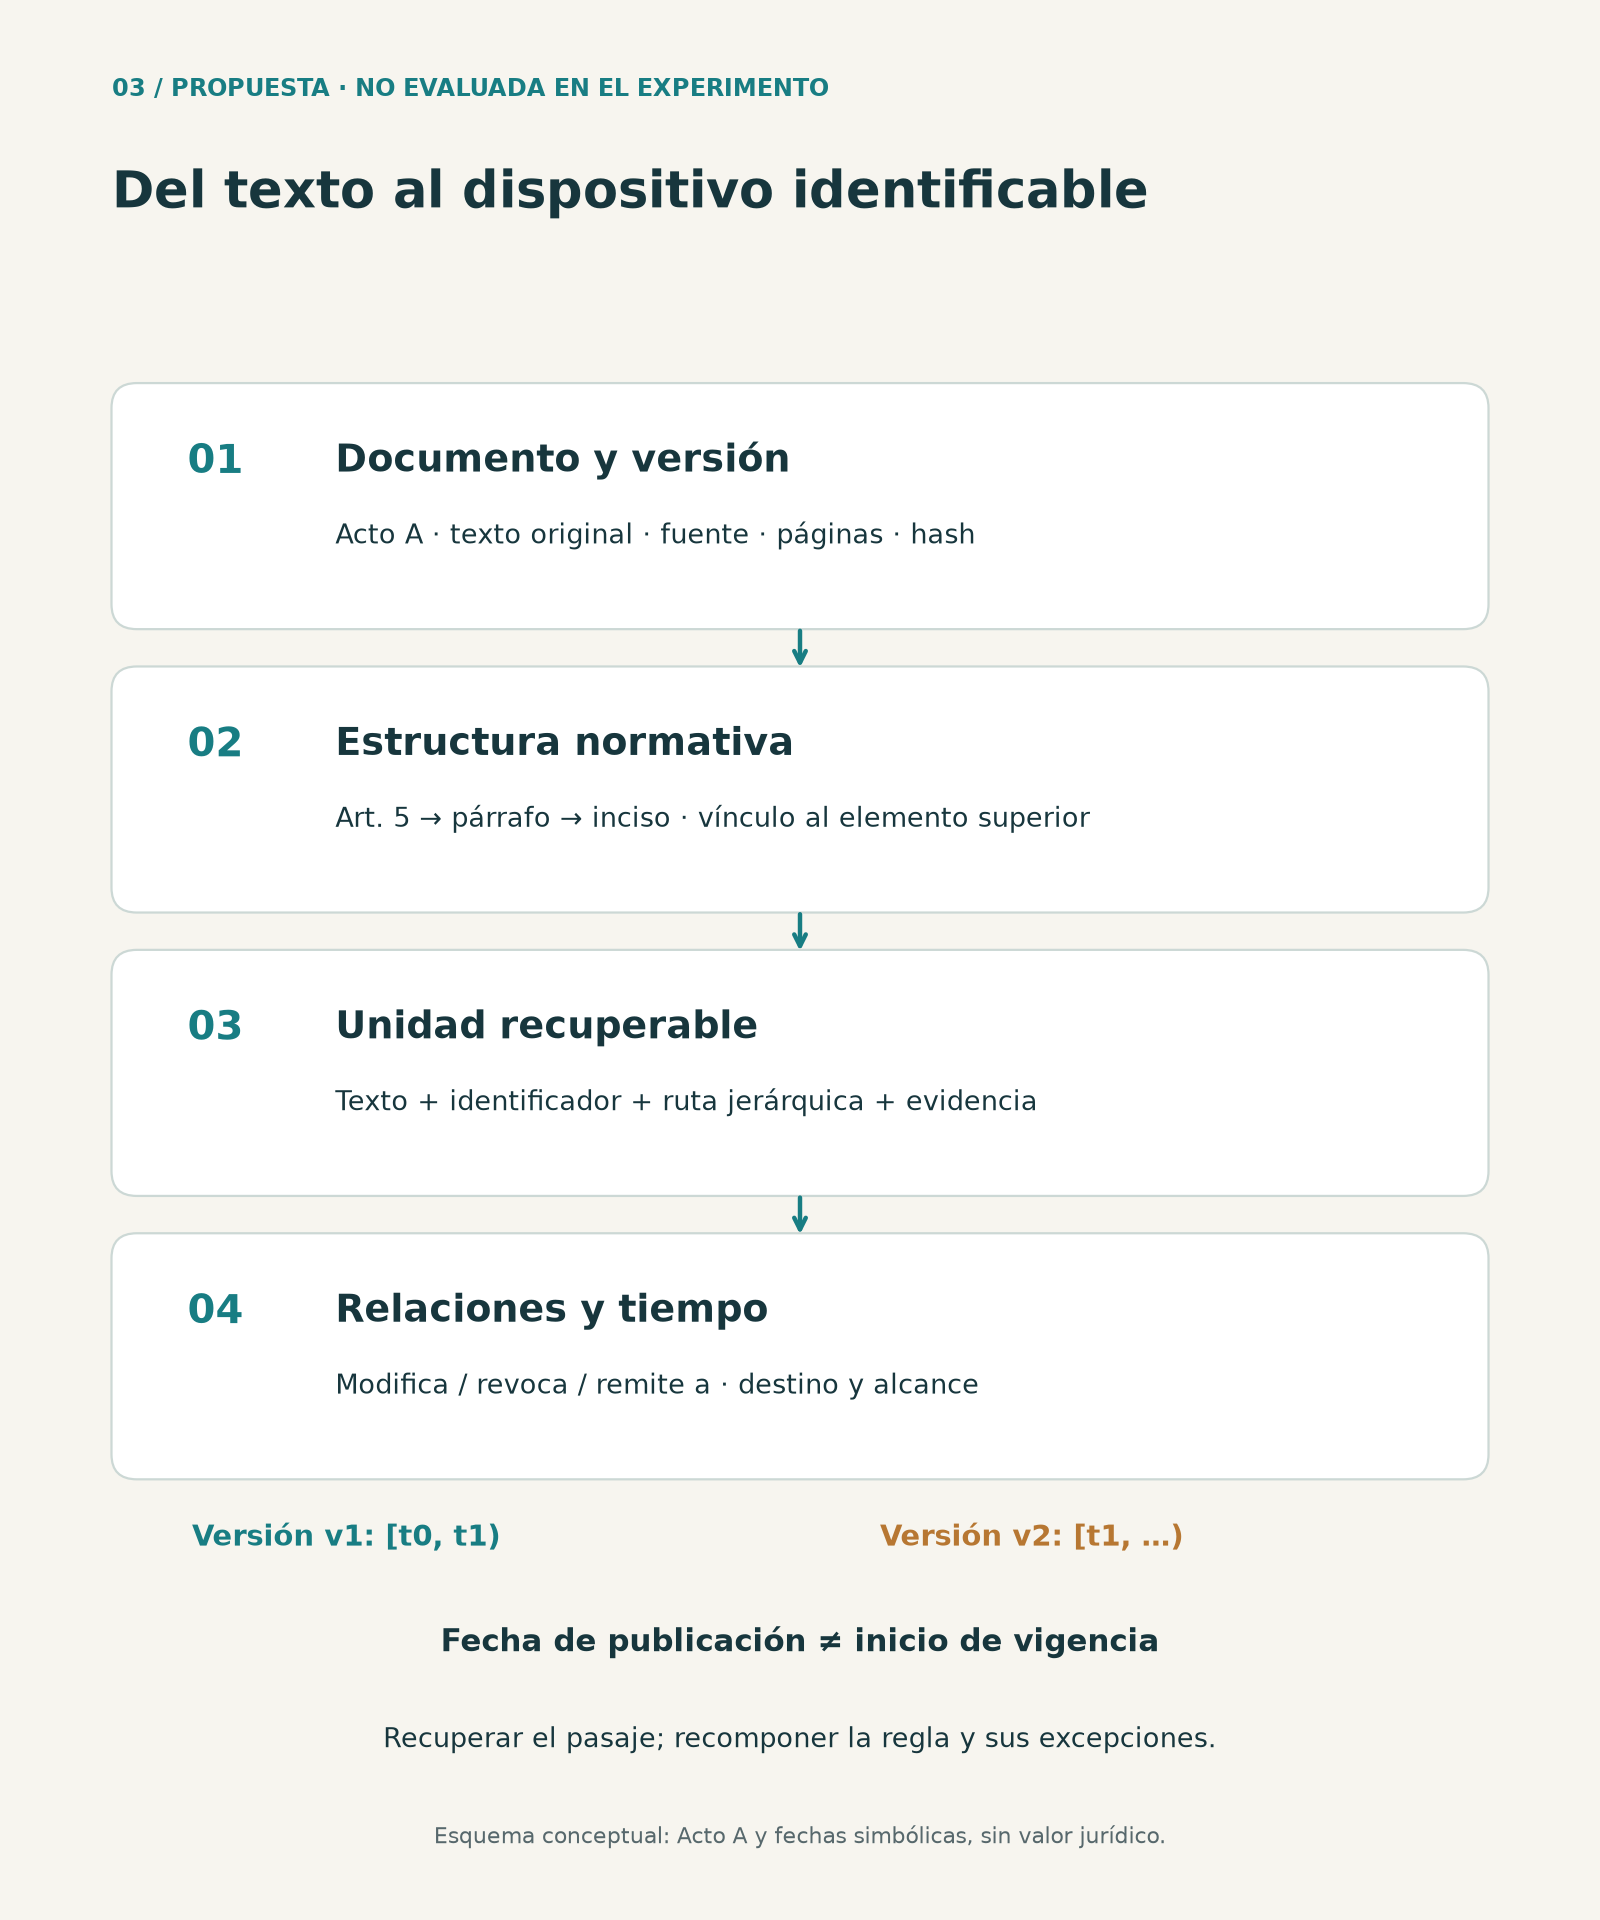
Un ejemplo ficticio ayuda a ver por qué importa cada elemento. El artículo 5 establece una obligación, un párrafo abre una excepción y un acto posterior cambia solo el inciso II. Si el buscador devuelve el inciso sin el encabezado del artículo, el lector no sabe a quién se aplica. Si devuelve el artículo original después de la modificación, muestra una redacción superada. Lo que yo probaría es guardar cada dispositivo con su padre y sus relaciones, recuperar el fragmento pertinente y después ampliar el contexto con la regla, la excepción y la versión aplicable. Una salvedad: la jerarquía del documento no establece por sí sola la jerarquía jurídica entre normas.
Esta forma de modelar no es nueva. Akoma Ntoso, de OASIS, ya trata la identificación, las referencias y el ciclo de vida como parte de la representación de un documento legal. Un piloto no necesita adoptar todo el XML ni una base de grafos: identificadores, tablas de relaciones y metadatos revisados bastan para empezar. Lo que sí exige evidencia y revisión especializada es resolver conflictos, excepciones y modificaciones parciales. Una fecha en un filtro no resuelve por sí sola la aplicabilidad.
OASIS: Akoma Ntoso, vocabulario y ciclo de vida documental
Cortar por la estructura, no por el número de palabras
En la práctica, probaría primero a separar artículos y sus subdivisiones, conservando encabezados y vínculos. Si una unidad no cabe en el presupuesto de tokens, la dividiría por párrafos o frases, siempre con el identificador del dispositivo padre y sin inventar dispositivos jurídicos nuevos. Las tablas necesitan conservar encabezados, unidades y notas; los anexos, sus referencias. El resultado puede combinar unidades pequeñas para localizar y un contexto mayor para responder. El solapamiento queda como variable de prueba, no como sustituto de relaciones explícitas.
Primero la versión correcta; después, la búsqueda híbrida
Mi punto de partida sería BM25 con metadatos fiables: identificador del acto, entidad, tipo, publicación, periodo de referencia, inicio y fin de vigencia cuando se conozcan, y relaciones de modificación o sustitución. Publicación no es lo mismo que vigencia. Una pregunta sobre 2021 no debería seleccionar automáticamente la edición más reciente. Si la fecha es ambigua, el sistema tiene que pedir precisión o decir qué fecha está usando.
Después compararía BM25, búsqueda densa y la combinación de ambas. BM25 es una buena referencia para números de actos y términos exactos; los embeddings pueden ayudar con paráfrasis. La fusión RRF combina posiciones de las listas en lugar de sumar puntuaciones en escalas distintas, y un reranker puede reordenar candidatos antes de generar. Todo esto son hipótesis de mejora, no resultados del informe. BEIR es un buen recordatorio de que los recuperadores se comportan de forma distinta según la tarea.
Cormack, Clarke y Büttcher (2009): Reciprocal Rank Fusion
Thakur et al. (2021): BEIR, evaluación heterogénea de recuperación
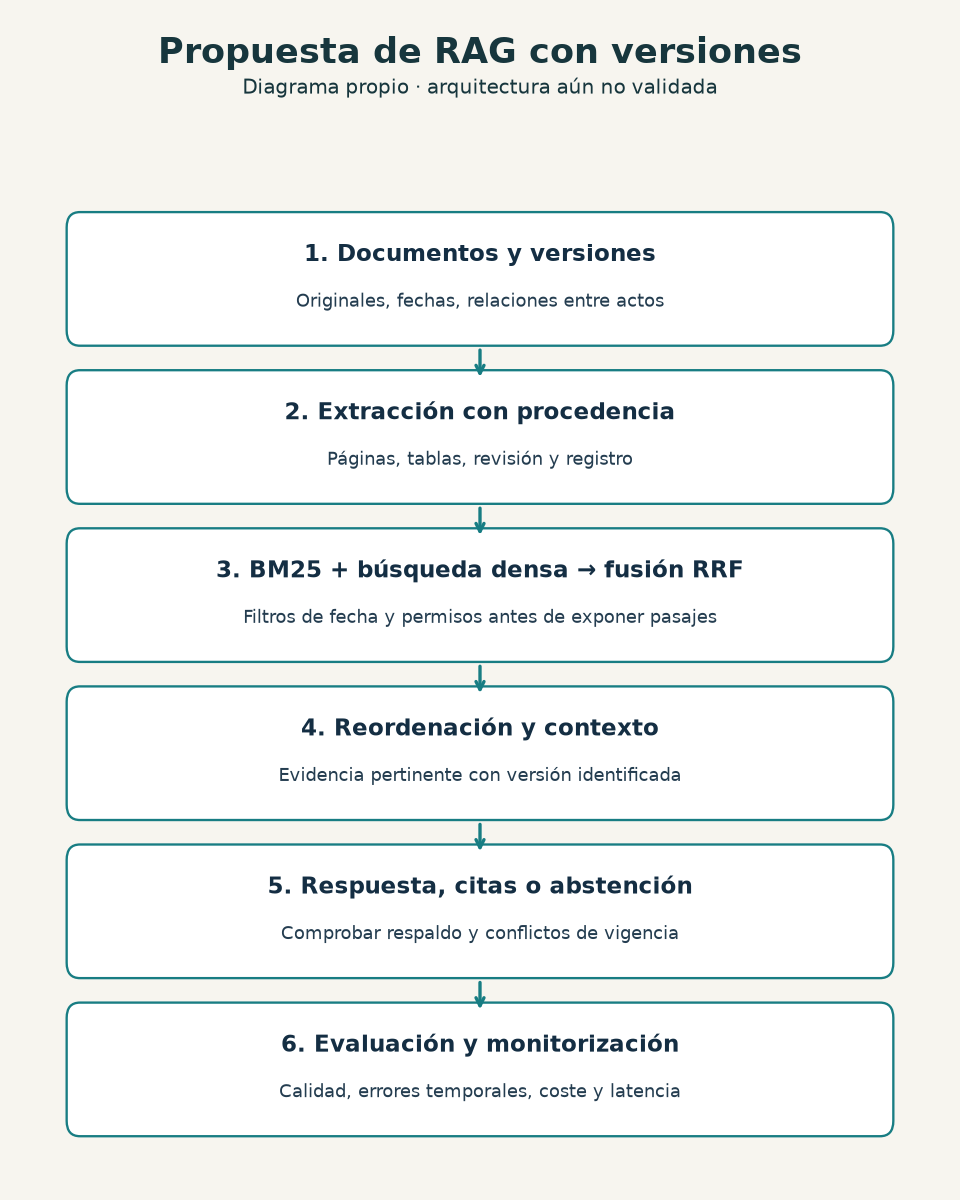
Leído de izquierda a derecha, el flujo conserva documentos y versiones, extrae pasajes con su procedencia, combina recuperación léxica y semántica con filtros de fecha y permisos, reordena candidatos y genera una respuesta con citas que se pueden verificar. Si falta evidencia o hay conflicto de vigencia, el sistema puede abstenerse y derivar la consulta a revisión. La monitorización conecta cada error de respuesta con el pasaje, la versión del índice y la configuración que lo produjeron.
Qué parámetros probaría y cuánto cuestan
Como punto de partida, y no como receta validada, probaría fragmentos por sección de 256 y 512 tokens, solapamiento de 0 y 15%, 20 y 50 candidatos por recuperador y 5 y 10 pasajes después de reordenar. Tokens no son palabras, así que esto no se compara directamente con las 100 palabras del experimento. Intentaría mantener juntos artículos, tablas y encabezados. Cada perilla tiene su precio: más solapamiento aumenta duplicación y almacenamiento; más candidatos y reranking aumentan latencia y coste. Por eso también probaría la versión sin embeddings y sin reranker.
Tampoco enviaría todo el archivo al modelo para compensar una búsqueda deficiente. Lost in the Middle mostró que, en los modelos y tareas estudiados, la posición de la evidencia en el contexto afecta al resultado. Eso no demuestra que todos los modelos actuales fallen igual, pero justifica probar orden, longitud y relevancia del contexto con el modelo que se vaya a usar. Y un contexto mayor sigue sin reparar una extracción que borró la evidencia.
Liu et al. (2024): Lost in the Middle
Un plan de pruebas que pueda cambiar la decisión
Empezaría con un piloto de preguntas reales revisadas por especialistas, incluidas las difíciles: fechas, versiones parecidas, números exactos, tablas, anexos y preguntas sin respuesta. Para cada una guardaría la evidencia aceptable y la justificación de la etiqueta. Separaría entrenamiento, ajuste y prueba final por familias de documentos y por tiempo, porque dividir fragmentos al azar puede dejar casi el mismo texto a los dos lados. El tamaño final de la muestra se decidiría por la precisión necesaria y el riesgo, no por las filas disponibles.
Mediría recuperación y respuesta por separado. Recall@k necesita un conjunto suficientemente completo de evidencias relevantes; MRR mide la posición del primer resultado relevante y nDCG admite relevancia graduada. Sumaría versión correcta, afirmaciones respaldadas por citas, fidelidad, exactitud numérica y abstención apropiada, además de latencia p95 y coste por consulta. Si se usa un juez automático, hay que calibrarlo con personas y auditar los desacuerdos, sobre todo en los errores de mayor impacto.
Las configuraciones se compararían sobre las mismas preguntas, con diferencias pareadas e intervalos que respeten el diseño, como se discutió en la primera parte. En el informe, BM25 superó a TF-IDF por solo 0,62 puntos en la micro-media y 0,27 en la macro, con empate en el 70% de los documentos, y los bootstraps por documento cubrieron entre el 85% y el 89% en esa comparación. El nombre de un método no sustituye a comprobar su calibración. Congelaría versiones de corpus, extractor, segmentación, embeddings, índice, reranker, instrucciones y modelo para poder explicar cada cambio.
Antes de la prueba final acordaría con los usuarios una mejora mínima útil y límites de coste, latencia y errores temporales. Una etapa nueva solo se quedaría si mejora la calidad que importa sin romper esos límites. Si BM25 con filtros empata con el sistema híbrido, me quedaría con lo más simple. Si falta evidencia en el índice, el problema está en la ingestión. Si el generador inventa aun con la evidencia correcta delante, revisaría instrucciones y comportamiento antes de ampliar el índice. Nada de esto se ha validado todavía en producción.
El trabajo de quien analiza los datos no termina en la métrica
Lo que aporta un científico de datos aquí es conectar la pregunta de negocio con la evidencia: definir qué se estima, detectar exclusiones, diseñar la muestra y encontrar el mecanismo del error. En producción, eso incluye vigilar cambios en la distribución de preguntas, documentos desactualizados, fallos de extracción y el coste de reindexar. También comprobar permisos antes de recuperar, tratar las instrucciones que aparecen dentro de los documentos como datos no fiables y probar citas falsas, filtraciones y consultas sin autorización. Una media alta puede esconder un fallo grave en una familia de documentos poco frecuente.
Mi recomendación es empezar por cobertura documental, versiones y una evaluación representativa, y justificar después cada capa adicional. El informe aporta evidencia sólida contra tratar los fragmentos como réplicas independientes, pero no elige una arquitectura ganadora. Me parece un buen límite. Impide que una cifra convincente se convierta en una promesa que el sistema no puede cumplir.
Procedencia y siguiente paso
Fuente: informe revisado, resultados.json y desfechos_L100.csv. La concentración y los 639 documentos sin acierto se calcularon con los resultados guardados. La revisión estadística añadió una verificación del diseño; no evaluó esta arquitectura. Los diagramas siguen siendo propuestas. El próximo estudio debe comparar las representaciones sobre las mismas preguntas antes de añadir búsqueda híbrida.
Agregados adicionales y hashes de las fuentes (JSON)
Revisión metodológica · 11 de octubre de 2026
Realicé los experimentos como Jean M. Estevez Alvarez. Esta revisión distingue los resultados originales de las verificaciones posteriores: conserva los resultados por fragmento y las coberturas originales, corrige las cantidades derivadas y añade 5.000 repeticiones del diseño de dos etapas. No hubo nueva recuperación, entrenamiento ni evaluación en producción.
La selección del RI tuvo dos filtros: hasta 35 candidatos por tipo tras la primera revisión y hasta 25 incluidos tras limpiar y revisar el texto. No repuse automáticamente las exclusiones finales. Los rankings originales usan desempates implícitos y no conservan los candidatos recuperados; por eso no atribuyo cada error a una versión equivocada sin evidencia adicional.
Resultados de la revisión del diseño (JSON)
Field y Welsh (2007): modelos y límites del bootstrap agrupado