RAG regulatório: do chunk ao dispositivo com identidade e vigência
Parte 2 do caso ANEEL–TAESA: examino os erros de recuperação e as informações que um trecho precisa carregar para distinguir normas e versões.

Neste artigo
Na primeira parte, a pergunta era estatística: quanto se pode confiar num número calculado sobre milhares de trechos. Os resultados também deixaram uma pergunta prática. O BM25 reconheceu a origem de apenas 18,46% dos trechos, e 639 dos 1.300 documentos não foram reconhecidos nenhuma vez. Por que um buscador erra tanto num acervo regulatório, e o que precisaria mudar na forma de guardar esses textos para que um RAG responda com a norma certa?
Uma hipótese é a confusão entre versões parecidas. Por exemplo, uma consulta sobre uma demonstração de 2021 poderia recuperar a de 2022; esse exemplo é ilustrativo, não um erro individual documentado pelos CSVs. O ano foi guardado como metadado, mas não usado como filtro; também poderia aparecer no texto. Antes de atribuir as falhas à vigência, preciso preservar e revisar os rankings.
Meu argumento neste artigo é que a qualidade de um RAG regulatório começa antes do embedding, no que se preserva e em como isso é organizado. Primeiro descrevo o que o experimento fez e o que ele não testou. Depois, o que a preparação e o chunking deixaram pelo caminho. No fim, proponho uma representação por dispositivo e um plano de testes. As propostas são minhas e ainda não foram validadas.
Parte 1: resultados e limites da avaliação ANEEL–TAESA
O que o experimento testou e o que ficou de fora
O experimento mediu atribuição de documento com BM25 e TF-IDF. Não implementou segmentação jurídica, resolução de vigência, busca densa nem geração de respostas. Os 18,46% e os 639 documentos sem acerto (49,15%) são, portanto, um sinal para investigar versões e a capacidade de distinguir documentos parecidos. Não medem a exatidão das respostas nem provam que toda confusão seja temporal.
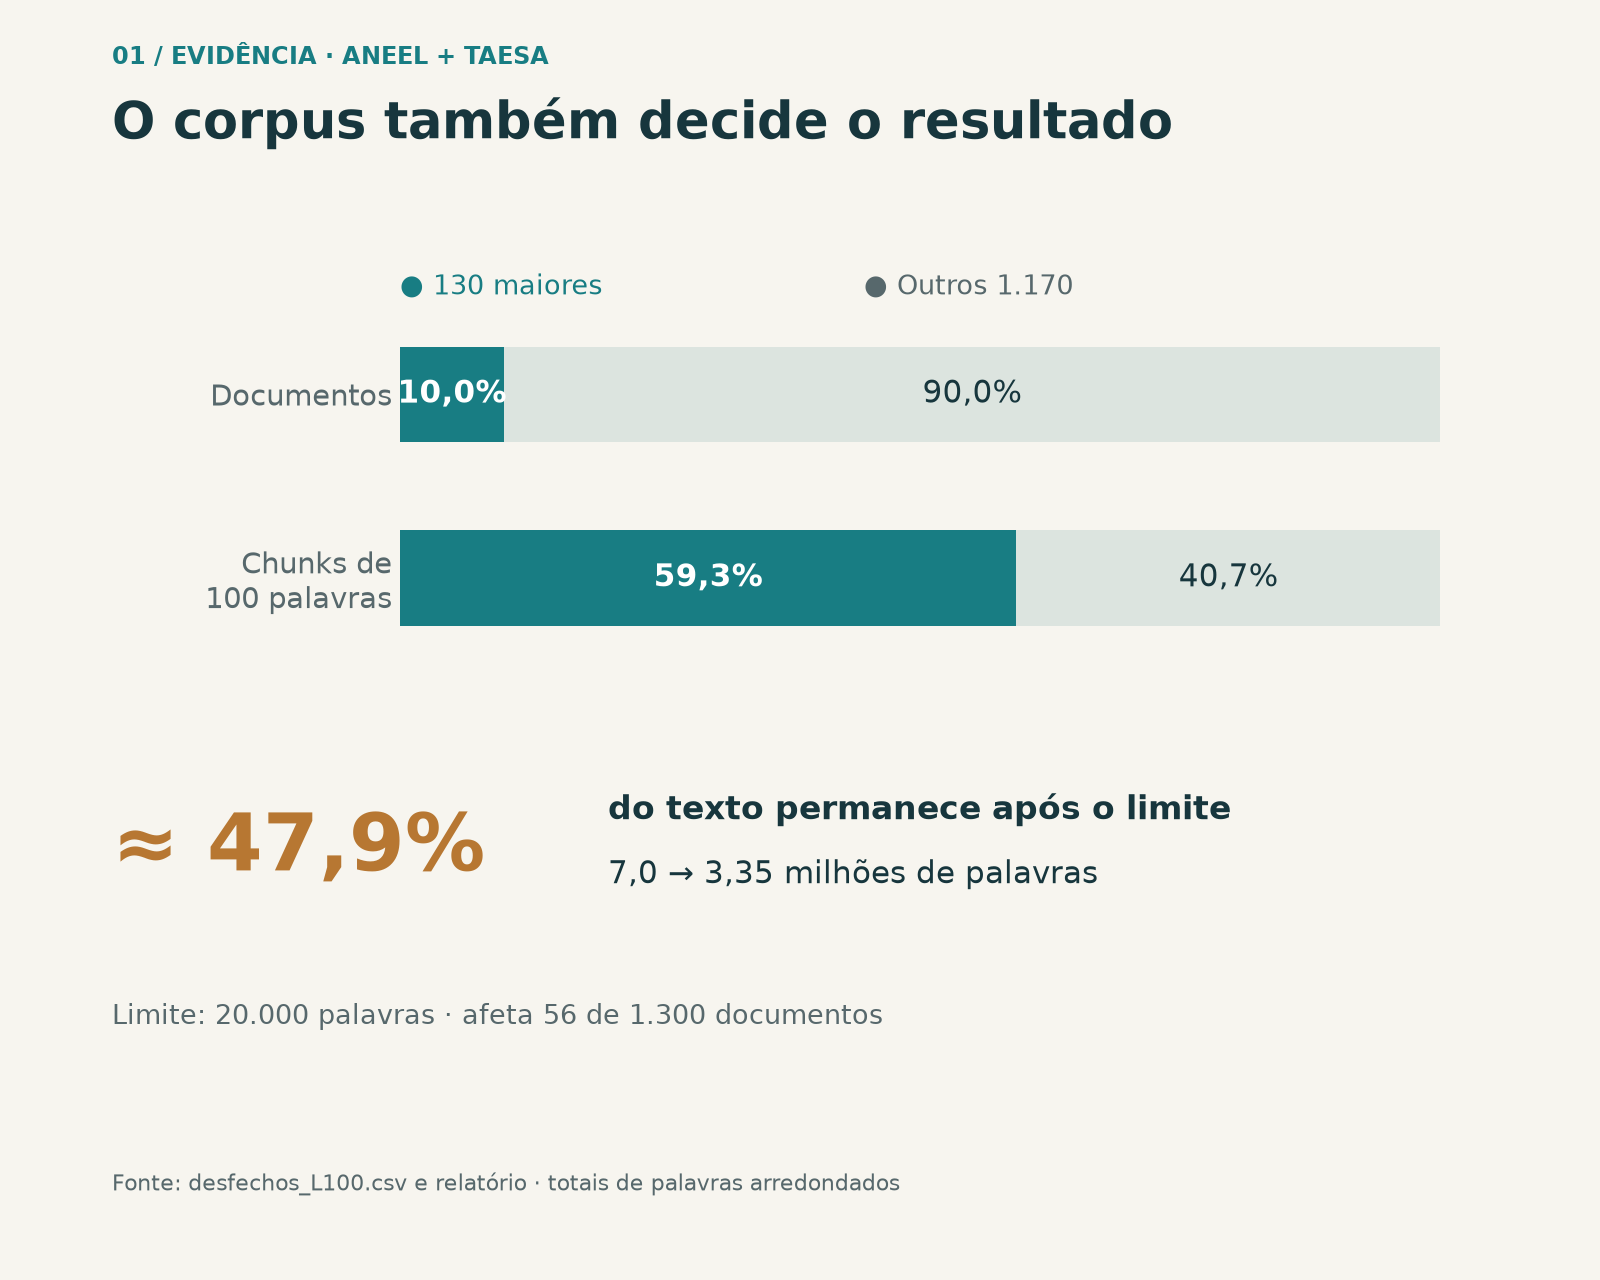
O padrão por tipo de documento aponta na mesma direção. Formulários de referência e demonstrações anuais, que se repetem com pequenas mudanças, ficaram abaixo de 10%. Resoluções normativas e despachos, mais singulares, passaram de 40%. Há outra assimetria no tamanho: os 130 maiores documentos concentram quase 60% dos trechos, então o que acontece com eles pesa muito em qualquer média.
Chunking: o que se corta e o que se perde
Chunking é dividir um documento em unidades que o buscador consegue indexar e devolver. Parece um detalhe de implementação, mas o tamanho decide quanta informação viaja junta. Um trecho curto isola bem um conceito e pode separar uma condição da sua exceção. Um trecho longo preserva contexto e mistura assuntos que competem na busca. A sobreposição repete parte do texto entre unidades para suavizar os cortes, ao custo de duplicação, armazenamento e contexto redundante.
No código do estudo, a função fatiar divide o texto por espaços em blocos de 50, 100, 200 ou 400 palavras, sem sobreposição. Se o último bloco tiver menos da metade do tamanho escolhido, ele é descartado: com blocos de 100, um resto de 49 palavras some. Antes do corte é aplicado um teto de 20.000 palavras por documento, e as primeiras 20 palavras de cada bloco formam a consulta. Artigos, incisos e anexos não são detectados. É uma segmentação por comprimento, adequada ao objetivo do experimento, e não um parser de dispositivos.
Por isso o estudo também não diz qual tamanho de chunk usar em produção. Ao mudar o tamanho, mudam as consultas e a própria tarefa. Para comparar estratégias de corte, seria preciso manter fixos as perguntas reais, as evidências aceitáveis, o corpus, o orçamento de contexto e os critérios de avaliação.
Antes do corte: o que a preparação deixou de fora
Um RAG não recupera o que nunca entrou no índice, e a preparação do texto decide isso antes de qualquer modelo. O teto de 20.000 palavras afetou só 56 documentos, 4,3% do total. Mesmo assim, reduziu o texto de 7,0 para 3,35 milhões de palavras, cerca de 52% do volume (contas com números arredondados). Eram sobretudo formulários de referência e prospectos com até 200 mil palavras. Uma porcentagem pequena de documentos pode esconder uma perda grande de conteúdo. Antes de aumentar o top-k ou trocar de modelo, eu verificaria se anexos e cláusulas finais ficaram de fora.
A limpeza traz um caso curioso. Para tirar cabeçalhos institucionais, foram removidas as linhas presentes em pelo menos 5% dos documentos de uma fonte. Entre elas estava a fórmula padrão de entrada em vigor ("Art. Xº Esta resolução entra em vigor..."), justamente a linha que diz quando uma norma passa a valer. Para o experimento de atribuição, a decisão faz sentido, porque essa linha é igual em centenas de atos. Para um RAG que precisa responder sobre vigência, seria uma perda séria. A limpeza também excluiu 20 PDFs sem OCR e 279 textos com menos de 150 palavras úteis, a maioria despachos que, sem o cabeçalho, ficavam com poucas linhas.
São escolhas experimentais razoáveis que precisam de revisão antes de chegar à produção, porque uma disposição curta ou repetida pode ser essencial. Eu guardaria o original, o texto extraído e o limpo, páginas, tabelas, unidades, hashes e um registro de exclusões. E testaria OCR e extração de tabelas numa amostra revisada por pessoas.
O que um trecho precisa levar consigo
Se o problema é que o trecho chega ao modelo sem saber de onde vem, de quando é e do que depende, a saída é fazê-lo levar essa informação consigo. Num RAG regulatório, o documento deveria ser representado como um conjunto de dispositivos, cada um com cinco elementos.
| Elemento | O que preservar |
|---|---|
| Identidade | Identificador estável do ato e do dispositivo; versão separada da identidade. |
| Hierarquia | Caminho título → capítulo → artigo → parágrafo → inciso; pai e ordem originais. |
| Relações | Altera, revoga ou remete a: destino, alcance e evidência da relação. |
| Tempo | Publicação, início e fim de vigência, período de referência e data de incorporação ao índice. |
| Proveniência | Fonte, página, posições no texto, hash e estado de revisão; desconhecido não significa vigente. |
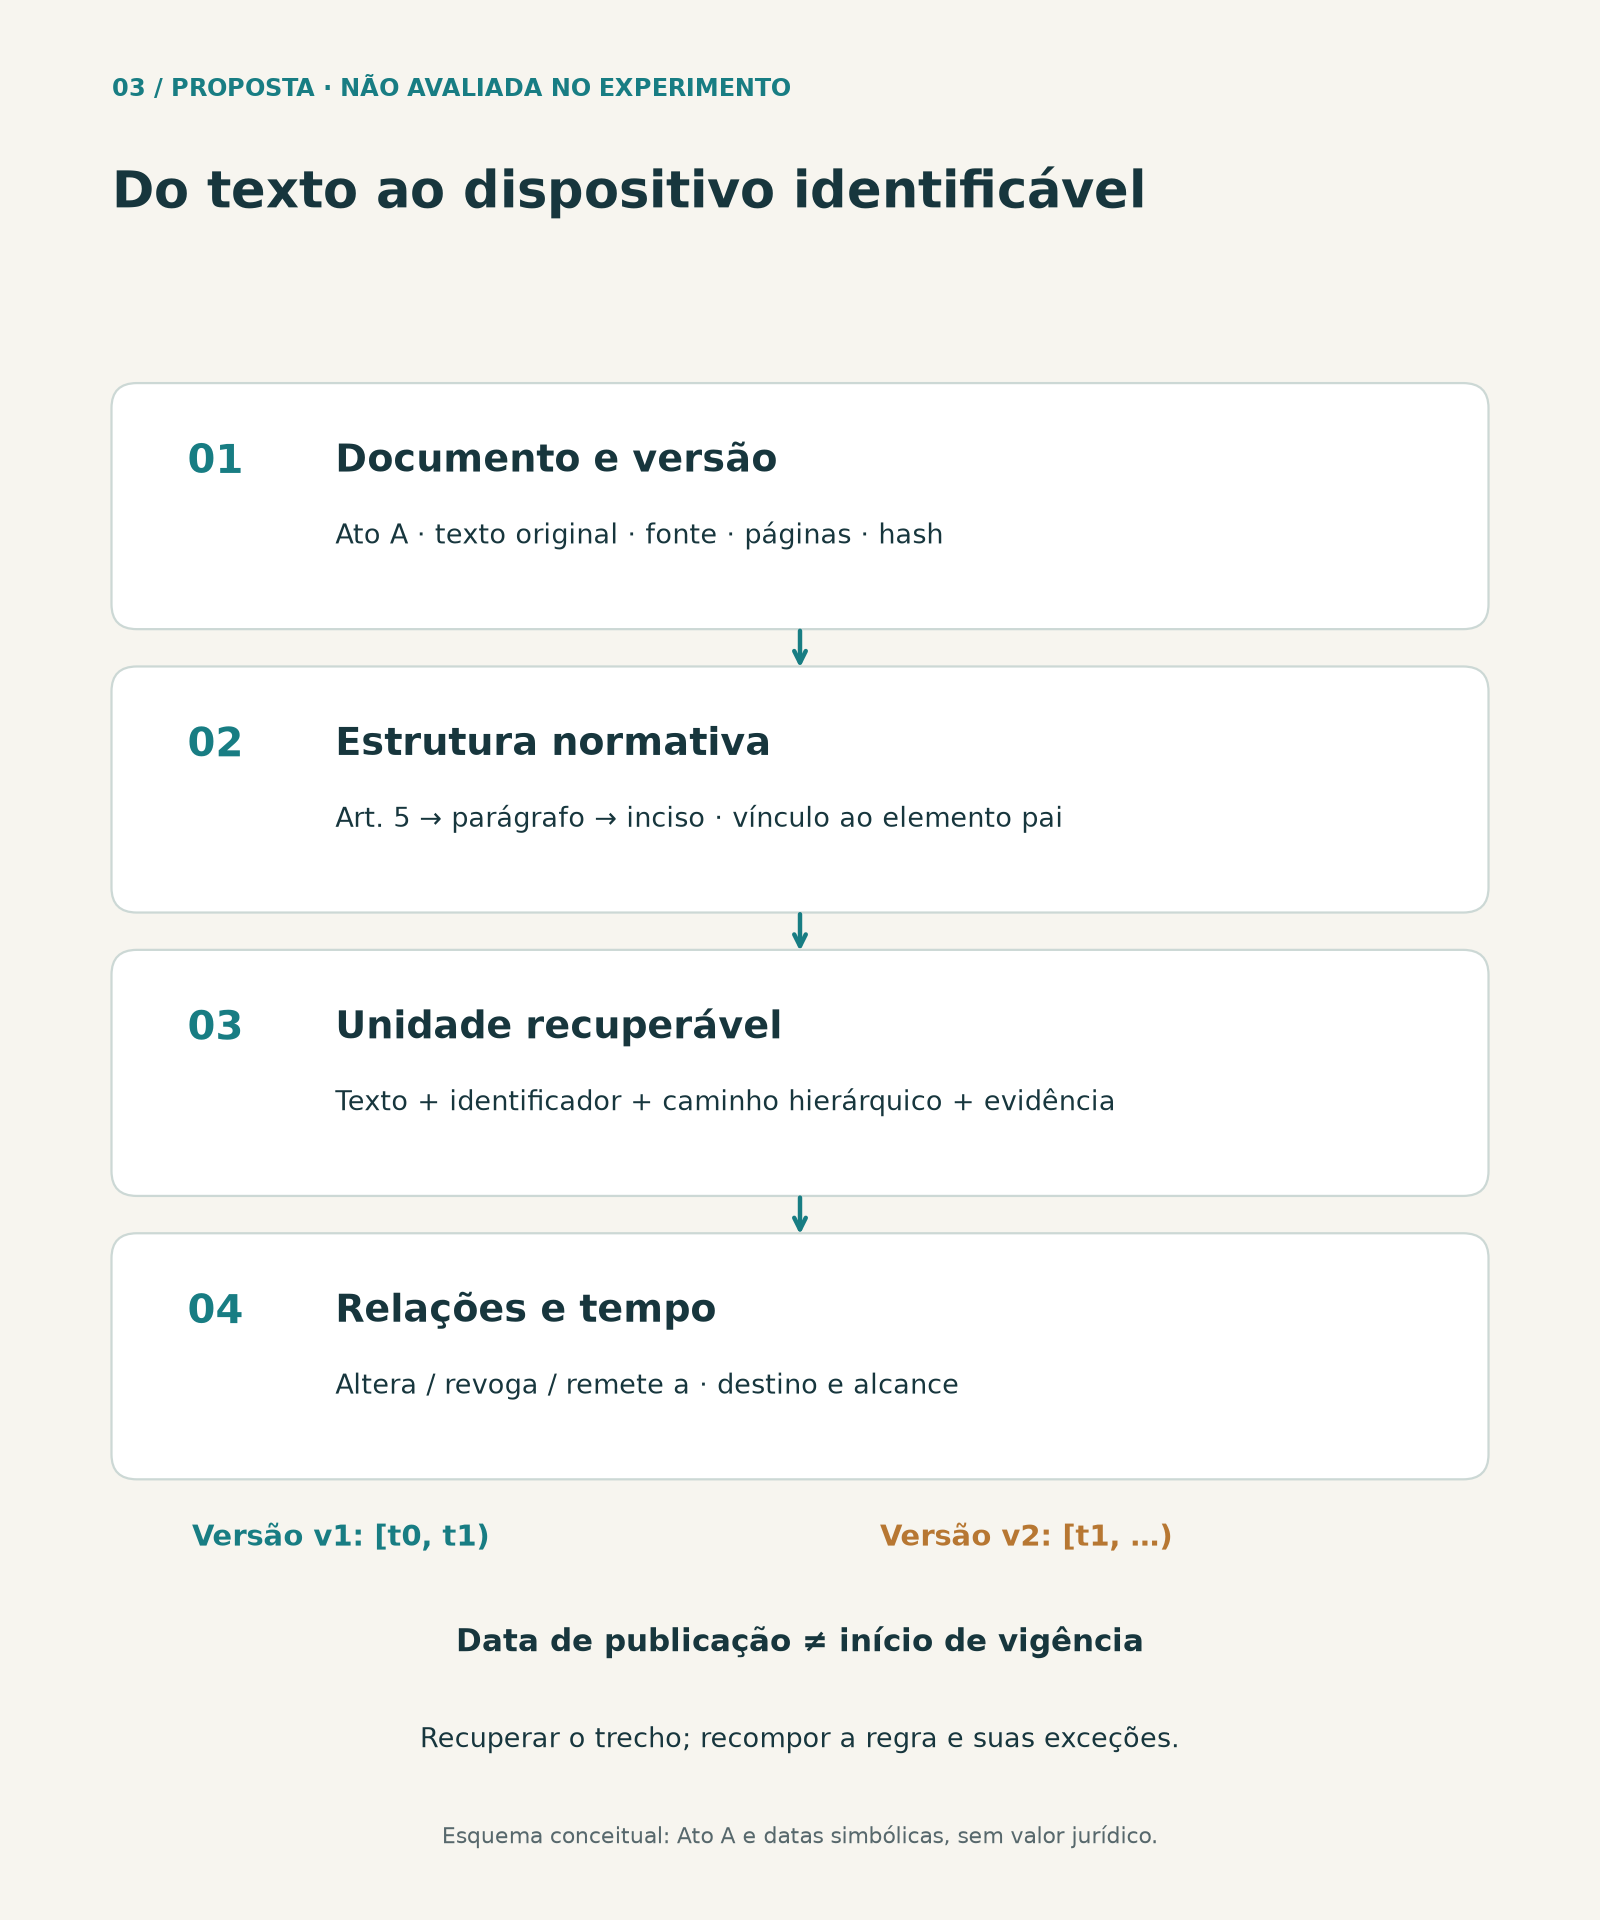
Um exemplo fictício ajuda a ver por que cada elemento importa. O artigo 5 estabelece uma obrigação, um parágrafo abre uma exceção e um ato posterior muda apenas o inciso II. Se o buscador devolve o inciso sem o caput, o leitor não sabe a quem ele se aplica. Se devolve o artigo original depois da alteração, mostra uma redação superada. O que eu testaria é guardar cada dispositivo com seu pai e suas relações, recuperar o trecho pertinente e depois ampliar o contexto com a regra, a exceção e a versão aplicável. Uma ressalva: a hierarquia do documento não estabelece, sozinha, a hierarquia jurídica entre normas.
Essa forma de modelar não é nova. O Akoma Ntoso, da OASIS, já trata identificação, referências e ciclo de vida como parte da representação de um documento legal. Um piloto não precisa adotar todo o XML nem um banco de grafos: identificadores, tabelas de relações e metadados revisados bastam para começar. O que exige evidência e revisão especializada é resolver conflitos, exceções e alterações parciais. Uma data num filtro não resolve, sozinha, a aplicabilidade.
OASIS: Akoma Ntoso, vocabulário e ciclo de vida documental
Cortar pela estrutura, não pela contagem de palavras
Na prática, eu testaria primeiro separar artigos e suas subdivisões, preservando cabeçalhos e vínculos. Se uma unidade não couber no orçamento de tokens, eu a dividiria por parágrafos ou frases, sempre com o identificador do dispositivo pai e sem inventar dispositivos jurídicos novos. Tabelas precisam preservar cabeçalhos, unidades e notas; anexos, suas referências. O resultado pode combinar unidades pequenas para localizar e um contexto maior para responder. A sobreposição fica como variável de teste, não como substituta de relações explícitas.
Primeiro a versão certa; depois, a busca híbrida
Meu ponto de partida seria BM25 com metadados confiáveis: identificador do ato, entidade, tipo, publicação, período de referência, início e fim de vigência quando conhecidos e relações de alteração ou substituição. Publicação não é a mesma coisa que vigência. Uma pergunta sobre 2021 não deveria selecionar automaticamente a edição mais recente. Se a data for ambígua, o sistema precisa pedir precisão ou dizer qual data está usando.
Depois eu compararia BM25, busca densa e a combinação das duas. O BM25 é uma boa referência para números de atos e termos exatos; embeddings podem ajudar com paráfrases. A fusão RRF combina posições das listas em vez de somar pontuações em escalas distintas, e um reranker pode reordenar candidatos antes da geração. Tudo isso são hipóteses de melhoria, não resultados do relatório. O BEIR é um bom lembrete de que recuperadores se comportam de forma diferente conforme a tarefa.
Cormack, Clarke e Büttcher (2009): Reciprocal Rank Fusion
Thakur et al. (2021): BEIR, avaliação heterogênea de recuperação
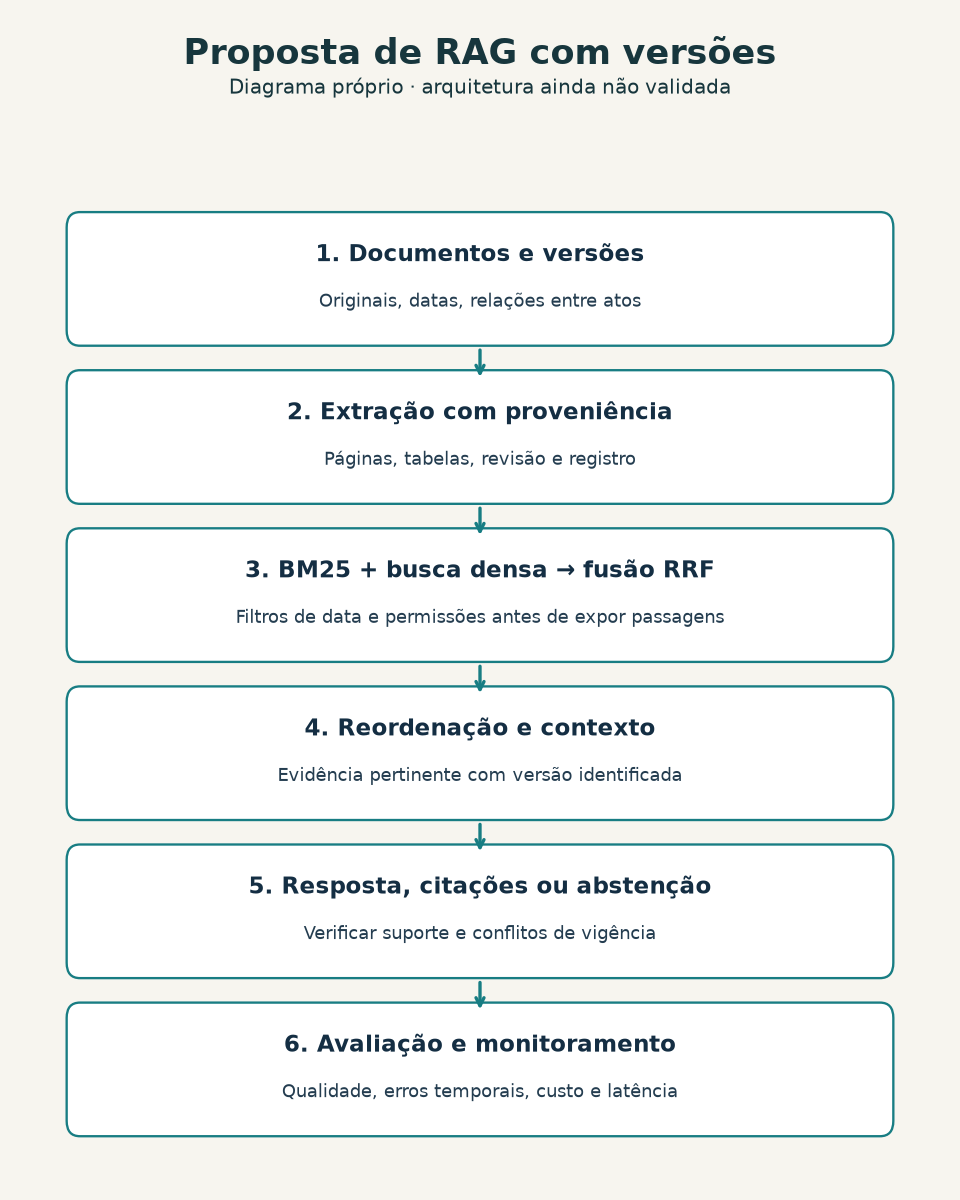
Lido da esquerda para a direita, o fluxo preserva documentos e versões, extrai passagens com sua proveniência, combina recuperação lexical e semântica com filtros de data e permissões, reordena candidatos e gera uma resposta com citações que podem ser verificadas. Se faltar evidência ou houver conflito de vigência, o sistema pode se abster e encaminhar a consulta para revisão. O monitoramento liga cada erro de resposta à passagem, à versão do índice e à configuração que o produziram.
Quais parâmetros eu testaria e quanto custam
Como ponto de partida, e não como receita validada, eu testaria trechos por seção de 256 e 512 tokens, sobreposição de 0 e 15%, 20 e 50 candidatos por recuperador e 5 e 10 passagens depois de reordenar. Tokens não são palavras, então isso não se compara diretamente com as 100 palavras do experimento. Tentaria manter juntos artigos, tabelas e cabeçalhos. Cada ajuste tem seu preço: mais sobreposição aumenta duplicação e armazenamento; mais candidatos e reranking aumentam latência e custo. Por isso eu também testaria a versão sem embeddings e sem reranker.
Eu também não enviaria todo o acervo ao modelo para compensar uma busca deficiente. O Lost in the Middle mostrou que, nos modelos e tarefas estudados, a posição da evidência no contexto afeta o resultado. Isso não demonstra que todos os modelos atuais falhem igual, mas justifica testar ordem, comprimento e relevância do contexto com o modelo que será usado. E um contexto maior continua sem reparar uma extração que apagou a evidência.
Liu et al. (2024): Lost in the Middle
Um plano de testes capaz de mudar a decisão
Eu começaria com um piloto de perguntas reais revisadas por especialistas, incluindo as difíceis: datas, versões parecidas, números exatos, tabelas, anexos e perguntas sem resposta. Para cada uma, guardaria a evidência aceitável e a justificativa do rótulo. Separaria treinamento, ajuste e teste final por famílias de documentos e por tempo, porque dividir trechos aleatoriamente pode deixar quase o mesmo texto dos dois lados. O tamanho final da amostra seria decidido pela precisão necessária e pelo risco, não pelas linhas disponíveis.
Eu mediria recuperação e resposta separadamente. Recall@k exige um conjunto suficientemente completo de evidências relevantes; MRR mede a posição do primeiro resultado relevante e nDCG admite relevância graduada. Somaria versão correta, afirmações sustentadas por citações, fidelidade, exatidão numérica e abstenção apropriada, além de latência p95 e custo por consulta. Se houver um juiz automático, ele precisa ser calibrado com pessoas e ter as discordâncias auditadas, sobretudo nos erros de maior impacto.
As configurações seriam comparadas nas mesmas perguntas, com diferenças pareadas e intervalos que respeitem o desenho, como discutido na primeira parte. No relatório, o BM25 superou o TF-IDF por apenas 0,62 ponto na micro-média e 0,27 na macro, com empate em 70% dos documentos, e os bootstraps por documento cobriram entre 85% e 89% nessa comparação. O nome de um método não substitui verificar sua calibração. Eu congelaria versões de corpus, extrator, segmentação, embeddings, índice, reranker, instruções e modelo para conseguir explicar cada mudança.
Antes do teste final, eu combinaria com os usuários uma melhoria mínima útil e limites de custo, latência e erros temporais. Uma etapa nova só ficaria se melhorasse a qualidade que importa sem romper esses limites. Se o BM25 com filtros empatar com o sistema híbrido, eu ficaria com o mais simples. Se faltar evidência no índice, o problema está na ingestão. Se o gerador inventar mesmo com a evidência certa à frente, eu revisaria instruções e comportamento antes de ampliar o índice. Nada disso foi validado ainda em produção.
O trabalho de quem analisa os dados não termina na métrica
O que um cientista de dados contribui aqui é ligar a pergunta de negócio à evidência: definir o que se estima, detectar exclusões, desenhar a amostra e encontrar o mecanismo do erro. Em produção, isso inclui acompanhar mudanças na distribuição das perguntas, documentos desatualizados, falhas de extração e o custo de reindexar. Também verificar permissões antes de recuperar, tratar instruções que aparecem dentro dos documentos como dados não confiáveis e testar citações falsas, vazamentos e consultas sem autorização. Uma média alta pode esconder uma falha grave numa família de documentos pouco frequente.
Minha recomendação é começar por cobertura documental, versões e uma avaliação representativa, e só depois justificar cada camada adicional. O relatório traz evidência sólida contra tratar trechos como réplicas independentes, mas não escolhe uma arquitetura vencedora. Acho esse limite saudável. Ele impede que um número convincente vire uma promessa que o sistema não consegue cumprir.
Proveniência e próximo passo
Fonte: relatório revisado, resultados.json e desfechos_L100.csv. A concentração e os 639 documentos sem acerto foram calculados com os resultados salvos. A revisão estatística acrescentou uma verificação do desenho; não avaliou esta arquitetura. Os diagramas continuam sendo propostas. O próximo estudo deve comparar as representações nas mesmas perguntas antes de acrescentar busca híbrida.
Agregados adicionais e hashes das fontes (JSON)
Revisão metodológica · 11 de outubro de 2026
Os experimentos são de minha autoria, Jean M. Estevez Alvarez. Esta revisão distingue os resultados originais das verificações posteriores: preserva os desfechos e coberturas originais, corrige as quantidades derivadas e acrescenta 5.000 repetições do desenho de dois estágios. Não houve nova recuperação, treinamento ou avaliação em produção.
A seleção do RI teve dois filtros: até 35 candidatos por tipo após a primeira triagem e até 25 incluídos depois da limpeza e revisão do texto. Não houve reposição automática das exclusões finais. Os rankings originais usam desempates implícitos e não preservam os candidatos recuperados; por isso não atribuo cada erro a uma versão incorreta sem evidência adicional.
Resultados da revisão do desenho (JSON)
Field e Welsh (2007): modelos e limites do bootstrap agrupado