33.503 chunks não são 33.503 provas: resultados do caso ANEEL–TAESA
Parte 1 do caso ANEEL–TAESA: ao tratar trechos como provas independentes, um intervalo nominal de 95% cobriu o valor real em apenas 29,5% das repetições. Aqui explico o experimento.

Neste artigo
Quem avalia um sistema de busca sobre documentos costuma seguir uma receita conhecida: corta os textos em trechos, transforma cada trecho em uma consulta e conta quantas vezes o sistema encontra a origem certa. Com 20 documentos saem algumas centenas de provas; com todo o acervo da ANEEL e da TAESA que analiso aqui, 33.503. Tantas provas dão a sensação de uma medida firme, com margem de erro de poucos pontos percentuais.
A pergunta que guia este artigo é simples de formular: essa margem de erro é verdadeira? Se eu digo que o sistema acerta 18% das vezes, com uma margem de uns três pontos para cima ou para baixo, quanto posso confiar nesse intervalo?
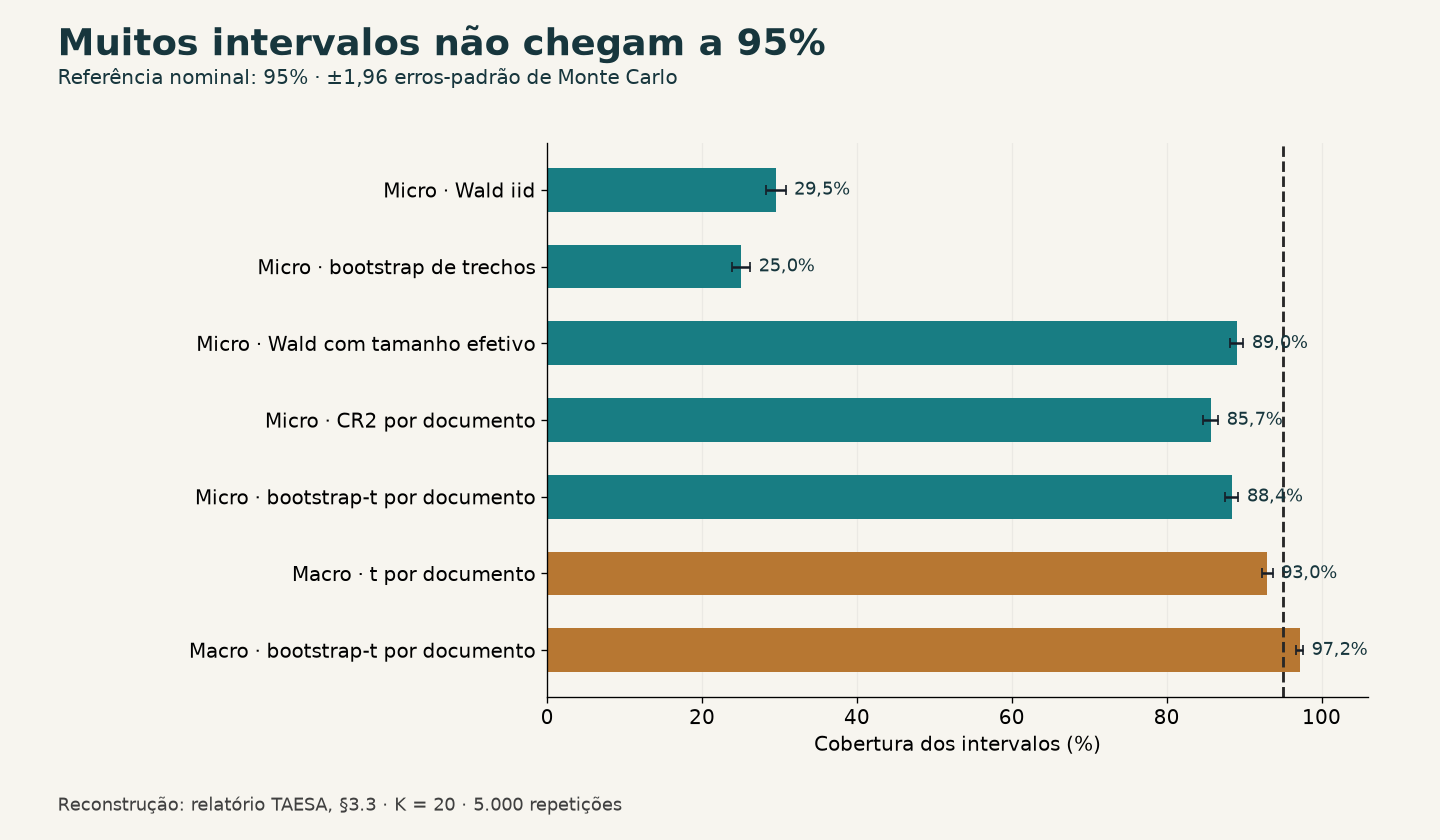
Normalmente não há como verificar, porque não conhecemos o valor real. Neste estudo, conhecemos. O resultado dos 33.503 trechos foi calculado uma única vez e a taxa de acerto do acervo inteiro ficou registrada. Isso permitiu repetir 5.000 vezes o que um avaliador faria na prática: sortear 20 documentos, medir, calcular um intervalo de 95% e conferir se ele contém o valor real. Um intervalo de 95% honesto acertaria em cerca de 95% das repetições. O método mais comum, que trata cada trecho como uma prova independente, acertou em 29,5%.
Em outras palavras: sete em cada dez intervalos prometiam uma precisão que não existia. Nesta primeira parte conto como a prova foi montada, por que a suposição de independência falha em um acervo regulatório e o que muda quando a unidade contada passa a ser o documento. Trabalho com resultados já calculados do experimento, sem nova execução e sem avaliar respostas em produção. A segunda parte usa esses achados para discutir como preparar e cortar os textos de um RAG regulatório.
Parte 2: chunking, dispositivos e vigência
Como a prova foi montada
O acervo reúne 1.300 documentos: 931 atos da ANEEL, como resoluções, despachos e portarias, e 369 documentos de relações com investidores da TAESA, como ITRs, fatos relevantes e ratings. É o tipo de material que um assistente de IA da empresa teria de consultar. Algumas decisões de composição pesam no resultado. Quando um ato existia como resumo e como texto integral, ficou só o integral. Os textos do DOU saíram porque repetiam os PDFs oficiais. E do RI, que sozinho somava cerca de 14 milhões de palavras, foram sorteados até 25 documentos válidos por tipo, com semente fixa. Não é um censo do acervo nem uma amostra das perguntas que os usuários fariam.
A tarefa dispensa rótulos humanos. Cada documento foi dividido em trechos de 100 palavras. As primeiras 20 palavras de cada trecho viram a consulta, o BM25 busca no índice com todos os outros trechos e a prova conta como acerto se o primeiro resultado vier do mesmo documento. É um jeito barato e objetivo de perguntar: o buscador reconhece de onde veio este pedaço de texto? Documentos com um único trecho ficaram de fora, porque neles acertar é impossível: o único trecho certo é justamente o que foi excluído da busca.
O que 18% diz, e o que não diz
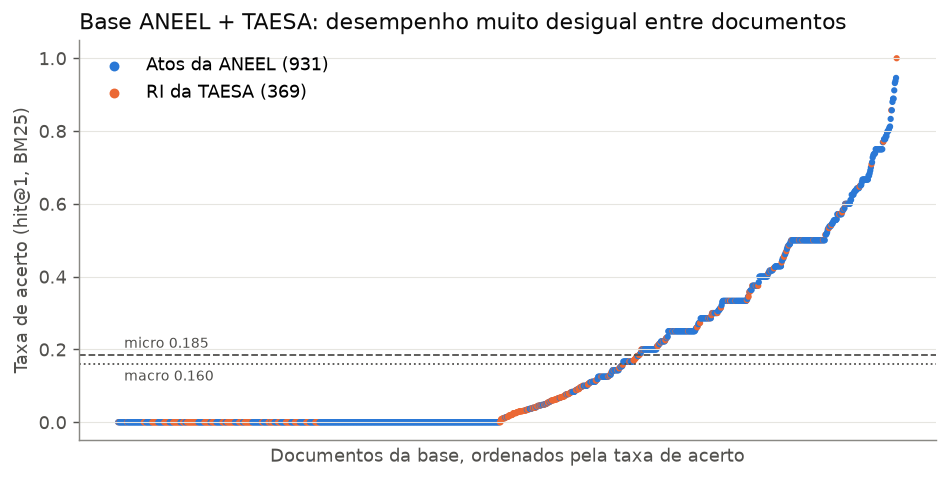
No acervo inteiro, o BM25 acertou 18,46% das consultas. Essa é a micro-média, em que cada trecho pesa igual. Se primeiro se calcula a taxa de cada documento e depois a média entre documentos, a macro-média, o resultado cai para 15,96%. Os 2,5 pontos de diferença aparecem porque os documentos grandes têm mais trechos e, portanto, mais votos na micro-média. Qual usar depende da pergunta: a fração de trechos atribuídos corretamente ou o desempenho em um documento típico.
O resultado varia por tipo: as demonstrações contábeis regulatórias anuais ficaram perto de 4%, os formulários de referência de 6% e os avisos de dividendos em zero; resoluções normativas e despachos passaram de 40%. A semelhança entre versões é uma hipótese plausível, mas os acertos salvos não identificam a causa de cada erro. Para verificá-la, preciso de consultas, rankings e revisão dos documentos recuperados.
Convém ser preciso sobre o que isso mede. Aqui o hit@1 é um proxy de atribuição de fonte, não a qualidade de uma resposta: não verifica relevância julgada por especialistas, fidelidade, citações nem vigência. Uma passagem idêntica de outra edição conta como erro, mesmo que respondesse bem a uma pergunta atemporal. Os documentos com taxa zero não são irrecuperáveis em um RAG; apenas não foram reconhecidos nesta prova. Em um acervo regulatório, porém, confundir 2021 com 2022 é justamente o tipo de erro que importa.
Ver a figura original T1: distribuição por documento (em português)
A suposição escondida: cada trecho é uma prova independente
Quando o intervalo de confiança é calculado sobre trechos, a fórmula supõe que cada um é uma observação nova, como tirar bolas de uma urna. Pense numa pesquisa em que você entrevista 20 pessoas e faz 50 perguntas parecidas a cada uma. Você tem 1.000 respostas, mas as respostas de uma mesma pessoa se parecem entre si. A informação real está mais perto de 20 pessoas do que de 1.000 respostas.
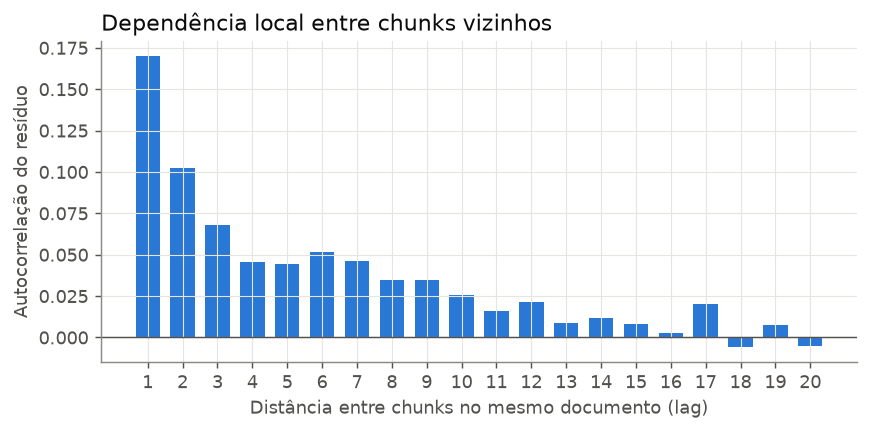
Com documentos acontece o mesmo. Trechos de uma mesma resolução compartilham vocabulário, estrutura e assunto; se um deles é fácil de atribuir, os vizinhos costumam ser também. O estudo mediu isso. A correlação intraclasse (ICC), que indica quanto do resultado é explicado pelo documento, foi 0,293, cinco vezes maior que num caso anterior com artigos científicos. Mesmo descontando a média de cada documento, trechos vizinhos ainda têm autocorrelação de 0,17. E os tamanhos são muito desiguais: a mediana é de sete trechos por documento, mas os 10% maiores concentram 59% de todos os trechos.
A aproximação de DEFF baseada em ICC e tamanhos dá 33,2 e um equivalente N/DEFF próximo de 1.010. É uma referência de variância sob esse modelo, não 1.010 documentos nem a variância amostral de um censo já observado. Com tamanhos desiguais, é preciso considerar o CV; a fórmula balanceada 1+(m−1)ρ não reproduz esse valor.
Como saber se um intervalo é honesto
Aqui entra o conceito de cobertura. Como o valor da população inteira é conhecido, dá para repetir a amostragem milhares de vezes e contar quantos intervalos contêm esse valor. Um procedimento de 95% deveria acertar em cerca de 95% das repetições. A cobertura fala do método, não do sistema: não significa que 95% das respostas estejam certas nem que haja 95% de probabilidade de o valor estar dentro de um intervalo já calculado.
| Média | Método | Cobertura | Margem MC (p.p.) | Largura média |
|---|---|---|---|---|
| micro | Wald iid | 29.5% | ±1.3 | 0.069 |
| micro | Bootstrap de trechos | 25.0% | ±1.2 | 0.057 |
| micro | Wald com tamanho efetivo | 89.0% | ±0.9 | 0.329 |
| micro | CR2 por documento | 85.7% | ±1.0 | 0.389 |
| micro | Bootstrap-t por documento | 88.4% | ±0.9 | 0.673 |
| macro | t por documento | 93.0% | ±0.7 | 0.206 |
| macro | Bootstrap-t por documento | 97.2% | ±0.5 | 0.243 |
Os dois métodos que contam os trechos como independentes, o Wald iid e o bootstrap de trechos, cobriram 29,5% e 25%. O bootstrap merece atenção porque passa a impressão de ser um método robusto. Ele sorteia trechos com reposição; se a unidade sorteada está errada, repetir o sorteio um milhão de vezes só reproduz o mesmo erro com mais casas decimais.
Os métodos documentais melhoram muito frente ao iid, mas nenhum atingiu 95% na micro com 20 documentos: o CR2 cobriu 85,7% e o bootstrap-t, 88,4%. O Wald com tamanho efetivo chegou a 89,0%, sem por isso se tornar uma solução geral. Na macro, o t cobriu 93,0% e o bootstrap-t, 97,2%. A concentração de pesos e as taxas com muitos zeros justificam investigar a influência da amostra; não demonstram, sozinhas, uma causa única da subcobertura.
Não leio esses números como um ranking universal. Com cinco documentos, o bootstrap-t pode produzir intervalos mais largos que [0,1]. Intersectar um intervalo com esse espaço preserva seu evento de cobertura para uma proporção, mas não corrige a subcobertura. Logit pode manter os limites no domínio quando está definido; também não garante calibração. E os 3,76 graus de liberdade CR2 de uma amostra não significam literalmente quatro documentos independentes.
Pustejovsky e Tipton (2018): inferência robusta com poucos grupos
Como calcular respeitando o documento
Na prática, o ajuste é menos complicado do que parece. Para cada documento d guarda-se o número de trechos n_d, os acertos s_d e a taxa p_d = s_d / n_d. A macro-média é a média das taxas; a micro-média é a soma dos acertos dividida pela soma dos trechos. Com tamanhos desiguais, as duas não coincidem, então cada réplica precisa recalcular exatamente o estimador escolhido.
No bootstrap por documento, cada réplica sorteia 20 identificadores de documento com reposição e leva junto todos os resultados de cada um. Se um documento sai duas vezes, seu bloco conta duas vezes. Nenhum documento novo é criado: a ideia é imitar a variação entre amostras possíveis a partir dos grupos observados. Dá para começar com 5.000 réplicas e verificar se os quantis mudam quando esse número cresce. O erro-padrão é o desvio-padrão das estimativas replicadas e o intervalo percentil de 95% usa os quantis 2,5% e 97,5%. Isso descreve a mecânica, não uma recomendação: com poucos grupos, esse intervalo subcobriu neste relatório. Para a macro-média há uma alternativa direta: média das taxas ± t com K − 1 graus de liberdade × desvio-padrão das taxas / raiz de K. Se tipos ou famílias foram sorteados antes dos documentos, esse nível também precisa entrar na conta.
Um exemplo inventado mostra o tamanho da diferença. Imagine 20 documentos com 500 trechos cada: dez nunca acertam e dez acertam 40% das vezes. As duas médias dão 0,20. Se os 10.000 resultados forem tratados como independentes, o erro-padrão sai 0,004 e o intervalo de 95% fica em torno de [0,192; 0,208]. Se a conta for feita com as 20 taxas, o desvio-padrão é 0,2052, o erro-padrão 0,0459 e o intervalo t com 19 graus de liberdade vai de cerca de 0,104 a 0,296. Os dados são os mesmos; o intervalo honesto é mais de dez vezes mais largo. São números ilustrativos, não resultados da TAESA.
Duas ressalvas. A primeira: saber que existem 10.000 trechos e 20 documentos não basta para calcular nada; são necessários os resultados, os tamanhos e o desenho de seleção. A segunda: a reamostragem mede a incerteza de sortear documentos com o índice fixo. Ela não cobre o que aconteceria se o corpus fosse reconstruído, o recuperador fosse trocado ou chegassem perguntas diferentes. E, se a amostra for uma fração grande de uma população finita, a correção correspondente também entra na conta.
Cortar mais fino piora a ilusão
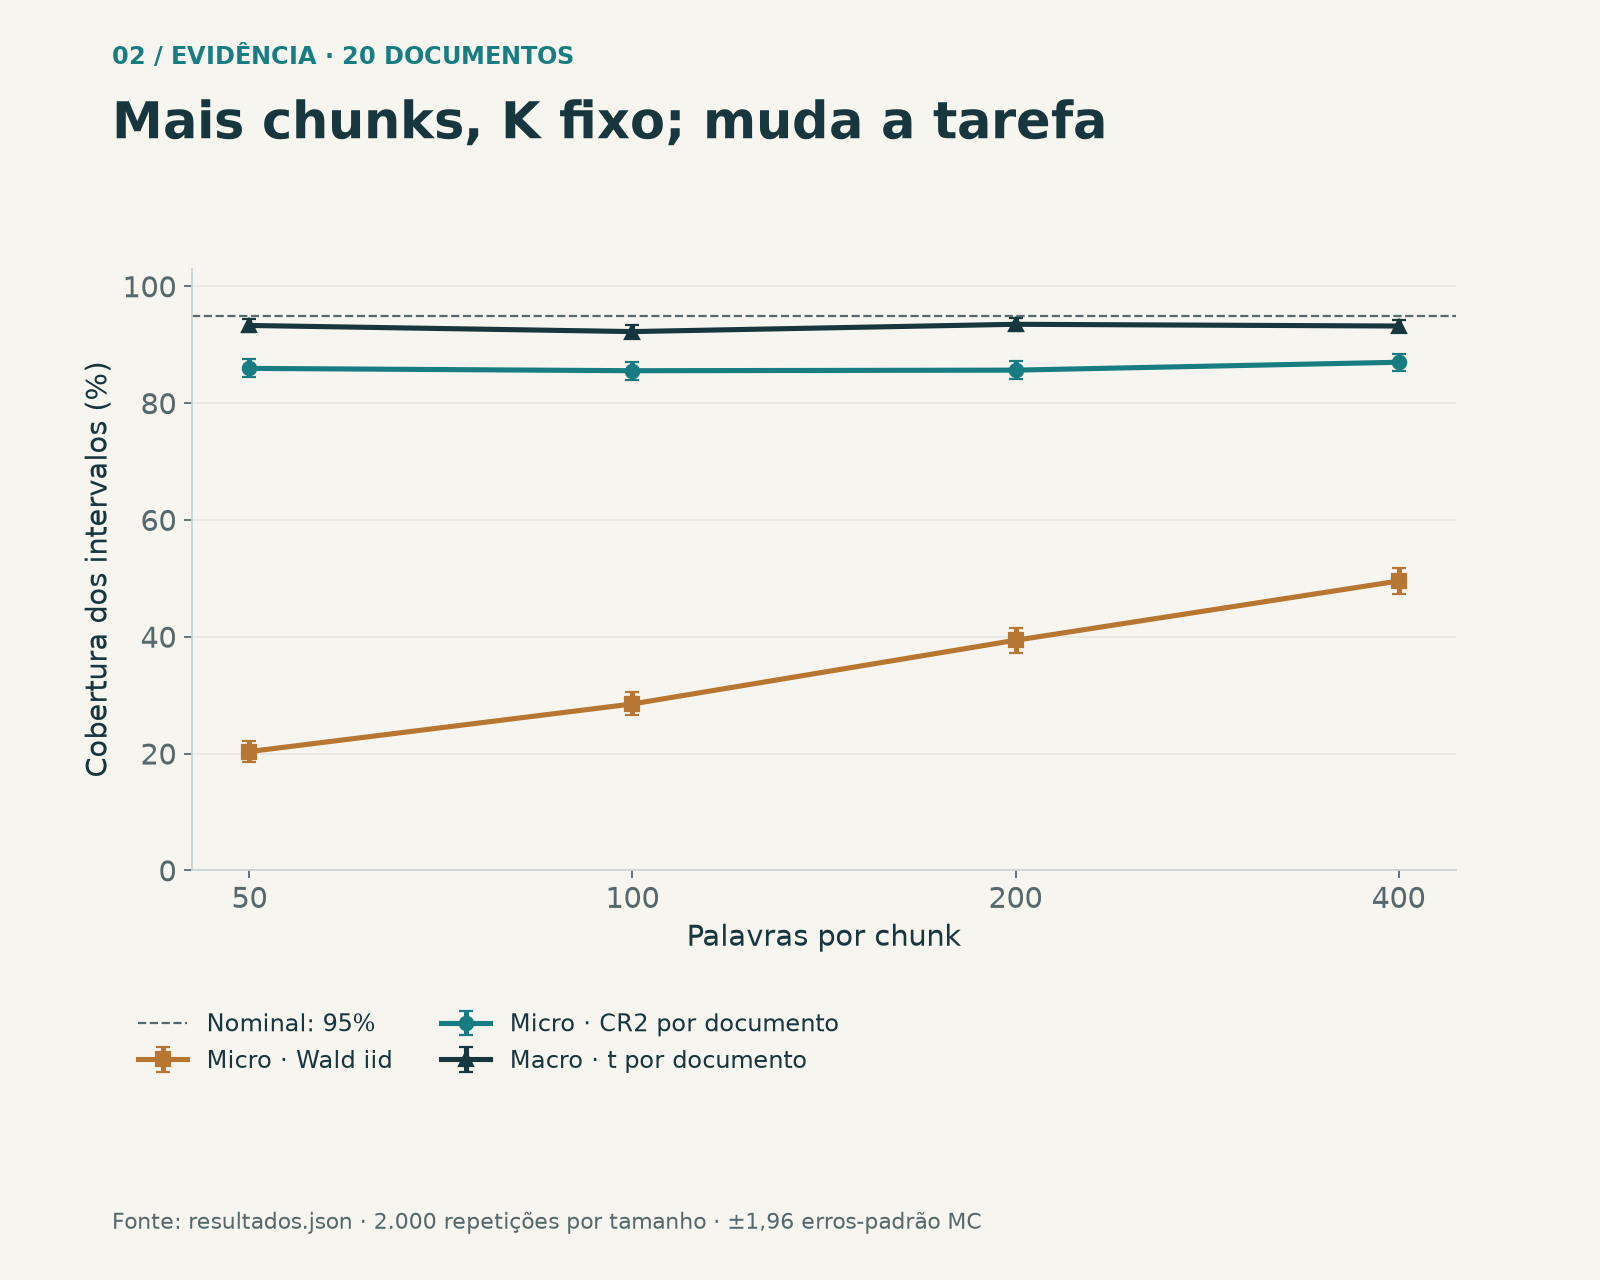
Ao variar o tamanho, mantive K=20, mas não as mesmas amostras nem as mesmas consultas. Com chunks de 400 palavras, foram elegíveis 749 documentos; com 50, 1.300. A cobertura Wald micro caiu de 49,5% para 20,3%, enquanto os chunks esperados por amostra passaram de cerca de 212 para 1.031. É uma sensibilidade conjunta de população, consultas e segmentação; não identifica o efeito isolado de cortar mais fino.
Mais documentos ajudam, e o desenho decide a unidade
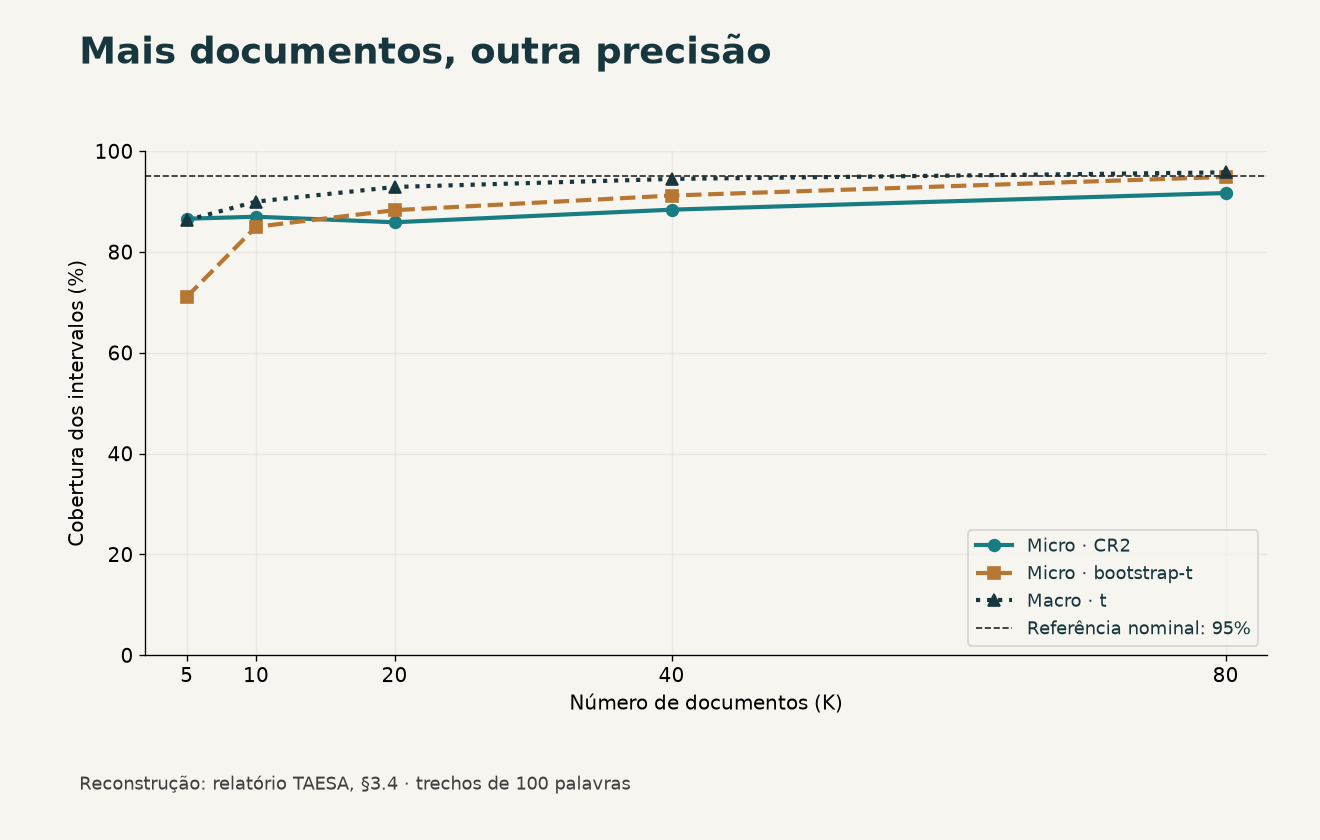
Nesta população, aumentar K aproximou alguns métodos do nominal: o t macro cobriu 94,5% com 40 documentos e 95,8% com 80; na micro, CR2 e bootstrap-t cobriram 91,7% e 94,9% com 80. São resultados de configurações específicas, não garantias de que certa quantidade de documentos baste para qualquer avaliação.
| K | Micro: CR2 | Micro: bootstrap-t | Macro: t |
|---|---|---|---|
| 5 | 86.6% | 71.1% | 86.3% |
| 10 | 87.0% | 85.0% | 90.0% |
| 20 | 85.9% | 88.3% | 92.9% |
| 40 | 88.4% | 91.2% | 94.5% |
| 80 | 91.7% | 94.9% | 95.8% |
Também avaliei selecionar seis tipos e quatro documentos de cada um. O alvo é a média entre tipos, 0,1156. Os métodos documentais e o bootstrap simples de tipos são aproximações diferentes; este último não reproduz exatamente os dois estágios sem reposição. A revisão acrescentou uma referência com as duas correções finitas: em 5.000 novas repetições, o intervalo t cobriu 91,42%, ainda abaixo do nominal. A escolha depende do desenho completo, não apenas da semelhança temática.
O que muda numa decisão sobre RAG
Volto à situação do começo. Alguém compara dois recuperadores, vê uma diferença de dois pontos com milhares de provas e conclui que um é melhor. Antes de aceitar a conclusão, eu faria quatro perguntas. Qual é a população e qual estimador responde à pergunta de negócio? A comparação usa as mesmas consultas, com diferenças pareadas? A unidade de reamostragem corresponde ao que foi sorteado? E o método de intervalo foi verificado ou só escolhido pelo nome? Nesta base, a vantagem do BM25 sobre o TF-IDF foi de 0,62 ponto na micro-média, com empate em 70% dos documentos: uma diferença desse tamanho precisa de uma avaliação bem desenhada para significar alguma coisa.
Eu também publicaria a distribuição por documento junto com a média. Uma média de 18% esconde que metade dos documentos nunca foi reconhecida e que uma minoria é reconhecida quase sempre. O estudo não mostra que uma representação jurídica estruturada melhoraria a recuperação. Mostra onde olhar primeiro: em como os documentos são representados e em como se avalia, antes de atribuir qualquer ganho ao modelo. É disso que trata a segunda parte.
Continuar: do trecho ao dispositivo regulatório
Proveniência, figuras e limites desta leitura
Fonte: relatório ANEEL–TAESA de Jean M. Estevez Alvarez, revisado em 11 de outubro de 2026, e resultados salvos. As figuras originais preservam as simulações históricas. Esta revisão acrescenta uma verificação de dois estágios, identificada separadamente; não repete a extração nem a recuperação. Os manifests atuais e anteriores permitem distinguir as versões do relatório e dos agregados.
Baixar os agregados utilizados nos gráficos (JSON)
As seis figuras originais são oferecidas sem alterações, com rótulos em português, como material documental distinto das ilustrações traduzidas. T1 mostra taxas por documento; T2, por tipo; T3, cobertura sob amostragem simples; T4, dois estágios; T5, largura; T6, autocorrelação. Não são publicados textos integrais do acervo nem arquivos brutos do experimento.
Figura original T1 (português)
Figura original T2 (português)

Figura original T3 (português)
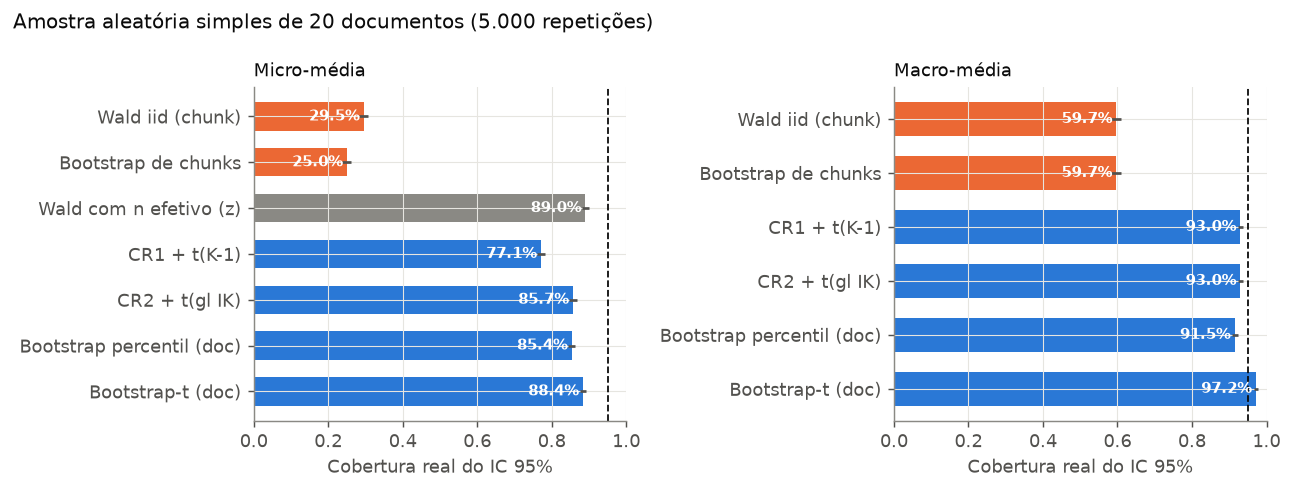
Figura original T4 (português)

Figura original T5 (português)
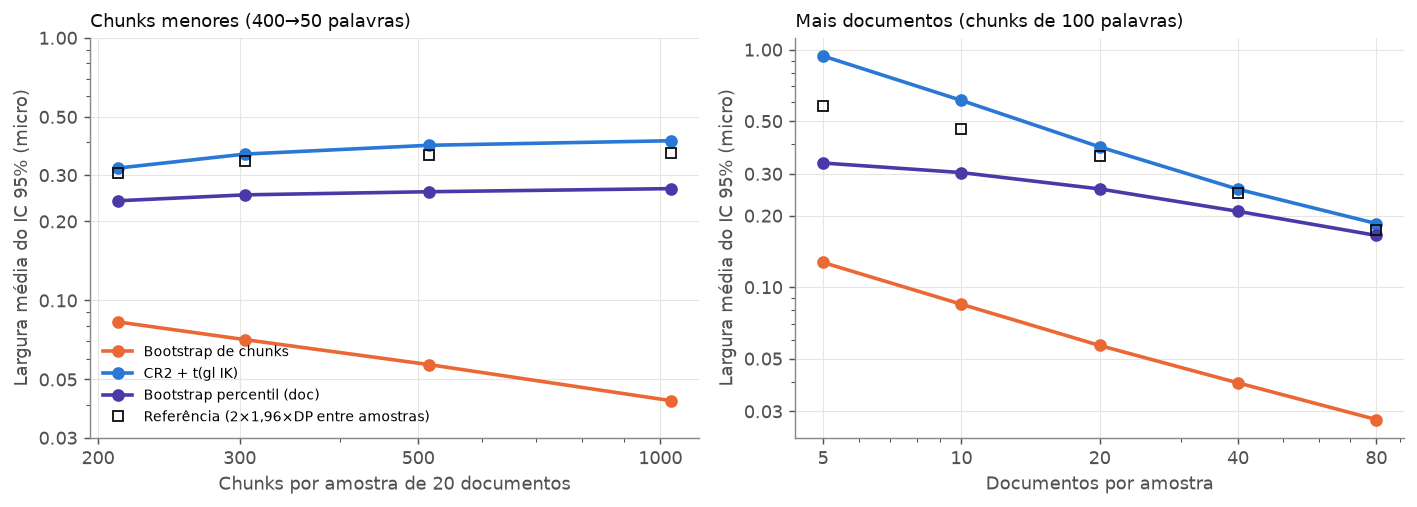
Figura original T6 (português)
Agregados adicionais e hashes das fontes (JSON)
Revisão metodológica · 11 de outubro de 2026
Os experimentos são de minha autoria, Jean M. Estevez Alvarez. Esta revisão distingue os resultados originais das verificações posteriores: preserva os desfechos e coberturas originais, corrige as quantidades derivadas e acrescenta 5.000 repetições do desenho de dois estágios. Não houve nova recuperação, treinamento ou avaliação em produção.
A seleção do RI teve dois filtros: até 35 candidatos por tipo após a primeira triagem e até 25 incluídos depois da limpeza e revisão do texto. Não houve reposição automática das exclusões finais. Os rankings originais usam desempates implícitos e não preservam os candidatos recuperados; por isso não atribuo cada erro a uma versão incorreta sem evidência adicional.
Resultados da revisão do desenho (JSON)
Field e Welsh (2007): modelos e limites do bootstrap agrupado