Por qué 10.000 fragmentos de 20 documentos no son 10.000 casos
Incertidumbre en RAG, parte 1: por qué contar fragmentos no basta para saber cuánta información aporta una muestra de documentos.

En este artículo
Imagine 20 documentos divididos en 10.000 fragmentos. Si la tasa es del 18%, tratarlos como Bernoulli iid da un error estándar cercano a 0,4 puntos y un intervalo de aproximadamente ±0,8 puntos. Es un ejemplo, no el tamaño de la muestra TAESA. En el caso real, el procedimiento iid cubrió menos de un tercio de las repeticiones de muestras de 20 documentos.
La serie anterior sobre ese caso mostró el síntoma. Esta serie de tres artículos construye la teoría que lo explica y la pone a prueba con los mismos datos. Aquí respondo a una pregunta: por qué 10.000 fragmentos de 20 documentos no equivalen a 10.000 casos independientes. La segunda parte justifica qué unidad debe remuestrear el bootstrap. La tercera muestra cómo calcular la incertidumbre sin usar el fragmento como réplica artificial.
Serie anterior: 33.503 fragmentos no son 33.503 pruebas
La pregunta que define el error estándar
Un error estándar depende del estimador y del mecanismo de repetición del estudio. No se deduce solo del número de filas. Aquí distingo dos mecanismos: volver a muestrear fragmentos de documentos fijos o seleccionar otros documentos y observar todos sus fragmentos. Mi experimento evalúa el segundo.
Con documentos fijos, remuestrear fragmentos dentro de cada uno describe otra fuente de variación. Incluso allí hay que distinguir probabilidades distintas y dependencia local: no basta aplicar una única fórmula binomial. En mi experimento se observan todos los fragmentos del documento seleccionado; la incertidumbre que estudio procede de seleccionar documentos.
De dónde viene el azar
En el experimento ANEEL–TAESA, el índice de búsqueda es fijo y el resultado de cada fragmento se calculó una única vez. Dado el índice, el resultado de un fragmento no tiene nada de aleatorio: si se repite la consulta, sale lo mismo. Cuando un documento entra en la muestra, entran todos sus fragmentos, de modo que dentro del documento no hay muestreo, hay censo. El único paso aleatorio de todo el procedimiento es el sorteo de qué documentos se evalúan.
Esto tiene una consecuencia que suena paradójica. Para los 20 documentos sorteados, la tasa de acierto se conoce sin error: ya se midieron todos sus fragmentos. Para el acervo, la incertidumbre depende solo de cuánto varían los documentos entre sí. La fórmula binomial no acierta en ninguno de los dos casos: atribuye una incertidumbre pequeña a una cantidad que no tiene incertidumbre y se la presta a otra cuya incertidumbre es mucho mayor.
La misma idea como modelo
La lectura anterior es la del muestreo de poblaciones finitas, que corresponde exactamente al diseño validado. Si se prefiere un modelo, la intuición es la misma. Suponga que el resultado del fragmento c del documento d se compone de un nivel general μ, un efecto propio del documento b_d y un ruido del fragmento e_dc:
y_dc = μ + b_d + e_dc        Var(b_d) = σ_b²      Var(e_dc) = σ_e²

Var(ȳ) = σ_b² / K  +  σ_e² / (K · m)
Esta fórmula supone documentos independientes, tamaños iguales, efectos con varianza constante y residuos independientes entre sí y de los efectos documentales. Bajo ese modelo, aumentar m reduce el segundo término y deja σ_b²/K. Es una ilustración; cambiar la segmentación de textos fijos no equivale a obtener nuevos residuos de ese modelo.
La correlación intraclase, ρ = σ_b² / (σ_b² + σ_e²), mide qué parte de la variación total pertenece al documento. De ella salen el efecto de diseño de Kish (1965) y el tamaño efectivo:
DEFF = 1 + (m − 1) · ρ

n_eff = K · m / DEFF   →   K / ρ     (m → ∞)

DEFF_Kish = 1 + ((1 + CV²) · m̄ − 1) · ρ      CV = sd(m) / m̄
En el modelo ilustrativo, con tamaños iguales y ρ fijo, el equivalente tiende a K/ρ: con K=20 y ρ=0,293, unos 68. No es un límite universal para este corpus. Cambiar el corte cambia consultas, resultados y posiblemente la correlación. Con tamaños desiguales, el DEFF basado en ICC y CV es un diagnóstico aproximado, no un sustituto de la varianza del diseño.
Lo que mostraron los datos
En una etapa adicional sorteé 2.000 muestras de 20 documentos sobre los resultados ya calculados. Con fragmentos de 100 palabras, el DP micro fue 0,0885; la linealización prevé 0,0915. En macro fueron 0,0496 y 0,0497. Frente a la referencia binomial de 0,0171, la razón de varianzas es 26,8 usando el resultado empírico y 28,7 usando la linealización. Son cantidades próximas, pero distintas.
Como referencia de precisión, podemos dividir p(1−p) por la varianza estimada. Con unos 515 fragmentos por muestra, el equivalente Bernoulli micro es 19,2 usando la varianza empírica y 18,0 usando la linealización; el macro empírico ronda 54,5. No son documentos adicionales ni un recuento de casos independientes.
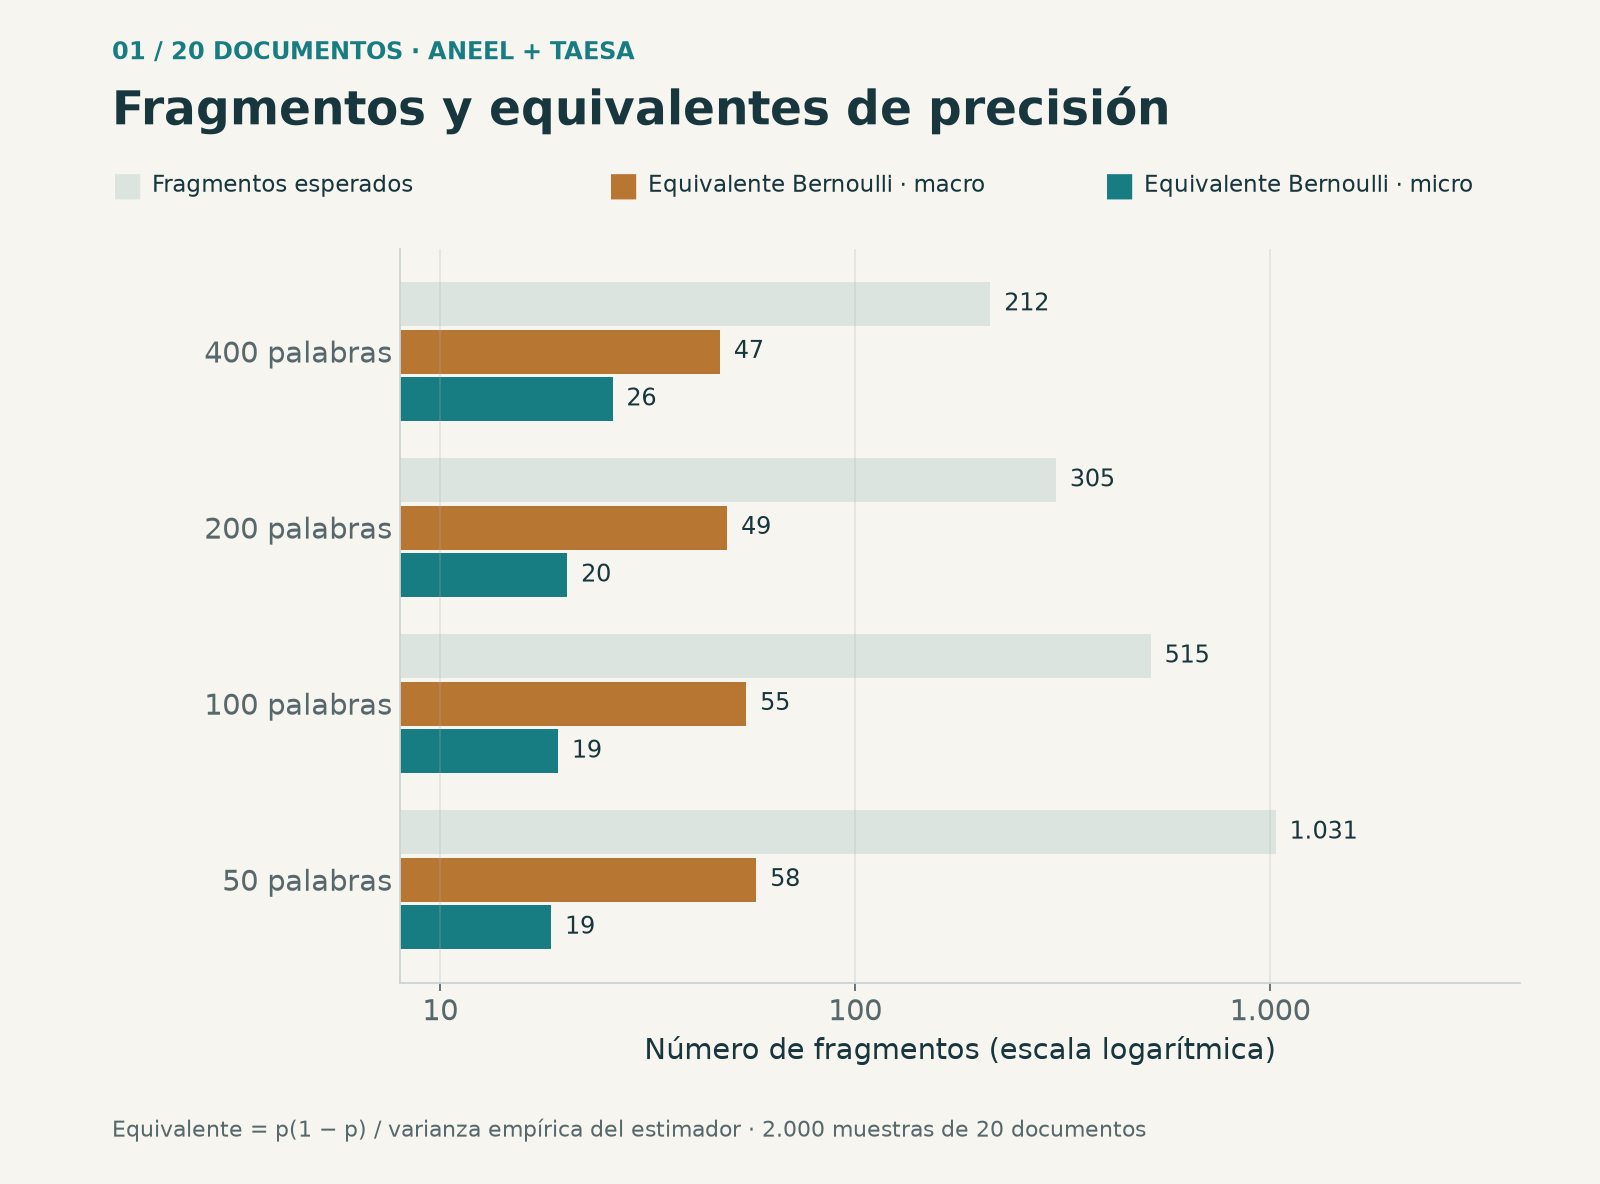
Con 50 y 100 palabras permanecen los mismos 1.300 documentos elegibles, pero cambian las consultas y se sortean nuevas muestras. Los fragmentos esperados pasan de 515 a 1.031; el DP micro empírico pasa de 0,0885 a 0,0919 y el macro de 0,0496 a 0,0504. La referencia binomial disminuye. Esto muestra el comportamiento de estas configuraciones, no que toda resegmentación conserve exactamente la información.
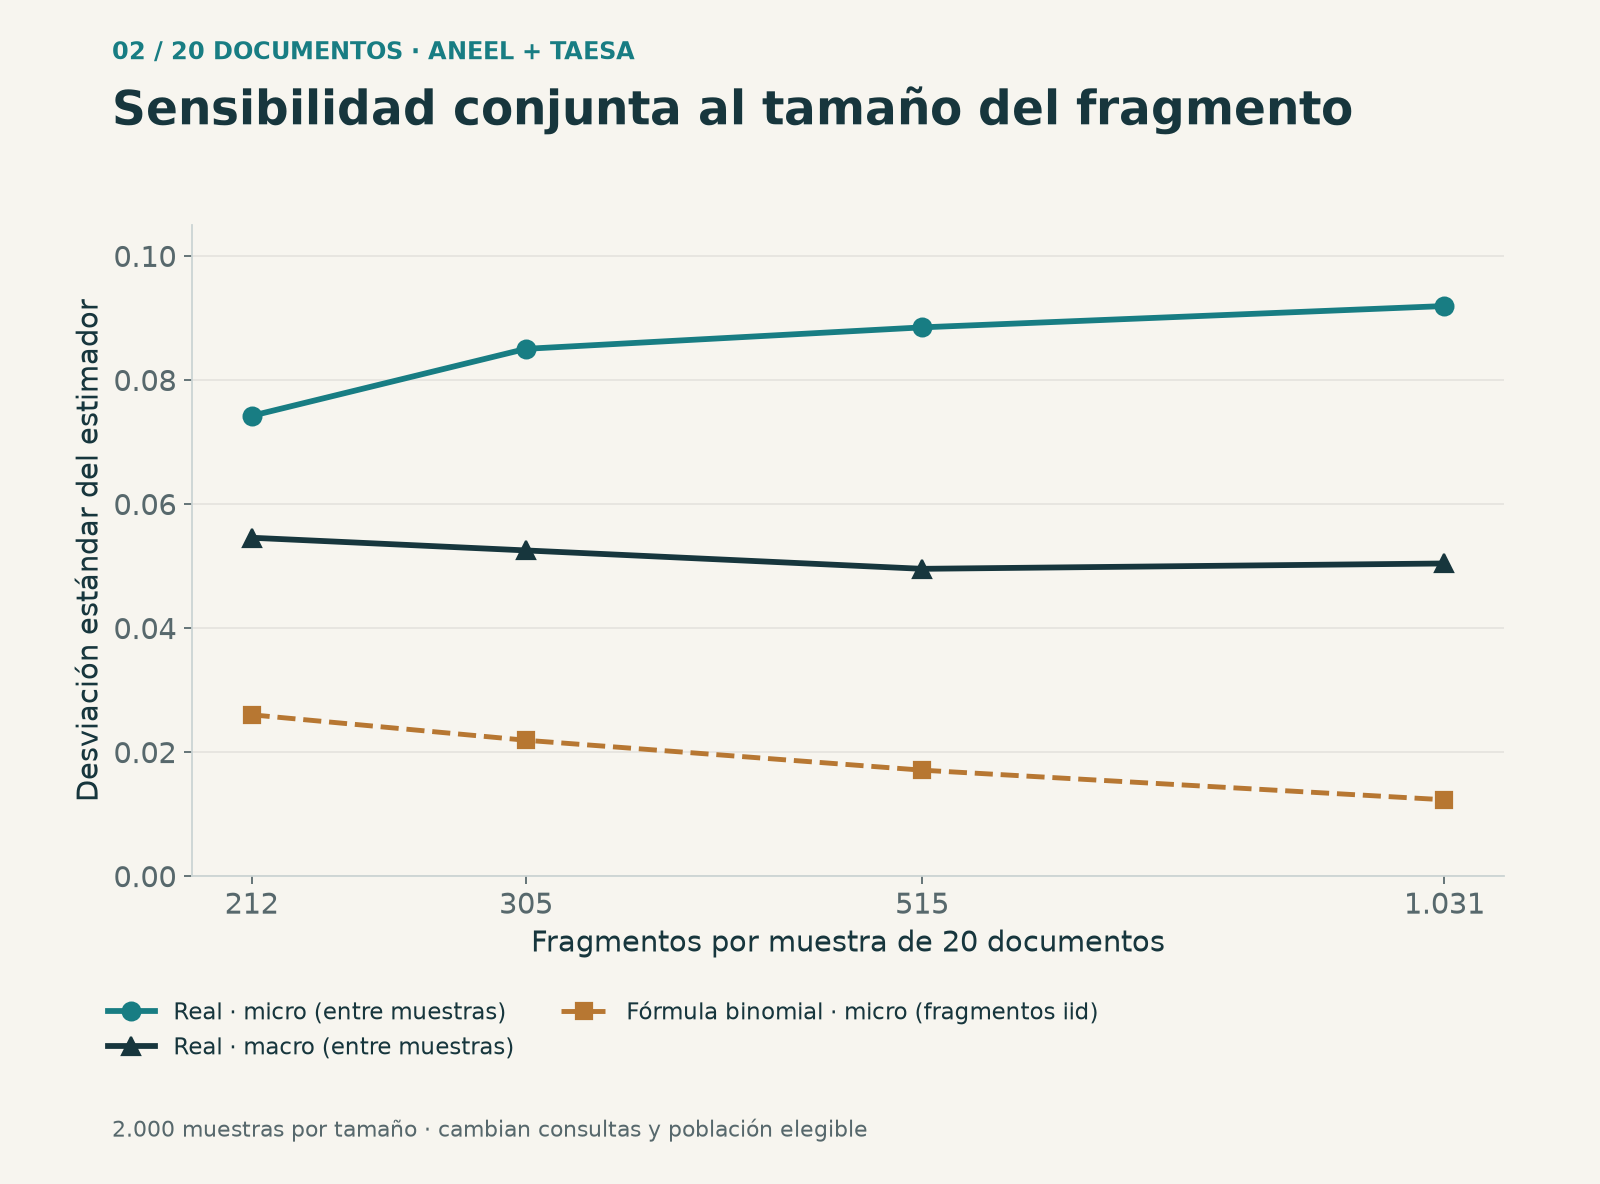
En la primera versión resté un componente binomial de la variación entre tasas y lo interpreté como un piso de incertidumbre. Retiré esa interpretación: requiere independencia condicional dentro del documento, que no validé. Para este diseño basta trabajar con las tasas documentales observadas y su variación bajo el sorteo; no hace falta atribuirles un ruido interno hipotético.
Por qué los fragmentos de un documento se parecen
Los fragmentos de una resolución comparten vocabulario y estructura, y una versión similar de otro año puede competir en la búsqueda. Son mecanismos plausibles. La ICC de 0,293 resume heterogeneidad bajo el modelo utilizado, pero no identifica por sí sola cuál de esos mecanismos causó cada error. Esa atribución requiere examinar consultas y resultados recuperados.
Hay dependencia también a menor escala: descontada la media del documento, los fragmentos vecinos todavía tienen una autocorrelación de 0,17. Y la hay a mayor escala: el tipo de documento explica el 12,6% de la variación de las tasas. Esto no invalida el razonamiento. En el enfoque de muestreo, lo que hace válida la inferencia es el sorteo de documentos, no una supuesta independencia entre ellos. Si los documentos se sortearon al azar, el parecido entre dos versiones de una misma demostración forma parte de la variación entre documentos que el método tiene que reproducir.
Lo que este argumento no dice
- Los fragmentos siguen siendo útiles para medir el resultado de cada documento. Pero volver a cortar un texto fijo no equivale a obtener nuevos ensayos independientes ni permite separar automáticamente ruido y dificultad documental.
- La fórmula binomial es apropiada bajo ensayos Bernoulli iid. El control simulado sin heterogeneidad cumplía esas condiciones y obtuvo cobertura cercana al 95%. Una ICC estimada en cero, por sí sola, no demuestra independencia ni descarta dependencia local.
- No cubre todas las fuentes de incertidumbre. Con el índice fijo, el análisis mide la variación debida al sorteo de documentos. Cambiar la composición del corpus, el recuperador o el tipo de pregunta son otras repeticiones, con otras varianzas.
- No es una medida de calidad final del RAG. El hit@1 aquí es un proxy de atribución. El razonamiento se extiende a medias de escores bajo un diseño y agrupamiento especificados; no automáticamente a cualquier métrica o pregunta.
En resumen
La conclusión es concreta: en este diseño, 10.000 fragmentos procedentes de 20 documentos no son 10.000 unidades de muestreo. Los documentos se seleccionan y sus fragmentos se observan completos. En TAESA, la muestra de K=20 tiene unos 515 fragmentos en promedio y un equivalente micro de precisión cercano a 19,2 bajo la referencia empírica utilizada. El bootstrap debe respetar ese diseño, sin prometer una calibración que los datos no sostienen.
Parte 2: qué unidad debe remuestrear el bootstrap
Procedencia y referencias
Datos: resultados por fragmento del estudio ANEEL–TAESA (1.300 documentos, 33.503 fragmentos de 100 palabras, BM25, hit@1), ya presentados en la serie anterior. Las cifras nuevas vienen de etapa4_teoria.py, que no recalcula la recuperación: sortea 2.000 muestras de 20 documentos sobre los resultados ya calculados. Los agregados de las figuras y los hashes de las fuentes están en el archivo JSON.
Descargar los agregados y los hashes de las fuentes (JSON)
- Kish, L. (1965). Survey Sampling. Wiley.
- Cochran, W. G. (1977). Sampling Techniques (3rd ed.). Wiley.
- Miller, E. (2024). Adding Error Bars to Evals: A Statistical Approach to Language Model Evaluations. arXiv:2411.00640.
Revisión metodológica · 11 de octubre de 2026
Realicé los experimentos como Jean M. Estevez Alvarez. Esta revisión distingue los resultados originales de las verificaciones posteriores: conserva los resultados por fragmento y las coberturas originales, corrige las cantidades derivadas y añade 5.000 repeticiones del diseño de dos etapas. No hubo nueva recuperación, entrenamiento ni evaluación en producción.
Resultados de la revisión del diseño (JSON)
Field y Welsh (2007): modelos y límites del bootstrap agrupado