Por que o resultado muda: capacidade, dados e os limites de uma GNN
Uma leitura matemática dos meus experimentos: como a distribuição da demanda, os limites LP e o alcance da busca favorecem ou dificultam cada método.
Neste artigo
Quando coloquei uma rede neural em grafos para ajudar a escolher centros de distribuição, a expectativa parecia razoável: se ela aprendesse a reconhecer boas opções nos exemplos de treinamento, o otimizador poderia concentrar seu esforço em uma parte menor do problema. A rede de fato aprendeu a ordenar candidatos com uma boa métrica de classificação. No entanto, ao executar os experimentos, uma orientação baseada em programação linear, sem treinamento prévio, conduziu a busca a resultados melhores ao longo do tempo. Foi essa diferença entre reconhecer candidatos promissores e ajudar a tomar uma decisão completa que passou a me interessar.
Na postagem anterior, apresentei a preparação dos experimentos na AWS e os resultados do estudo. Aqui, quero examinar o que havia por trás daquela comparação. Para isso, vale começar por uma dificuldade bastante concreta: um centro pode parecer excelente quando observado sozinho e, ainda assim, fazer parte de uma combinação ruim. Ele pode estar perto de muitos clientes, mas não ter espaço para todos; pode ser barato para abrir, mas obrigar a percorrer distâncias maiores; ou pode disputar os mesmos clientes com outro centro igualmente bem localizado. É nessas relações que a otimização acontece, e é a partir delas que podemos entender melhor o comportamento dos algoritmos.
O que muda quando a demanda se concentra
O problema que estudei consiste em escolher quais centros abrir e definir qual deles atenderá cada cliente. Há um custo fixo de abertura e um custo de atendimento, e a soma dos dois deve ser a menor possível. Essa economia, porém, precisa respeitar duas condições: cada cliente será atendido por um único centro, e nenhum centro poderá receber uma demanda superior à sua capacidade. A primeira condição impede dividir livremente um pedido entre vários locais; a segunda faz com que a escolha de um cliente altere as opções disponíveis para os demais. Por isso, resolver cada atendimento de maneira isolada não basta para organizar a rede inteira.
Para visualizar essa dependência, construí três exemplos pequenos, nos quais conseguimos conferir a melhor solução enumerando todas as alocações possíveis. Em todos eles há três centros, cada um com capacidade para seis unidades, e seis clientes que demandam duas unidades cada. Portanto, a capacidade disponível é 18 e a demanda total é 12. Também mantive o custo de abertura em duas unidades por centro e calculei o atendimento como dez vezes a distância euclidiana vezes a demanda. Entre um painel e outro, só mudei a posição dos clientes. Assim, podemos observar o efeito da distribuição espacial sem confundi-lo com uma mudança de capacidade ou de regra de custo.

Nos dois primeiros cenários, atribuir cada cliente ao centro mais próximo produz cargas de quatro unidades em cada local. Já no terceiro, a mesma regra encaminharia as doze unidades para o centro B, que só comporta seis. A capacidade total continua sobrando, mas parte dela está nos lugares menos convenientes. Para respeitar o limite, a solução precisa encaminhar alguns clientes a outro centro, aceitando um custo de transporte maior. A figura mostra justamente essa redistribuição: as linhas representam uma alocação ótima, enquanto os números abaixo dos painéis mostram o que aconteceria se olhássemos apenas para a proximidade.
Esse exemplo ajuda a dar um sentido mais preciso à expressão “distribuição dos dados”. Não se trata apenas do formato dos pontos no mapa ou da média das demandas. O que importa é como os clientes disputam as alternativas disponíveis. Mesmo sem coordenadas geográficas, podemos ter uma situação equivalente se muitos clientes dependerem das mesmas conexões baratas. Quando a abertura de um centro fica cara em relação ao transporte, essa disputa ganha outra dimensão: concentrar o atendimento economiza custos fixos, mas aumenta o risco de saturação e pode alongar os percursos. A dificuldade resulta da combinação dessas características, e não de uma regra segundo a qual todo agrupamento seria difícil ou toda distribuição uniforme seria fácil.
Como uma simplificação matemática ajuda a decidir
É para considerar essas relações em conjunto que usamos um modelo de otimização. Se chamarmos de yᵢ a decisão de abrir o centro i e de xᵢⱼ a decisão de atribuir o cliente j a esse centro, o custo total pode ser escrito como z = Σᵢ fᵢyᵢ + Σᵢⱼ cᵢⱼxᵢⱼ. A primeira soma reúne os custos fixos de abertura; a segunda reúne os custos de atendimento. No modelo original, essas decisões valem zero ou um. As restrições garantem que cada cliente tenha exatamente uma atribuição e que a demanda recebida por um centro não ultrapasse sua capacidade. Aqui, cᵢⱼ já representa o custo de atender toda a demanda daquele cliente pela conexão escolhida.
Encontrar a melhor combinação inteira pode ser trabalhoso. Uma forma de obter informação antes dessa busca é permitir temporariamente que x e y assumam valores entre zero e um. Essa versão é chamada de relaxação linear, ou LP. Ela pode dividir um atendimento e considerar aberturas fracionárias, possibilidades que não fazem parte da operação real. Por admitir mais soluções, seu custo ótimo não pode ser maior que o do problema original. Obtemos, assim, um limite inferior: uma referência matemática que ajuda a avaliar quanto ainda poderíamos economizar e quais centros parecem relevantes para a instância que estamos resolvendo.
O tamanho da diferença entre essa referência e uma solução realizável depende da estrutura do problema. Considere três clientes com demanda de seis unidades e três centros com capacidade de dez, cada um custando cem para abrir, sem custo de transporte. Dois centros somam capacidade vinte para demanda dezoito, mas não conseguem atender os três clientes: colocar dois deles juntos exigiria doze unidades no mesmo local. Precisamos abrir os três centros, pagando trezentos. A LP, por outro lado, pode distribuir um terço de cada cliente para cada centro e abrir apenas 60% de cada um. Cada centro recebe seis unidades, dispõe de capacidade fracionária seis e o custo total fica em cento e oitenta.
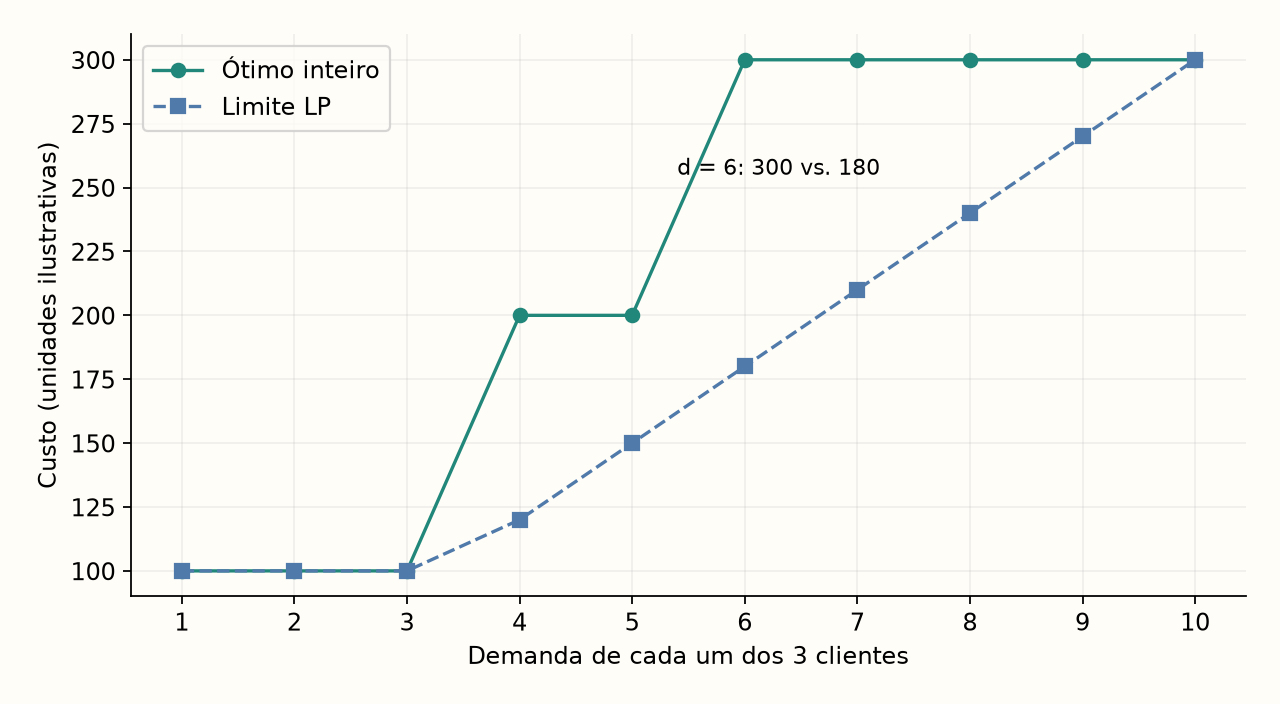
A diferença de 40% em relação ao ótimo inteiro não vem de um erro de cálculo. Ela aparece porque a relaxação permitiu dividir decisões que, no problema original, precisam ser tomadas por inteiro. O salto no gráfico, quando a demanda passa de cinco para seis, mostra exatamente o momento em que dois clientes deixam de caber no mesmo centro. Demandas maiores ou mais desiguais podem tornar esses encaixes especialmente importantes. Ainda assim, seria precipitado concluir que uma GNN necessariamente se sairia melhor: neste exemplo, os três centros são simétricos e todos são necessários. A qualidade do limite matemático e a utilidade de uma ordenação de candidatos são questões relacionadas, mas não equivalentes.
O que a rede aprendeu e o que a decisão exigia
A GNN entrou no projeto para produzir essa ordenação por outro caminho. Representei centros e clientes como nós de um grafo, ligados pelas relações de atendimento. Cada nó e cada conexão carregam informações, como demanda, capacidade e custos relativos. Ao trocar mensagens entre elementos conectados, a rede combina essas informações para atribuir uma pontuação a cada centro. No meu modelo, isso acontece em três rodadas. A proposta era aprender, com problemas já resolvidos, quais características costumavam indicar centros úteis e aproveitar esse aprendizado para orientar problemas novos.
Para ensinar a rede, reuni soluções cujo custo estava até 1% acima da melhor solução encontrada em cada conjunto. O rótulo de um centro era a frequência com que ele aparecia aberto nessas soluções. A função de treinamento, uma entropia cruzada binária ponderada, penalizava o desacordo entre a previsão e essa frequência. Isso faz sentido como maneira de aprender recorrência, mas introduz uma diferença importante: aparecer com frequência em boas soluções não é o mesmo que ser indispensável para construir uma boa combinação em um problema novo. A pontuação serve para ordenar candidatos; ela não é uma garantia de viabilidade, e também não deve ser interpretada como uma probabilidade calibrada de sucesso.
Essa diferença ajuda a entender por que uma métrica de classificação favorável pode coexistir com uma redução pouco útil do espaço de busca. A AUC, que no piloto ficou próxima de 0,95, avalia a capacidade de ordenar pares de exemplos de classes diferentes. Já o otimizador precisa receber um conjunto de centros que funcione como rede. Basta excluir uma opção importante para atender uma demanda difícil para que uma seleção aparentemente boa perca valor. No piloto, foi preciso conservar aproximadamente 80% dos centros para preservar a melhor solução conhecida em pelo menos 80% das instâncias. Portanto, havia aprendizado na ordenação, mas a margem para eliminar opções com segurança era bem menor do que a AUC, isoladamente, poderia sugerir.
A orientação LP parte de uma informação diferente, calculada para o problema que está sendo resolvido naquele momento. Na implementação, a pontuação considera o valor de abertura obtido na relaxação e um pequeno ajuste pelos custos reduzidos. Esses custos vêm da solução matemática e indicam, sob as condições apropriadas, uma penalidade mínima associada a afastar uma variável de seu limite. Assim, a LP leva para a ordenação informações da combinação atual de capacidades, demandas e custos. Isso oferece uma explicação plausível para sua utilidade no estudo, embora não permita atribuir toda a diferença de desempenho a uma causa única: o objetivo aprendido, a representação dos dados e o custo de inferência também fazem parte da comparação.
Por que orientar a busca e provar uma solução são tarefas diferentes
Os custos reduzidos também permitem fazer algo que uma pontuação aprendida, sozinha, não faz: justificar matematicamente a exclusão de certas opções. Suponha que a relaxação tenha fornecido um limite inferior de cem e que já exista uma solução viável de custo cento e vinte. Para um centro cuja variável está em zero na solução LP, um custo reduzido válido de vinte e cinco significa que abri-lo elevaria o limite inferior para pelo menos cento e vinte e cinco. Nesse caso, uma solução que use aquele centro não poderá melhorar a solução de cento e vinte que já conhecemos. A relação usada é L + rᵢ ≥ U, em que L é o limite inferior, rᵢ é o custo reduzido e U é o custo da solução viável.
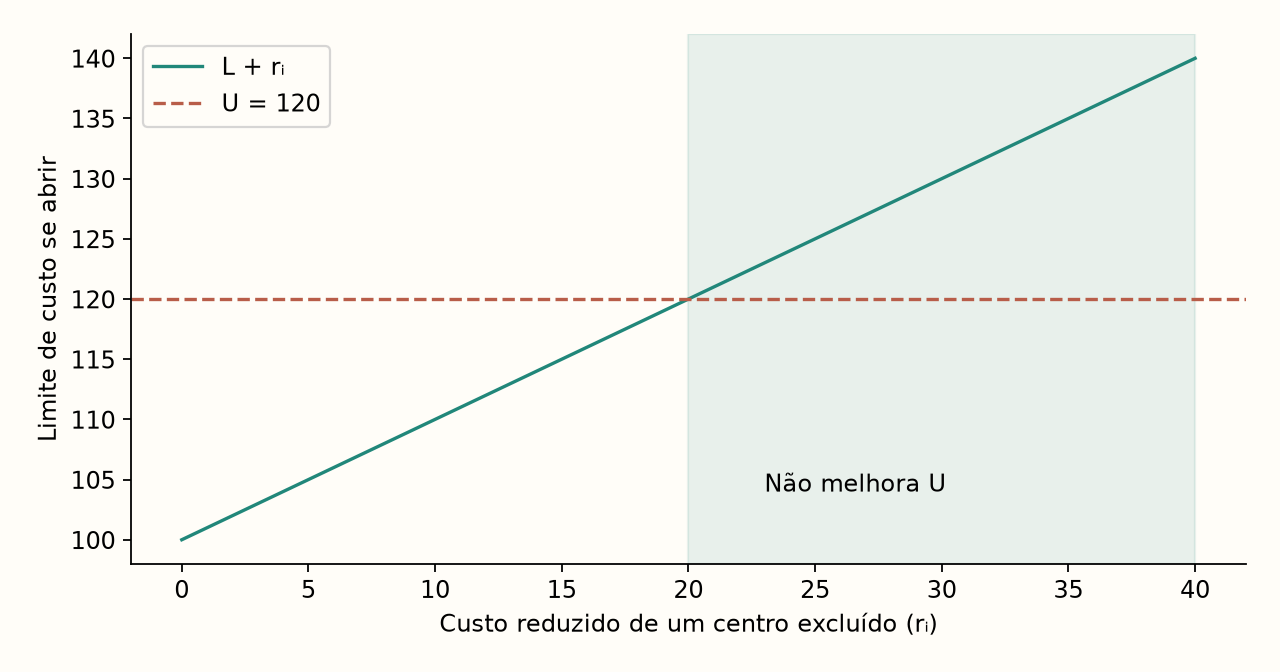
Quando essa condição vale para todos os centros excluídos e o problema restrito foi resolvido até a otimalidade, podemos certificar o resultado global, respeitando as tolerâncias numéricas. Esse raciocínio depende de um limite dual válido e das condições da variável; não basta aplicar a desigualdade a qualquer número produzido por um algoritmo. No experimento, tanto a expansão orientada por LP quanto a orientada pela GNN calculam a relaxação para aproveitar seus limites. A rede acrescenta uma forma de ordenar candidatos, mas não elimina esse cálculo. Por isso, sua orientação precisaria economizar busca suficiente para compensar também a preparação do grafo e a inferência.
Essa conta aparece com mais clareza quando olhamos para a evolução das soluções. As duas versões começam examinando 20% dos centros, ampliam o conjunto para 40% e 60% e, se necessário, chegam ao problema completo, com reparos para viabilizar as alocações. Uma boa ordenação pode fazer uma combinação útil aparecer logo nas primeiras etapas. Se as opções importantes ficaram de fora, o método precisa gastar tempo ampliando o domínio. O resultado final, portanto, depende tanto das escolhas feitas quanto do momento em que elas se tornam disponíveis para o otimizador.
O que os resultados permitem explicar
Para observar essa evolução, usei a integral primal, uma medida que acumula o desvio em relação a uma referência durante a execução. Encontrar uma boa solução cedo reduz essa medida; chegar a ela apenas perto do fim mantém por mais tempo um desvio maior. Nas 64 instâncias sintéticas executadas na AWS, a média foi 0,0326 para a expansão LP e 0,0712 para a expansão GNN. A diferença favoreceu a LP e permaneceu significativa após a correção estatística de Holm, com p = 0,00479. Já a comparação do desvio ao final do orçamento teve p = 0,0557 e não ultrapassou o critério de significância de 5%. A evidência mais clara está, portanto, na qualidade da trajetória ao longo do tempo, e não em uma superioridade final confirmada pelo mesmo critério.
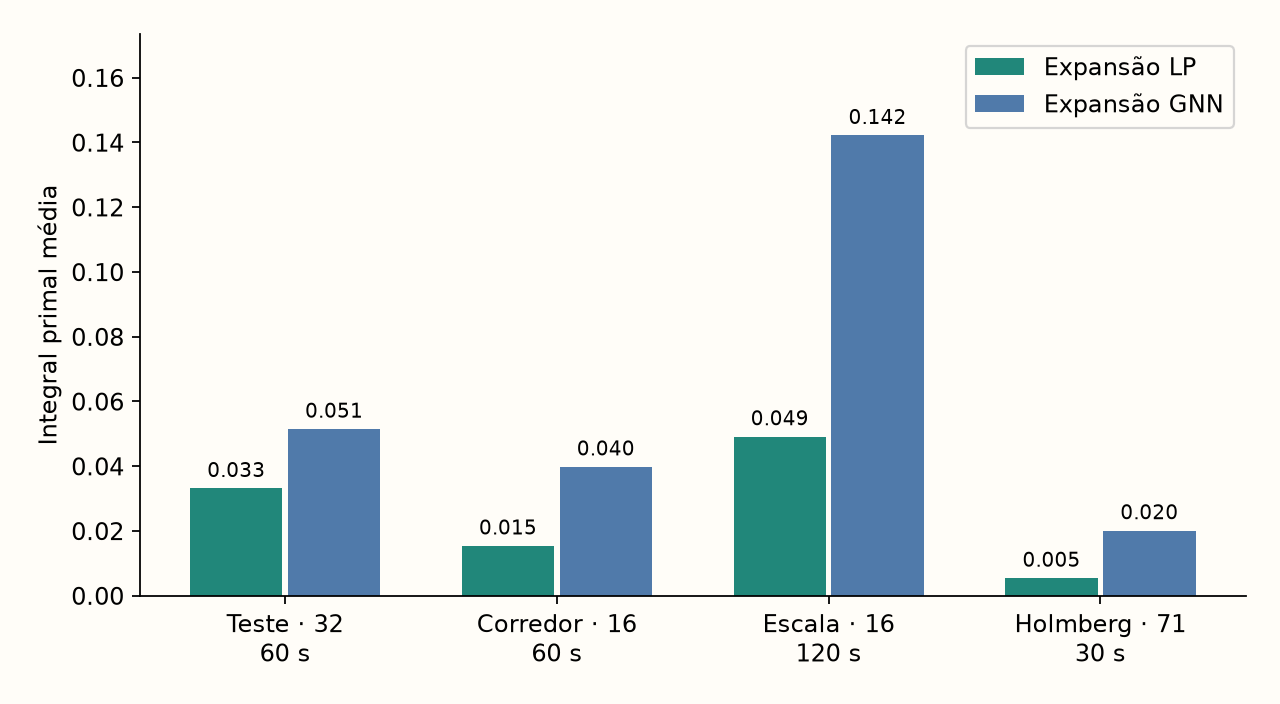
Separar os resultados por família ajuda a enxergar onde a distância entre os métodos aumenta, mas não explica sozinho por que isso acontece. A rede foi treinada com 160 instâncias de 30 centros e 150 clientes, distribuídos em geometrias uniformes e agrupadas, e apenas um dos checkpoints treinados entrou no teste de otimização. Ao mudar o tamanho do problema, organizar clientes em corredores ou introduzir custos não euclidianos, mudamos relações que ela encontrou durante o treinamento. É plausível que essa mudança tenha reduzido a utilidade da pontuação, mas o estudo não isolou seu efeito do objetivo de treinamento ou do custo computacional adicional. Os gráficos mostram o desempenho observado; atribuir uma parcela específica da diferença a cada mecanismo exigiria comparações adicionais.
Também há situações em que sobra pouco espaço para uma orientação mais complexa trazer benefício. No conjunto Holmberg, a expansão LP certificou 66 dos 71 casos antes de chegar à etapa com todos os centros. Quando a informação clássica já permite resolver rapidamente o problema, o aprendizado precisa oferecer uma economia muito expressiva para compensar seu custo adicional. Em outros cenários, uma orientação clássica pode perder força se muitos centros receberem avaliações semelhantes ou se quase todos precisarem ser recolocados no problema. Nesse caso, a redução deixa de simplificar tanto a busca e o tempo gasto construindo etapas pode consumir parte da vantagem pretendida.
Quando o obstáculo está nos movimentos permitidos
Até aqui, acompanhamos como selecionar centros pode ajudar a construir uma solução. Depois que uma solução viável já existe, surge outra possibilidade: manter parte das decisões e reorganizar apenas um grupo de clientes. Esse é o princípio do CLNS que implementei. O método libera algumas atribuições, desconta da capacidade o atendimento dos clientes que permaneceram fixos e resolve um problema menor. O benefício é concentrar o esforço em uma mudança administrável. A limitação é que o melhor resultado desse problema menor pode continuar preso às decisões que não foram liberadas.
Um exemplo simples torna essa limitação visível. Imagine dois centros com capacidade para uma unidade e dois clientes que demandam uma unidade cada. Na solução inicial, A atende o cliente 1 e B atende o cliente 2, ao custo de dez por atendimento. Se os clientes trocassem de centro, ambos os custos seriam zero. Liberar apenas um cliente, porém, não permite a mudança, porque o destino continua ocupado pelo outro. Ao liberar os dois juntos, a troca passa a ser viável e o custo cai de vinte para zero. O tempo disponível não era o problema: faltava permitir que as duas decisões mudassem de maneira coordenada.
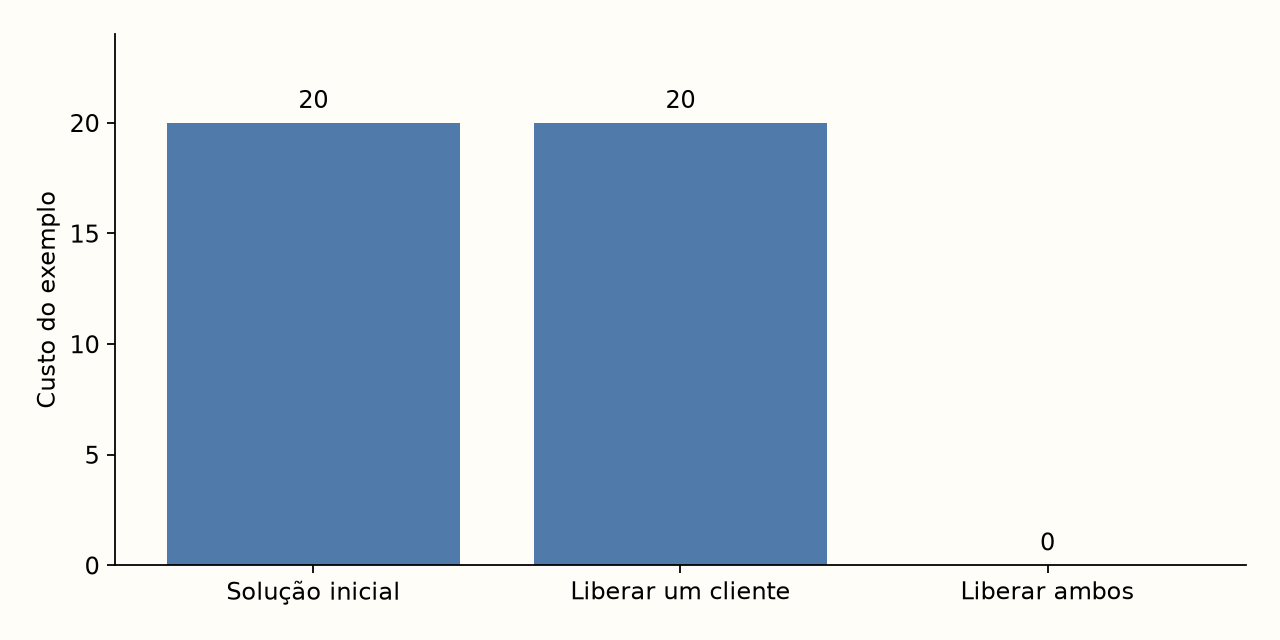
Nos diagnósticos do estudo, encontrei evidências compatíveis com esse tipo de restrição de alcance. Ao reexecutar 256 subproblemas com mais tempo, 252 terminaram com otimalidade provada e sem melhoria. Isso significa que, dentro daquelas decisões permitidas, esperar mais não revelava uma solução melhor. Quando ampliei de dez para trinta os centros candidatos por cliente, o desvio final mediano do CLNS isolado caiu de 2,46% para 1,22%, com melhora em 14 das 16 instâncias de validação. O híbrido não apresentou o mesmo benefício. Como ele parte de uma solução melhor, as oportunidades restantes são diferentes, e ampliar uma vizinhança também aumenta o trabalho necessário para explorá-la.
Escolher o método a partir da dificuldade do problema
Essas observações me levaram a olhar para a escolha do algoritmo como uma decisão sobre qual dificuldade vale a pena atacar primeiro. Se o modelo completo, resolvido pelo SCIP, já encontra boas soluções e comprova sua qualidade rapidamente, criar etapas adicionais pode trazer pouco benefício. Se a LP identifica um conjunto pequeno de centros úteis, a expansão pode aproveitar essa informação para reduzir o trabalho inicial. O kernel search explora uma ideia próxima, mantendo um núcleo de candidatos e acrescentando grupos ordenados por custos reduzidos. Ele teve a menor integral média no teste sintético, mas sua comparação com a expansão LP não estabeleceu superioridade estatística. Portanto, a média serve como pista para investigar, e não como justificativa suficiente para eleger um vencedor definitivo.
Quando a dificuldade está em reorganizar uma solução existente, o CLNS e os híbridos ganham interesse, desde que as mudanças necessárias caibam nos grupos liberados. Isso ajuda a interpretar os resultados favoráveis ao híbrido LP nos casos maiores da Olist, embora quatro casos sejam insuficientes para generalizar a conclusão. Já uma GNN tem uma oportunidade plausível quando muitos problemas compartilham uma estrutura que o treinamento consegue aprender e quando a pontuação aprendida está alinhada à decisão que realmente economiza busca. Se mudam a proporção entre demanda e capacidade, a escala ou a relação entre custos fixos e transporte, essa vantagem precisa ser reavaliada. Normalizar atributos ajuda a representar os dados, mas não garante que todas essas mudanças preservem o que foi aprendido.
Meu estudo não identificou uma distribuição capacitada na qual essa GNN tenha vencido de forma conclusiva. Para descobrir se a concentração espacial, o tamanho das demandas ou a mudança de escala explicam uma parcela específica dos resultados, seria necessário variar uma dessas características enquanto as demais permanecem comparáveis. Manter a rede fixa permitiria avaliar sua robustez; treiná-la novamente responderia à pergunta diferente de quanto ela consegue se adaptar. Essa distinção é importante porque impede transformar uma interpretação convincente em uma conclusão que os experimentos ainda não sustentam.
O que a pesquisa já permite afirmar é que as características do problema ajudam a organizar a comparação. A capacidade determina quais combinações são possíveis; a distribuição dos clientes e dos custos determina quais delas são atraentes; e o mecanismo de busca determina quais serão examinadas dentro do tempo disponível. Uma orientação aprendida precisa ser útil dentro dessa sequência, assim como uma regra clássica precisa justificar o esforço que consome. Entender por que um método funciona começa por acompanhar essas decisões, desde os dados até a solução produzida. Foi esse caminho que tornou os resultados mais informativos para mim do que uma simples classificação de algoritmos do melhor para o pior.
Dados e referências para acompanhar a análise
Esta leitura se apoia no meu manuscrito “Learning versus classical guidance in search-space reduction for single-source capacitated facility location”, nos resultados salvos da AWS e no código do projeto. O gráfico por famílias usa medições do teste; os demais são exemplos didáticos, identificados nas legendas, cuja finalidade é tornar visíveis os mecanismos discutidos. As pequenas alocações foram conferidas por enumeração, e o exemplo da relaxação também foi verificado com um solver LP. Esses exemplos acrescentam uma explicação matemática à análise, mas não constituem novos testes de desempenho da GNN.
Para situar a comparação em um contexto mais amplo, deixei também trabalhos que empregam GNNs em outras tarefas de otimização. Gasse e colaboradores investigam decisões de ramificação em um grafo de variáveis e restrições, enquanto Qian e colaboradores estudam localização uniforme sem capacidade. Como suas decisões, hipóteses e formulações diferem das minhas, os resultados precisam ser lidos dentro desses contextos. Eles ajudam a compreender por que uma comparação desfavorável em um experimento não encerra a discussão sobre aprendizado e otimização.
Ler o estudo e a preparação na AWS
Dados dos exemplos exatos (JSON)
Resultados observados por família (JSON)
Gasse et al.: aprendizado para ramificação