Otimização sem bala de prata: o que aprendi ao colocar uma GNN à prova na AWS
Da preparação dos experimentos aos resultados: quando restringir a busca ajuda, quando o aprendizado não acrescenta e por que o contexto muda a decisão.
Comecei com uma ideia atraente: treinar uma rede neural em grafos para reconhecer bons lugares para centros de distribuição e deixar um otimizador resolver um problema menor. A rede aprendeu a ordenar candidatos muito bem. Mas, ao medir a decisão completa, surgiu uma pergunta incômoda: a melhoria vinha do aprendizado ou de termos organizado melhor a busca?
O artigo que deu origem a esta postagem responde com comparações controladas, um teste fechado e uma repetição na AWS. O principal resultado favoreceu uma orientação clássica baseada em relaxação linear, sem treinamento. Isso não demonstra que GNNs sejam inúteis nem que um algoritmo clássico sempre vença. Demonstra algo mais concreto: neste problema, com este modelo treinado e estes orçamentos, a complexidade adicional não produziu a vantagem esperada.
Esta é a continuação da postagem sobre os primeiros experimentos. Naquele relato, o teste fechado estava reservado; aqui ele já foi executado em dois ambientes. Apresento os resultados documentados na versão atual do meu manuscrito de pesquisa.
Primeiro, entender a decisão logística
O problema é escolher quais centros abrir e qual região atender a partir de cada um. Abrir custa dinheiro, transportar também e cada centro tem uma capacidade máxima. Além disso, uma região deve receber toda a sua demanda de um único centro: não podemos dividi-la nem deixá-la sem atendimento. Esse é o problema de localização capacitada com fonte única, ou SSCFLP.
A capacidade conecta decisões que parecem independentes. Se duas regiões precisam de 60 unidades cada uma, elas não cabem juntas em um centro de capacidade 100. Resolver cada região separadamente pode produzir duas respostas razoáveis que, reunidas, são impossíveis. É parecido com duas pessoas reservando os mesmos assentos sem compartilhar o registro de reservas. Um bom sistema precisa coordenar as decisões, não apenas acertar cada recomendação isolada.
O que construí para investigar a pergunta
Desenvolvi um ambiente de experimentação com geradores de instâncias, separação entre treinamento, validação e teste, modelos matemáticos, métodos de busca e um avaliador independente. Esse avaliador recalcula o custo e verifica capacidade e alocação diretamente nos dados originais. Antes de medir velocidade, comparei enumeração e SCIP em 13 exemplos pequenos nos quais era possível conferir a resposta.
O treinamento usou 160 instâncias de 30 centros e 150 clientes; a validação, outras 32. O teste fechado reuniu 139 instâncias: 32 da família principal, 16 em corredores espaciais não vistos, 16 de maior tamanho, 71 do conjunto Holmberg com ótimos publicados e quatro casos derivados de pedidos da Olist. As hipóteses estatísticas principais foram avaliadas nas 64 sintéticas; os quatro casos Olist são um estudo descritivo. Na Olist, os pedidos são reais, mas capacidades e custos fixos continuam sendo hipóteses declaradas.
Como preparei a execução na AWS
Cada instância é um cenário completo, com suas demandas, custos e capacidades. Treinamento serve para aprender; validação, para escolher parâmetros; teste, para conferir o que foi escolhido em cenários reservados. Uma semente fixa as escolhas aleatórias para permitir repetir uma execução. Separar essas funções evita ajustar o método às mesmas respostas que depois serão apresentadas como evidência.
A nuvem entrou por uma necessidade de medição. Na primeira rodada, outras tarefas disputavam o processador e 16,5% das 1.390 execuções receberam uma marca de possível contenção. Houve também duas suspensões da máquina; seis execuções foram descartadas por uma regra temporal documentada e repetidas. Se um algoritmo espera pela CPU, o cronômetro mede essa espera também. Não seria correto atribuir toda a diferença ao método.
Preparei uma instância EC2 c7i.2xlarge com Ubuntu 24.04, 16 GB e quatro núcleos físicos configurados com uma thread por núcleo. Executei três experimentos simultâneos, cada um fixado a um núcleo, deixando outro para o sistema. As bibliotecas numéricas ficaram limitadas a uma thread. Não foi um treinamento massivo em GPU: o objetivo era comparar métodos em CPU sob condições controladas.
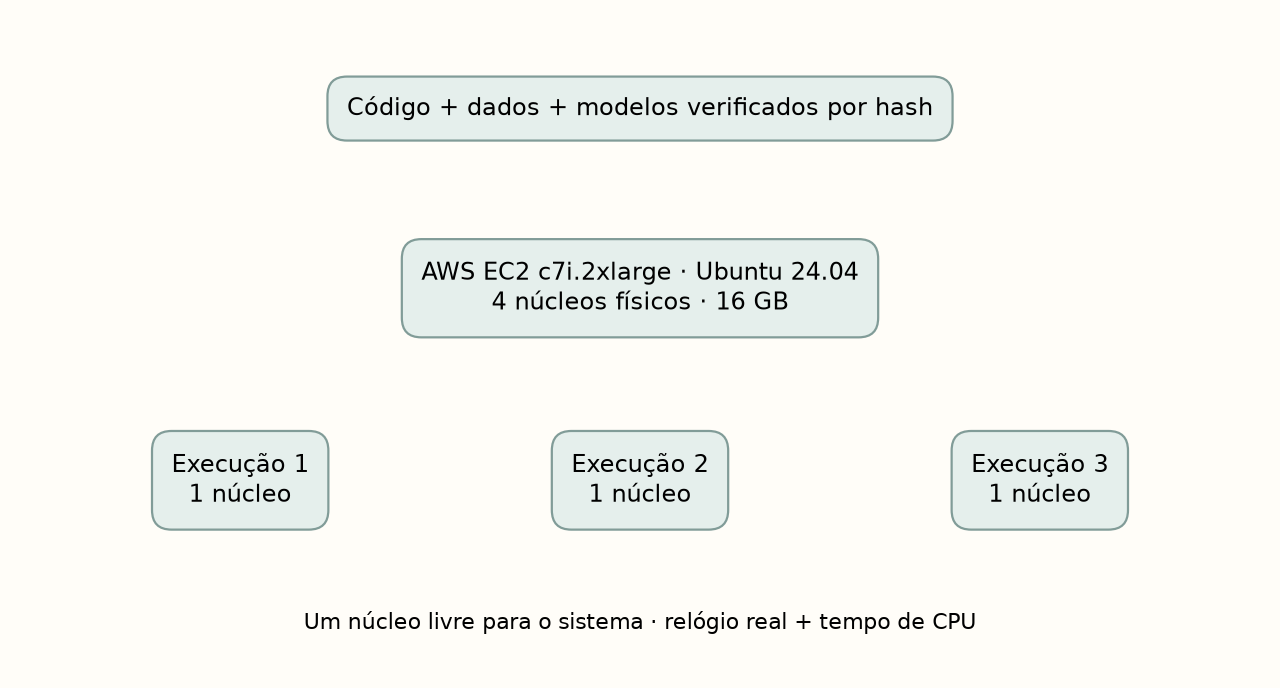
No ambiente Python, mantive o código de pesquisa idêntico byte a byte e conferi dados e modelos por hashes. Registrei versões, configuração e resultados em manifestos. No Linux, foi necessário resolver uma colisão entre as bibliotecas compartilhadas do HiGHS e do OR-Tools, alterando o identificador SONAME da libhighs; o algoritmo não foi modificado. Antes do teste, uma calibração de 24 execuções em quatro instâncias de validação conferiu o ambiente e os relógios.
O script de execução percorreu os cinco conjuntos com os mesmos métodos, sementes e orçamentos, salvou logs e permitiu novas tentativas e retomada. Também programou um desligamento de segurança em 20 horas e outro ao finalizar, depois de empacotar os resultados. Essas medidas controlam a execução; não são uma estimativa do custo da AWS. Na segunda rodada, nenhuma das 1.390 execuções foi marcada por contenção, a razão CPU/tempo real ficou próxima de 1 e o maior excesso de orçamento foi de 0,08 segundo.
Os métodos, sem mistério
O SCIP sobre o modelo completo foi a referência direta: recebe todas as decisões e busca uma solução respeitando as restrições. A relaxação linear, ou LP, permite temporariamente valores fracionários. Sua solução não é necessariamente uma rede operacional, mas fornece um limite inferior para o custo e sinais sobre quais centros vale examinar. É uma informação calculada para a instância atual, sem treinamento prévio.
A GNN representa centros e clientes como dois tipos de nós conectados por relações de atendimento. A troca de informações por essas conexões permite aprender uma pontuação para cada centro. No experimento, essa pontuação orienta a busca; não substitui as restrições nem transforma uma probabilidade alta em garantia de uma boa decisão. Embora três checkpoints tenham sido treinados, o teste de otimização usou o da semente 0.
A expansão adaptativa começa pelos centros mais bem classificados e amplia o domínio em etapas de 20%, 40%, 60% e 100%, com reparos de viabilidade. É como examinar primeiro uma seleção de opções e abrir progressivamente o catálogo, em vez de jogar o restante fora. Ela pode parar antes se os custos reduzidos permitirem certificar que nenhuma opção excluída melhora a solução e o problema restrito já estiver resolvido até a otimalidade. O kernel search cumpre uma função semelhante por meio de um núcleo de variáveis e grupos adicionais; implementei uma variante, não todos os detalhes do algoritmo original.
O CLNS libera uma parte da solução, mantém o restante e reotimiza apenas aquela parte. Desconta a capacidade já ocupada e cobra cada custo fixo uma única vez. Suas vizinhanças incluem grupos por perfis de custo, fronteiras entre grupos, clientes de centros caros e alocações desfavoráveis segundo LP. O híbrido dedica metade do orçamento à expansão e a outra metade ao CLNS. Também testei seletores por rotação, pesos adaptativos e aprendizado, além de uma memória para evitar repetir subproblemas sem melhora; essas comparações de seleção pertencem aos pilotos.
O que significa ser melhor
Não basta olhar o custo no final. Se preciso de uma resposta a qualquer momento, importa quanto tempo leva para aparecer uma solução útil. A integral primal resume essa trajetória: calcula, durante o orçamento, a média da distância relativa à melhor referência conhecida, limitada entre 0 e 1. Enquanto não há solução, vale 1. Quanto menor, melhor. Não é um percentual de economia logística nem uma medida direta da velocidade do processador.
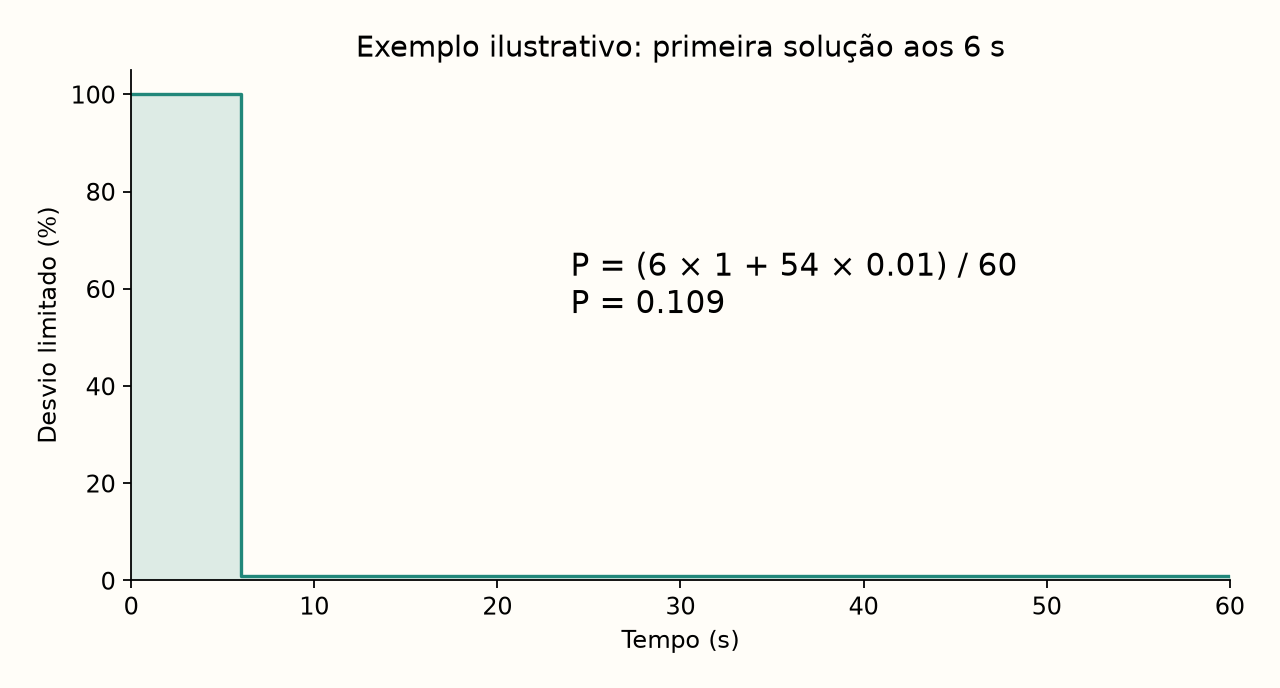
O relógio incluiu atributos, inferência, LP, reparo, construção do modelo, resolução e validação. Os orçamentos foram de 60 segundos para os casos sintéticos principais e corredores, 120 para os maiores e a Olist, e 30 para Holmberg. Agreguei as sementes dentro de cada instância antes de comparar instâncias. Usei intervalos bootstrap, Wilcoxon pareado e correção de Holm. A regra para confirmar um achado foi fixada antes da repetição: significância a 5% na nuvem e o mesmo sentido na rodada local.
O resultado que mudou minha leitura da GNN
Em linguagem cotidiana, comparar de forma pareada significa confrontar os métodos nos mesmos cenários. O bootstrap reamostra esses cenários para estimar a incerteza; a correção de Holm controla os falsos positivos ao testar várias hipóteses. Um valor p isolado não mede o tamanho da melhoria nem a probabilidade de uma explicação ser verdadeira: por isso também apresento magnitudes, intervalos e se o achado se repetiu.
Nas 64 instâncias sintéticas da rodada AWS, a expansão LP obteve integral média de 0,0326, contra 0,0611 do SCIP completo: aproximadamente 47% menos nessa métrica. A expansão GNN chegou a 0,0712. Trocar apenas o ranking de LP pelo aprendido piorou a integral em 0,0385 na média; LP venceu em 45 das 64 instâncias e o valor p corrigido foi de aproximadamente 0,005. O sentido do resultado se repetiu nos dois ambientes.
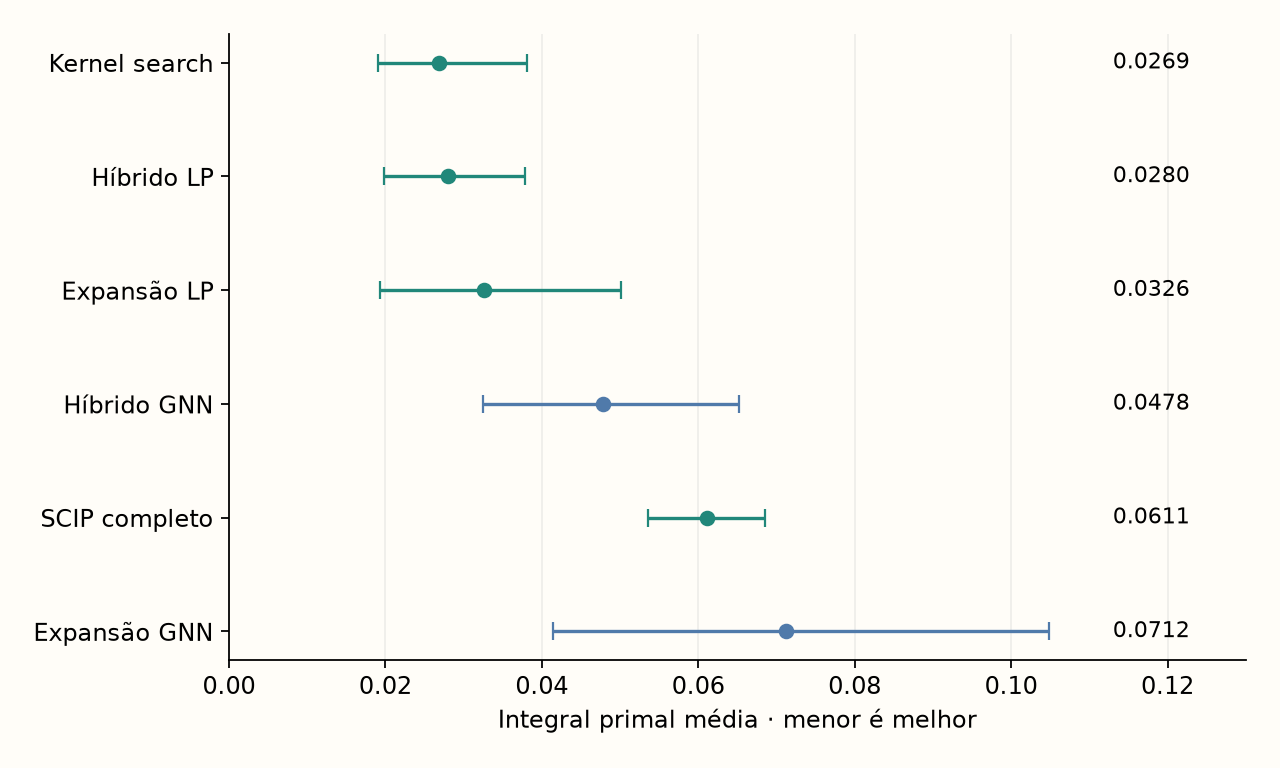
Porém, não confirmei que a GNN terminasse com custo pior: essa comparação secundária ficou em p = 0,056 após a correção. Também não confirmei uma melhoria geral por acrescentar CLNS à expansão LP. O kernel search teve a menor integral numérica, 0,0269, mas não foi demonstrada diferença em relação à expansão LP. Uma tabela ordenada sempre produz um primeiro lugar; isso não transforma toda distância entre linhas em um achado sólido.
O primeiro sinal desse problema já aparecia na filtragem. Uma AUC próxima de 0,95 indicava boa classificação, mas preservar a solução de referência em pelo menos 80% das instâncias exigia manter aproximadamente 80% dos centros. Prever bem um rótulo não garante preservar a combinação completa necessária para atender toda a demanda. A capacidade e a alocação única fazem o conjunto importar mais do que cada pontuação isolada.
Quando o tamanho muda, a resposta também muda
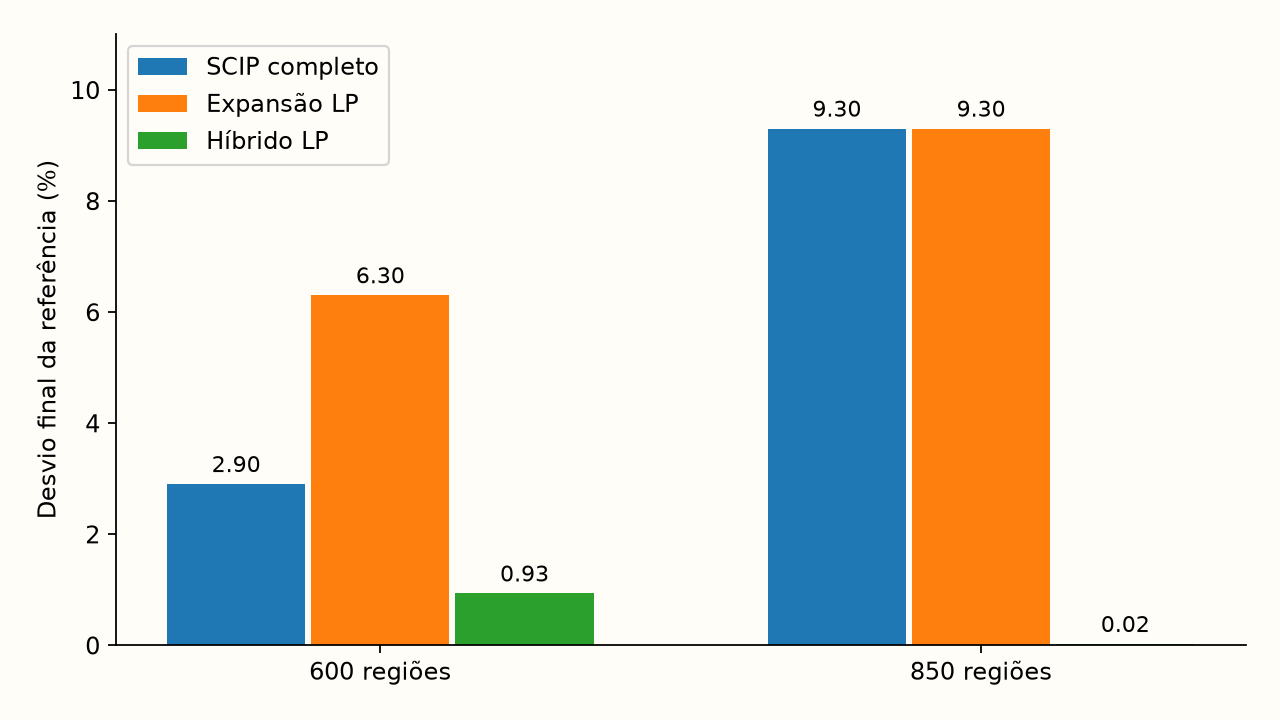
Os maiores casos Olist contam outra parte da história. Na AWS, com 600 regiões, o híbrido LP terminou aproximadamente a 0,93% da melhor solução conhecida, contra 2,9% do SCIP completo e 6,3% da expansão LP. Com 850 regiões, os valores foram 0,02%, 9,3% e 9,3%. Aqui, a reotimização coordenada trouxe uma melhoria final importante. São duas observações dentro de quatro casos, não uma garantia para qualquer rede logística.
Holmberg permitiu conferir outra propriedade: como seus ótimos são conhecidos, pude distinguir uma boa solução de uma prova de otimalidade. A expansão LP certificou o ótimo antes da última etapa em 66 de 71 instâncias, com tempo mediano de 0,4 segundo nesses casos, e alcançou o ótimo publicado em 67, contra 66 do solver completo. São instâncias pequenas pelos padrões atuais; não transferi essa velocidade para os casos grandes.
Investigar por que uma busca estaciona
Nos pilotos, entre 54% e 58% dos subproblemas selecionados já tinham falhado no mesmo estado local. A memória reduziu essa repetição para aproximadamente 25–27%, mas não trouxe uma melhoria conclusiva de qualidade. Depois repeti 256 subproblemas com mais tempo: 252 terminaram com otimalidade provada e sem melhora; apenas quatro melhoraram com 30 segundos. Esses diagnósticos usaram validação e são exploratórios. Eles sugerem que esperar mais não resolvia o principal obstáculo naqueles casos.
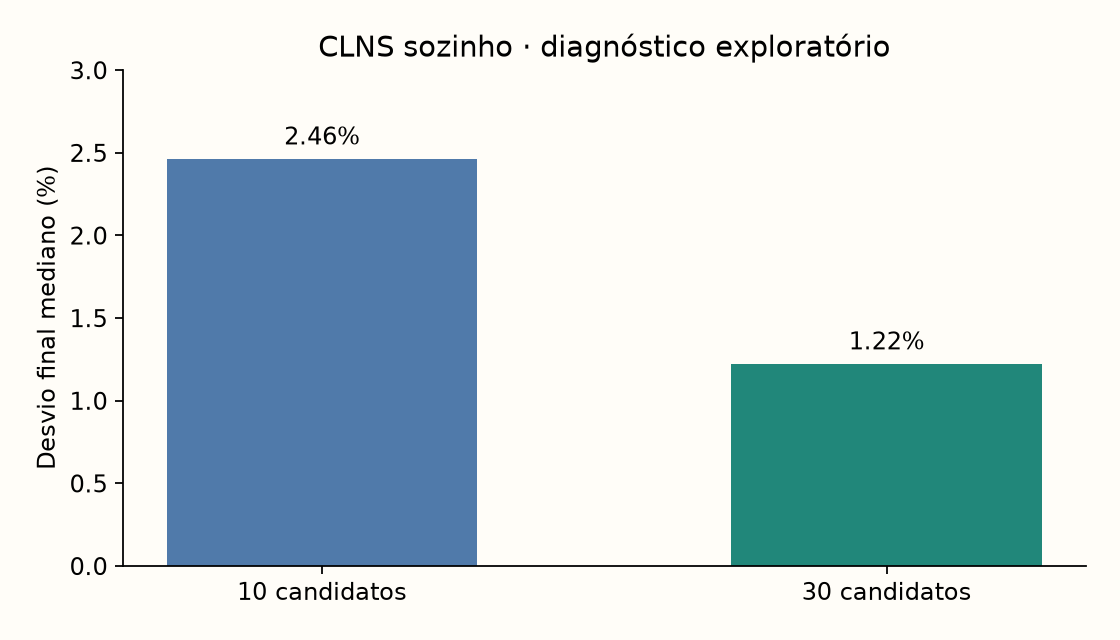
Ampliar de 10 para 30 os centros candidatos por cliente mudou o CLNS isolado: o desvio final mediano caiu de 2,46% para 1,22%, com melhora em 14 de 16 instâncias e p corrigido de 0,002. Foram resolvidos menos subproblemas, mas com maior alcance. No híbrido, que parte de uma solução melhor, essa ampliação não mostrou o mesmo benefício. Substituir os grupos por agrupamentos aleatórios do mesmo tamanho também não produziu diferenças significativas: a evidência sustenta a coordenação, não uma superioridade demonstrada do clustering.
O que significa não ter uma bala de prata
A lição prática é definir o que buscamos antes de escolher a ferramenta. Uma solução útil cedo, o menor custo ao terminar ou uma prova de otimalidade? Depois precisamos identificar as restrições, comparar com uma alternativa clássica que cumpra a mesma função e contabilizar todo o tempo gasto. Se uma GNN e uma regra LP orientam exatamente a mesma expansão, essa comparação permite separar o valor do mecanismo do valor do aprendizado.
O apêndice também traz um resultado favorável ao aprendizado: uma MPNN estabilizada generalizou melhor em escala do que Mettu–Plaxton para localização sem capacidade, antes de acrescentar busca local. Outras reconstruções, como filtros de trocas e um modelo neural dentro de um MIP de rotas, não superaram claramente seus controles clássicos. São problemas e orçamentos diferentes; não os somei ao teste principal nem os tratei como reproduções exatas dos artigos originais.
Meu estudo não prova uma lei universal sobre otimização. Seus limites incluem um único checkpoint avaliado, treinamento em um tamanho e duas famílias espaciais, predominância de dados sintéticos e referências heurísticas fora de Holmberg. As duas rodadas repetem as mesmas instâncias: replicam a medição, não uma nova amostra. Também não permitem afirmar que a AWS seja certo percentual mais rápida, porque mudam hardware, ambiente e referências. Dentro desses limites, o achado é útil: conhecer a estrutura do problema e medir a contribuição de cada componente foi mais importante do que acrescentar uma rede pelo nome.
Fontes e continuidade
Base editorial: o manuscrito “Learning versus classical guidance in search-space reduction for single-source capacitated facility location”, tabelas 10–11 e seções 5.3, 6.8 e 6.9. Os gráficos usam os resultados armazenados da segunda rodada, exceto o exemplo da integral, identificado como ilustrativo. Não foram executados novos experimentos para preparar esta publicação.