Localização capacitada e aprendizado de máquina: modelos, experimentos e resultados
Uma análise experimental de onde o aprendizado de máquina ajuda a otimização logística, com resultados, comparações clássicas e limites da evidência.

Abrir um centro de distribuição parece uma decisão local: escolher um lugar e atender seus vizinhos. Mas cada escolha altera as possibilidades do restante da rede. Neste projeto, investiguei se um modelo aprendido poderia ajudar a decidir quais centros abrir e como alocar a demanda, sem sacrificar a qualidade e contando todo o tempo necessário para produzir a solução.
Reconstruí seis frentes da literatura, P02–P07, e as conectei a experimentos de filtragem de candidatos e busca em grandes vizinhanças. Usei SCIP 10, HiGHS, OR-Tools e PyTorch em CPU. A conclusão tem um alcance específico: nestes experimentos, orientar a busca foi mais útil do que substituir suas decisões por previsões. Uma boa métrica preditiva, sozinha, não garantiu uma solução logística melhor.
O problema: uma demanda, um centro, capacidade limitada
O modelo principal é o SSCFLP: cada região deve ser atendida integralmente por um único centro aberto. Diferentemente do modelo com penalidade por demanda não atendida apresentado na série anterior, aqui o atendimento é obrigatório. Minimizamos o custo fixo de abertura mais o custo de atender as regiões, respeitando a capacidade de cada instalação.
min Σᵢ fᵢ yᵢ + Σᵢⱼ cᵢⱼ xᵢⱼ
Σᵢ xᵢⱼ = 1
Σⱼ dⱼ xᵢⱼ ≤ Qᵢ yᵢ
xᵢⱼ ≤ yᵢ
xᵢⱼ, yᵢ ∈ {0, 1}
A variável y indica se um centro abre; x, se ele atende uma região. f é o custo fixo, d a demanda e Q a capacidade. c já representa o custo de atender toda a demanda da região: multiplicá-lo novamente por d contaria a demanda duas vezes. Os custos são expressos em unidades monetárias; demanda e capacidade, em pedidos.
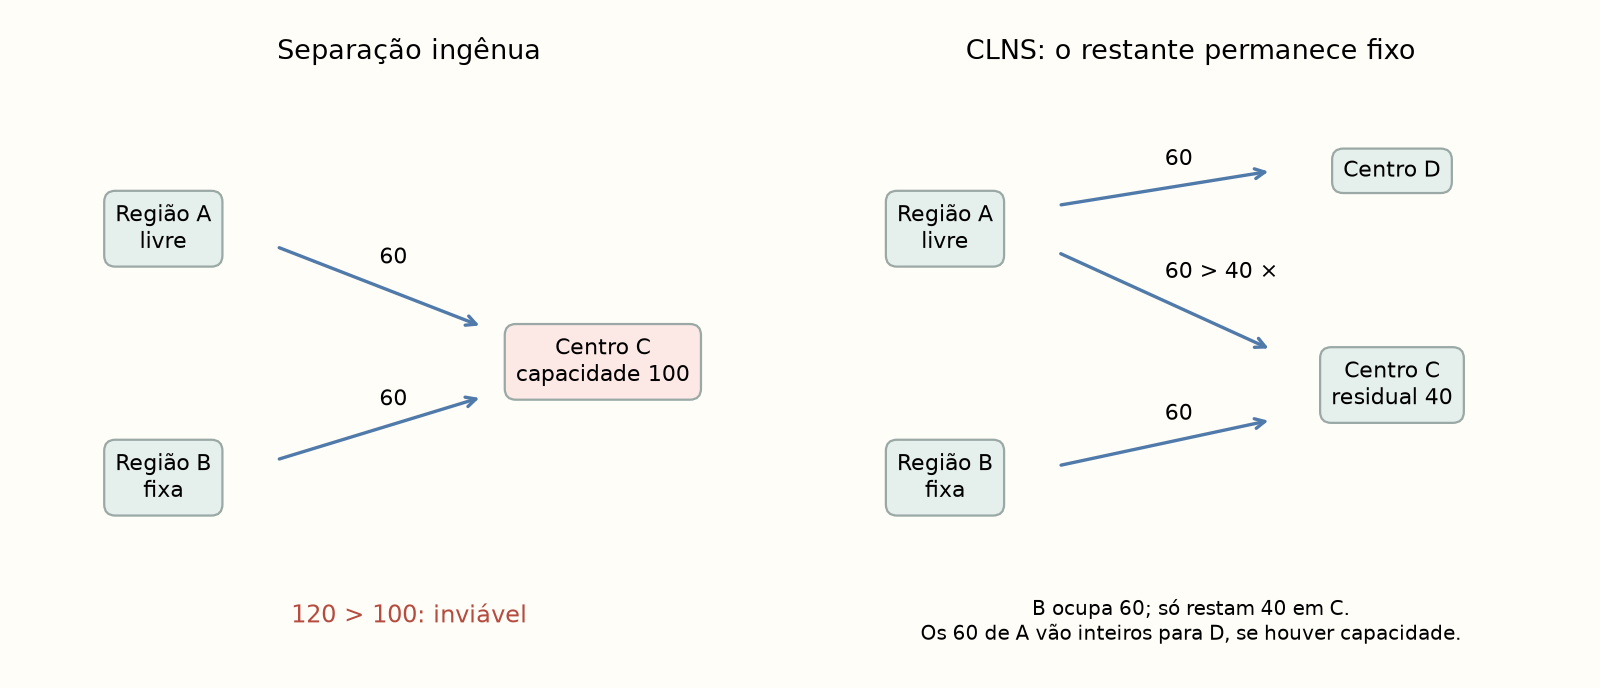
Essa dependência explica por que separar o mapa não separa automaticamente o problema. É como reservar assentos de um mesmo ônibus em dois guichês: ambos precisam conhecer as reservas do outro. Em instâncias de 30 centros e 150 regiões, o SCIP nem sempre provou o ótimo em 60 segundos; foram registrados gaps certificados de 1,8–3,6%. Em uma instância de 50 × 200, o gap chegou a 15,6%.
Dados e separação dos experimentos
| Conjunto | Instâncias | Uso e referência |
|---|---|---|
| Treinamento | 160 · 30 × 150 | Uniformes e agrupadas; SCIP 60 s + LNS 30 s; gap médio 4,4%. |
| Validação | 32 · 30 × 150 | Sementes 1000+; escolha de parâmetros. |
| Teste reservado | 32 · 30 × 150 | Sementes 2000+; preparado, não apresentado aqui como teste final concluído. |
| Corredor não visto | 16 · 30 × 150 | Generalização espacial; SCIP 60 s + LNS 30 s. |
| Escala | 16 · 50 × 200 | SCIP 120 s + LNS 60 s. |
| Holmberg | 71 · 10–30 × 50–200 | Custos não euclidianos e ótimos publicados. |
| Olist | 4 · 30 × 150 → 150 × 850 | Pedidos entregues por CEP3; ANTT; SCIP 300 s + LNS 120 s. |
O gerador sintético usou demandas U(5,35), capacidades U(10,160) reescaladas, custos fixos proporcionais à raiz da capacidade e atendimento 10 × distância × demanda. Foram testadas distribuições uniformes e agrupadas com razões de capacidade 1,5 e 3. Instâncias incompatíveis com alocação única foram descartadas por empacotamento FFD e um MILP de viabilidade.
A Olist fornece pedidos reais, mas isso não transforma todos os parâmetros em observações: custos fixos e capacidades são hipóteses do modelo. Os gaps de referência foram 0,04%, 0,7%, 3,3% e 4,2% para 150, 300, 600 e 850 regiões. Essas diferenças importam: superar uma referência heurística não equivale a provar otimalidade nem a demonstrar economia implantada em uma empresa.
Como uma melhoria foi medida
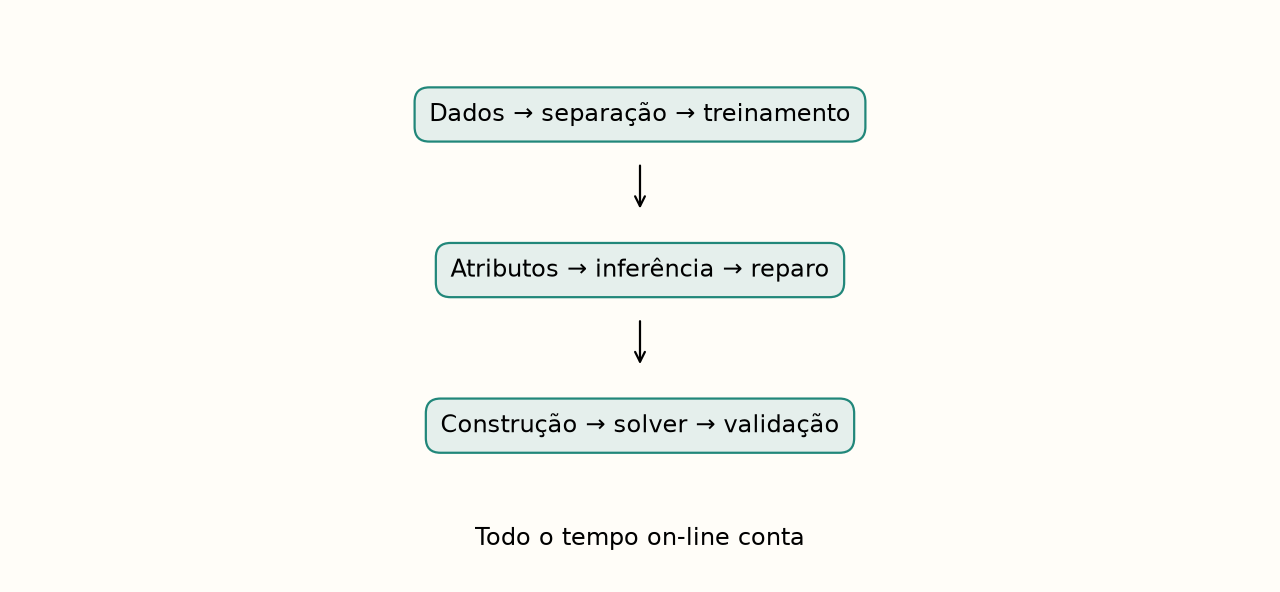
Antes de comparar velocidade, confrontei enumeração e SCIP em 13 microinstâncias de três famílias, incluindo capacidades apertadas e custos assimétricos. Um avaliador separado recalculou custos, alocação única e capacidade. O relógio incluiu atributos, inferência, relaxação linear, reparo, construção do modelo, resolução e validação.
O desvio final é (U − BKS) / BKS, em que U é o custo obtido e BKS a melhor referência validada ou o ótimo publicado. A integral primal acrescenta a trajetória: calcula, durante o orçamento de tempo, a média do desvio da melhor solução disponível, limitado a [0,1], com valor 1 enquanto não existe solução. Zero significa atingir a referência desde o início; um, permanecer sem solução ou com desvio máximo. Menor é melhor, mas uma integral menor não garante um custo final menor.
A auditoria da implementação detectou dupla contagem da construção, falta de acumulação da melhor solução entre etapas, ausência de prazo global e avaliação de apenas uma de três GNNs. A execução temporal inválida foi arquivada e o protocolo foi corrigido com manifestos de dados, modelos e código e checkpoints transacionais. Os custos e a viabilidade não foram invalidados por esses erros de relógio. A análise estatística agrega sementes por instância, usa comparações pareadas, Wilcoxon com correção de Holm e intervalos bootstrap; alvos não atingidos ficam censurados no orçamento.
Filtrar candidatos: uma boa classificação não basta
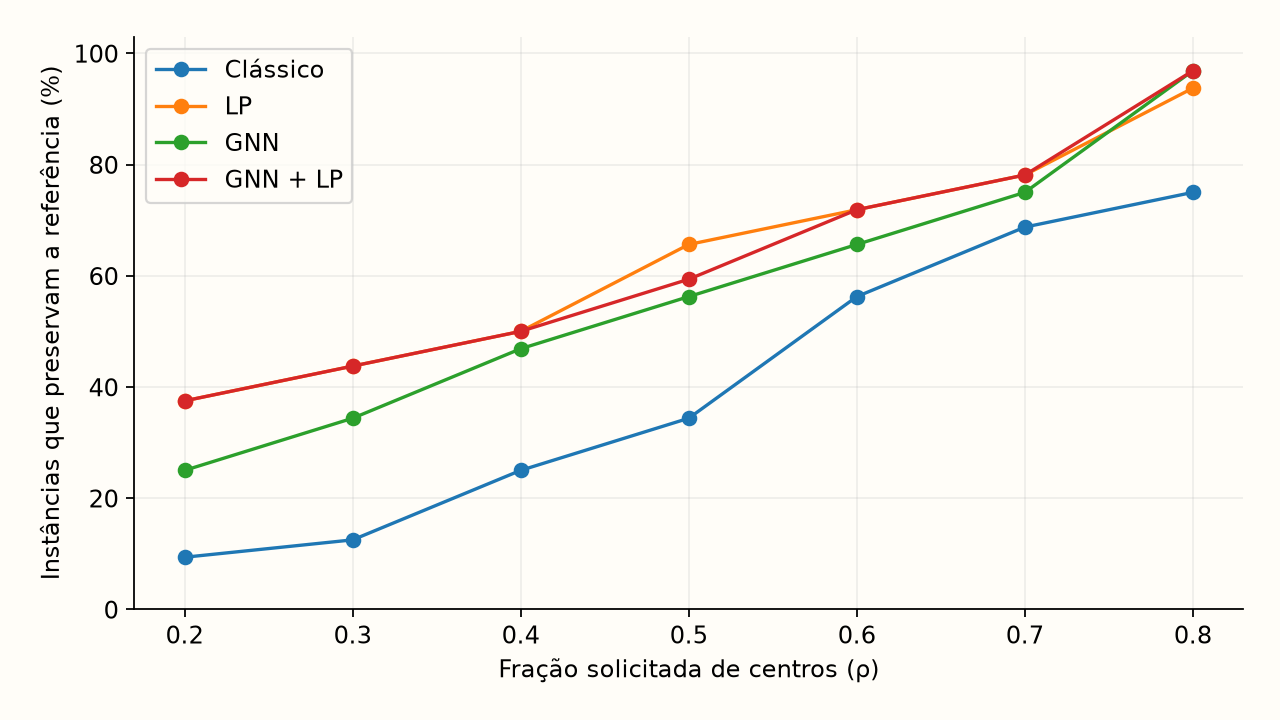
Na primeira etapa, os modelos ordenaram centros para resolver um problema reduzido. A GNN alcançou AUC próxima de 0,95, mas preservar conjuntamente os centros de uma boa solução é mais exigente do que acertar rótulos individuais. Em 32 instâncias de validação, a relaxação linear sem treinamento superou a GNN entre ρ = 0,2 e 0,7. Com ρ = 0,8, a GNN preservou a referência em 31/32 casos (96,9%) e LP em 30/32 (93,8%). A diferença foi de uma instância, ainda mantendo 80% dos centros.
UniFL: aprender uma construção e depois melhorá-la
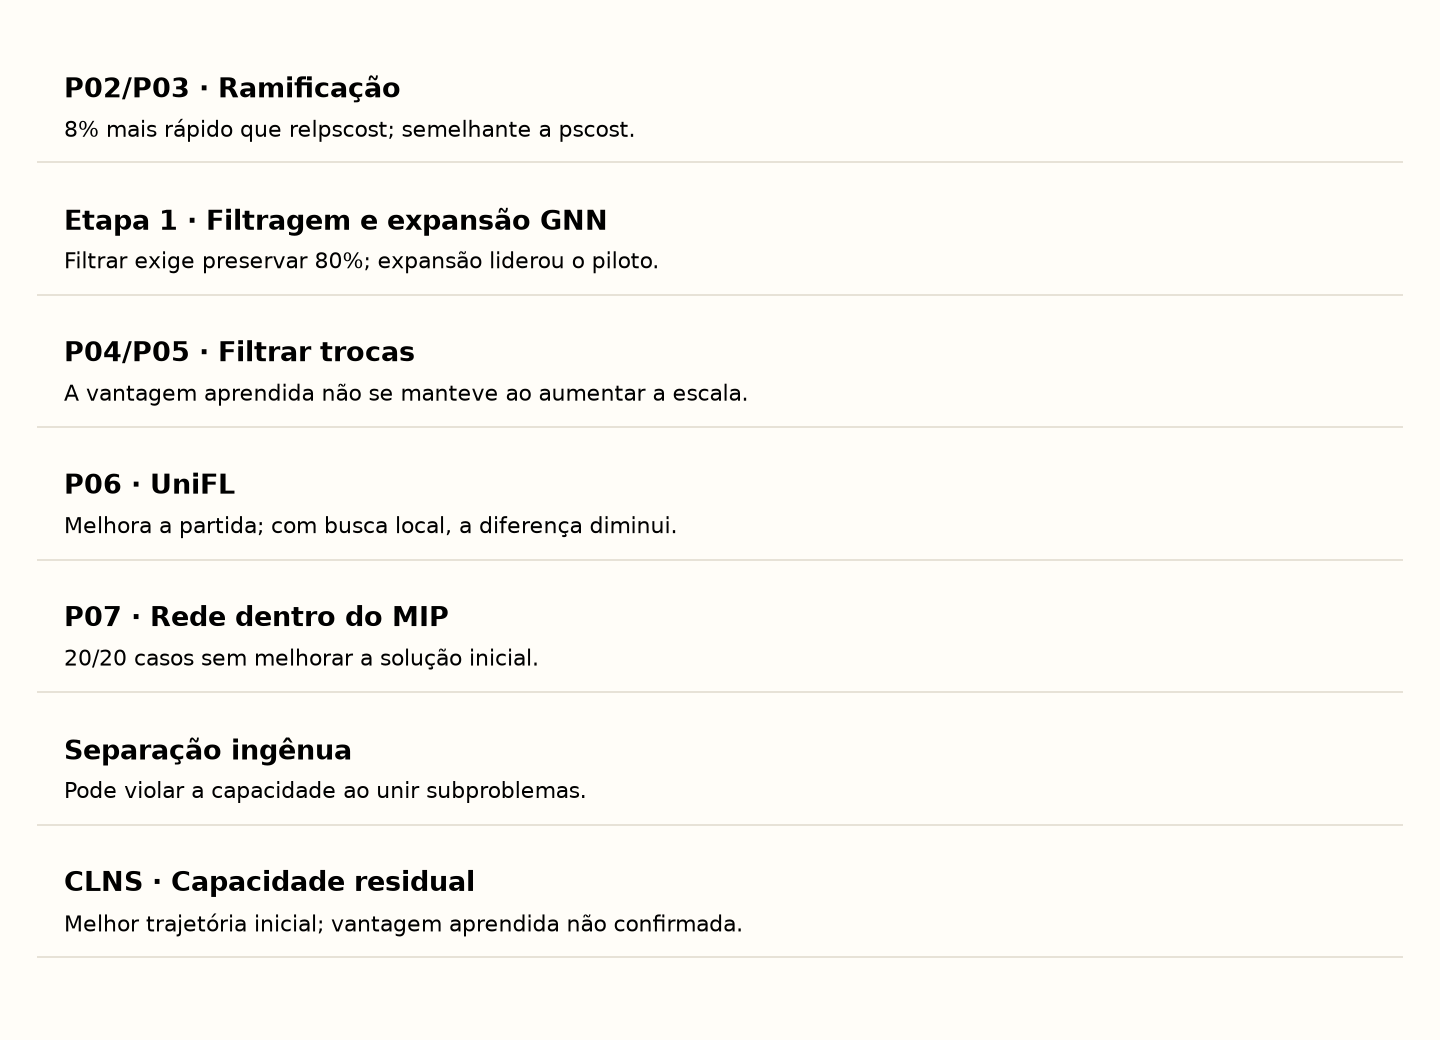
A frente P06 estudou uma variante diferente: sem capacidade e com custo uniforme de abertura. Uma MPNN de quatro camadas aprendeu sem rótulos, minimizando o custo esperado; foi treinada com n = 100 e 200. Em 56 instâncias, a versão estabilizada chegou a uma razão de custo próxima de 1,03 com n = 1000, contra 1,19 do Mettu–Plaxton. Aqui, a referência para n = 1000 é a melhor solução encontrada, não um ótimo provado. Com busca local, ambos os métodos ficaram a aproximadamente 0,6% ou menos de suas referências: grande parte da vantagem desapareceu.
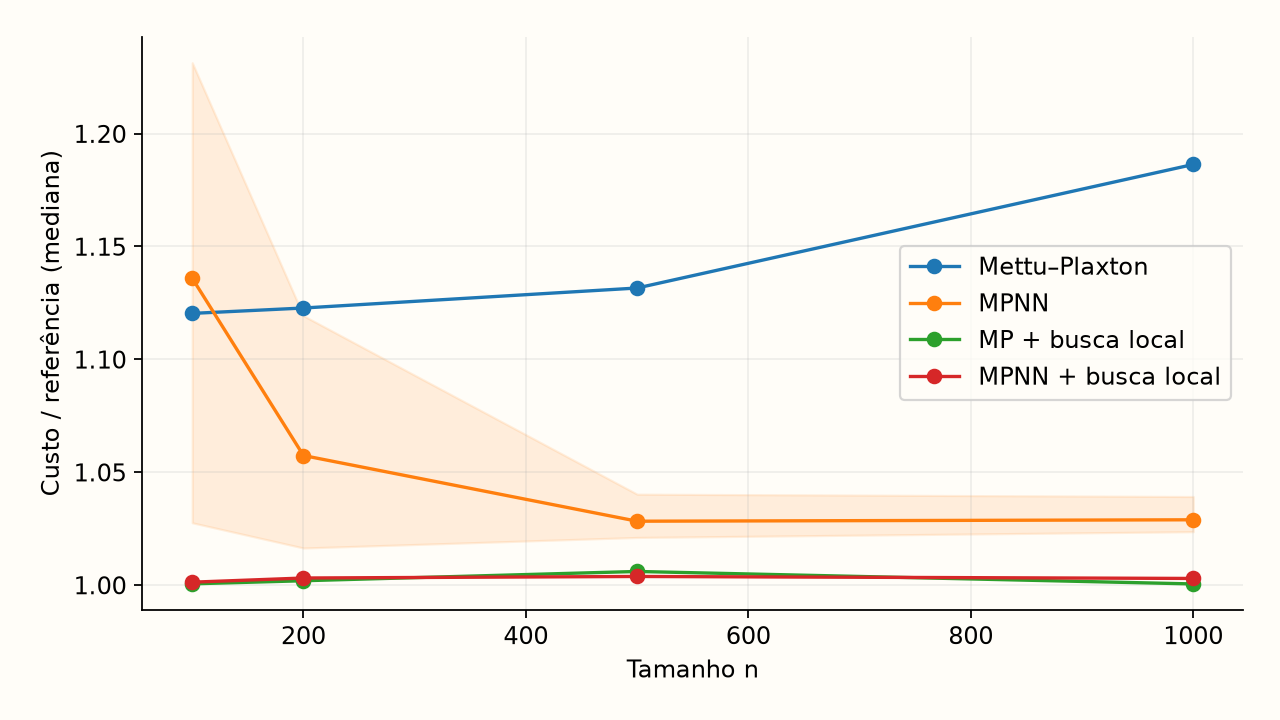
A versão pré-registrada sofreu colapso em três de quatro modelos: abriam um único centro e geravam razões de custo entre 3 e 6. A correção limitou probabilidades a 0,01–0,99, recortou gradientes em 1 e reduziu a taxa de aprendizado para 5 × 10⁻⁴. Foi aplicada depois de observar o teste e registrada como desvio do protocolo; portanto, a versão estável não constitui uma confirmação independente em dados intocados.
Filtrar trocas: velocidade em troca de quê
As frentes P04/P05 reduziram as trocas avaliadas pela busca local. O modelo aprendido, treinado em n = 200, obteve desvio de 3,5%, contra 5,1% do filtro clássico, sem fallback. Em n = 500 e 1000, perdeu essa vantagem. Em n = 1000, o clássico alcançou aproximadamente 47× de aceleração e 6,6% de desvio; o aprendido, 14× e 8,8%; o aleatório, 622× e 19,9%. A aceleração compara tempos pareados a partir do mesmo início; os desvios usam a melhor referência encontrada.
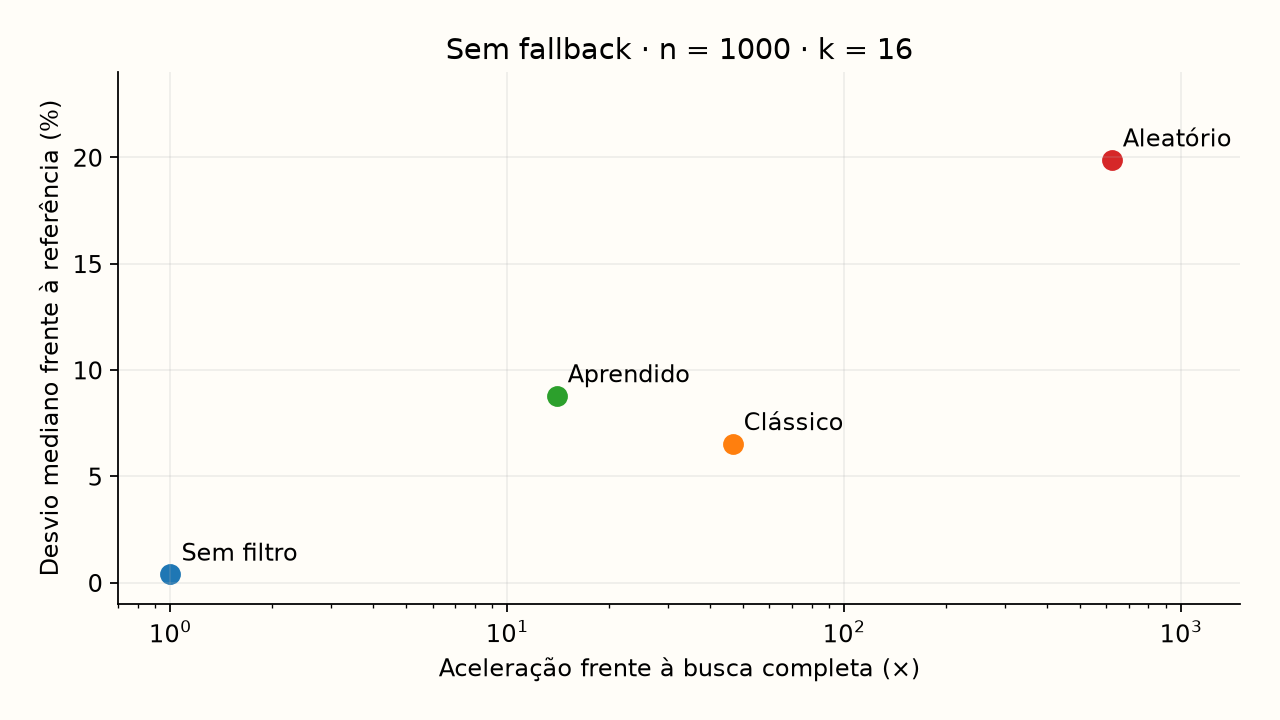
Com fallback, a vizinhança completa volta a ser examinada quando o filtro não encontra melhora. A qualidade se aproxima da busca completa, mas a aceleração fica em torno de 1,1–1,6×. Calcular atributos e chamar o modelo também consome tempo: o filtro aprendido foi mais lento do que o clássico. A comparação relevante é entre filtros com orçamentos equivalentes, não apenas contra a busca sem filtragem.
Redes dentro do MIP e decisões de ramificação
A frente P07 incorporou um preditor Deep Sets ao MIP de localização e rotas, por big-M. Um MAPE de 7,5% parecia favorável, mas Kendall τ = 0,34 mostrou que ordenar decisões era bem mais difícil. Em 20 de 20 casos, o MIP neural não melhorou sua solução inicial. Em um caso com 50 clientes, o limite inferior foi 9222 e o custo 63746: o gap de 591% usa (U − L) / L; com U no denominador seria aproximadamente 85,5%. Não são convenções intercambiáveis.
| Método LRP | Desvio mediano (%) | Desvio médio (%) | Melhor (%) | Tempo MIP (s) |
|---|---|---|---|---|
| Contínuo clássico | 0.03 | 0.67 | 45 | 1.5 |
| NEO SCIP | 0.05 | 0.69 | 45 | 61 |
| NEO: melhor início | 0.08 | 1.33 | 40 | 61 |
| NEO: busca substituta | 0.30 | 1.48 | 45 | 2 |
| FLP → VRP | 4.54 | 5.60 | 15 | 0.1 |
A avaliação usou rotas do OR-Tools em 20 instâncias CLRP de 20–100 clientes. Os percentuais de melhor resultado admitem empates. É uma comparação de qualidade com orçamentos próprios, não um teste com tempo total igual. A aproximação contínua clássica, sem treinamento, empatou ou venceu as alternativas neurais.
As frentes P02/P03 aprenderam decisões de ramificação, reconstruídas em SCIP 10 com LightGBM. Em 20 instâncias de 100 × 100, a política aprendida foi aproximadamente 8% mais rápida do que relpscost, embora tenha explorado mais de três vezes seus nós. Praticamente empatou com pscost. Foram usadas 953 amostras de treinamento, contra cerca de 100 mil do estudo original; a inferência consumiu 0,4% do tempo. A acurácia top-1 foi 0,36, contra 0,39 da regra mais fracionária.
| Ramificação | Resolvidas em 300 s | Tempo geom. deslocado (s) | Nós |
|---|---|---|---|
| LightGBM | 95% | 91.7 | 167 |
| pscost | 95% | 93.2 | 165 |
| relpscost | 95% | 100.1 | 49 |
| fullstrong | 90% | 107.4 | 23 |
CLNS: reorganizar uma parte sem romper o conjunto
Resolver grupos geográficos de forma independente e uni-los falhou em três instâncias de validação, com sobrecargas de 690–1070 unidades. Repará-las deixou custos 19–29% superiores à referência. O CLNS evitou essa separação: liberou um subproblema por vez, manteve o restante fixo, descontou sua ocupação da capacidade disponível e contou o custo fixo uma única vez.
Foram testadas quatro vizinhanças: interior de um grupo, fronteira entre dois grupos, liberação de um centro caro e clientes com maior arrependimento segundo informações duais de LP. Cinco seletores escolheram qual vizinhança resolver: rotação, aleatório, ALNS, dual e aprendido. O seletor LightGBM estimou ganho por segundo e obteve AUC 0,76 em validação separada por instância.
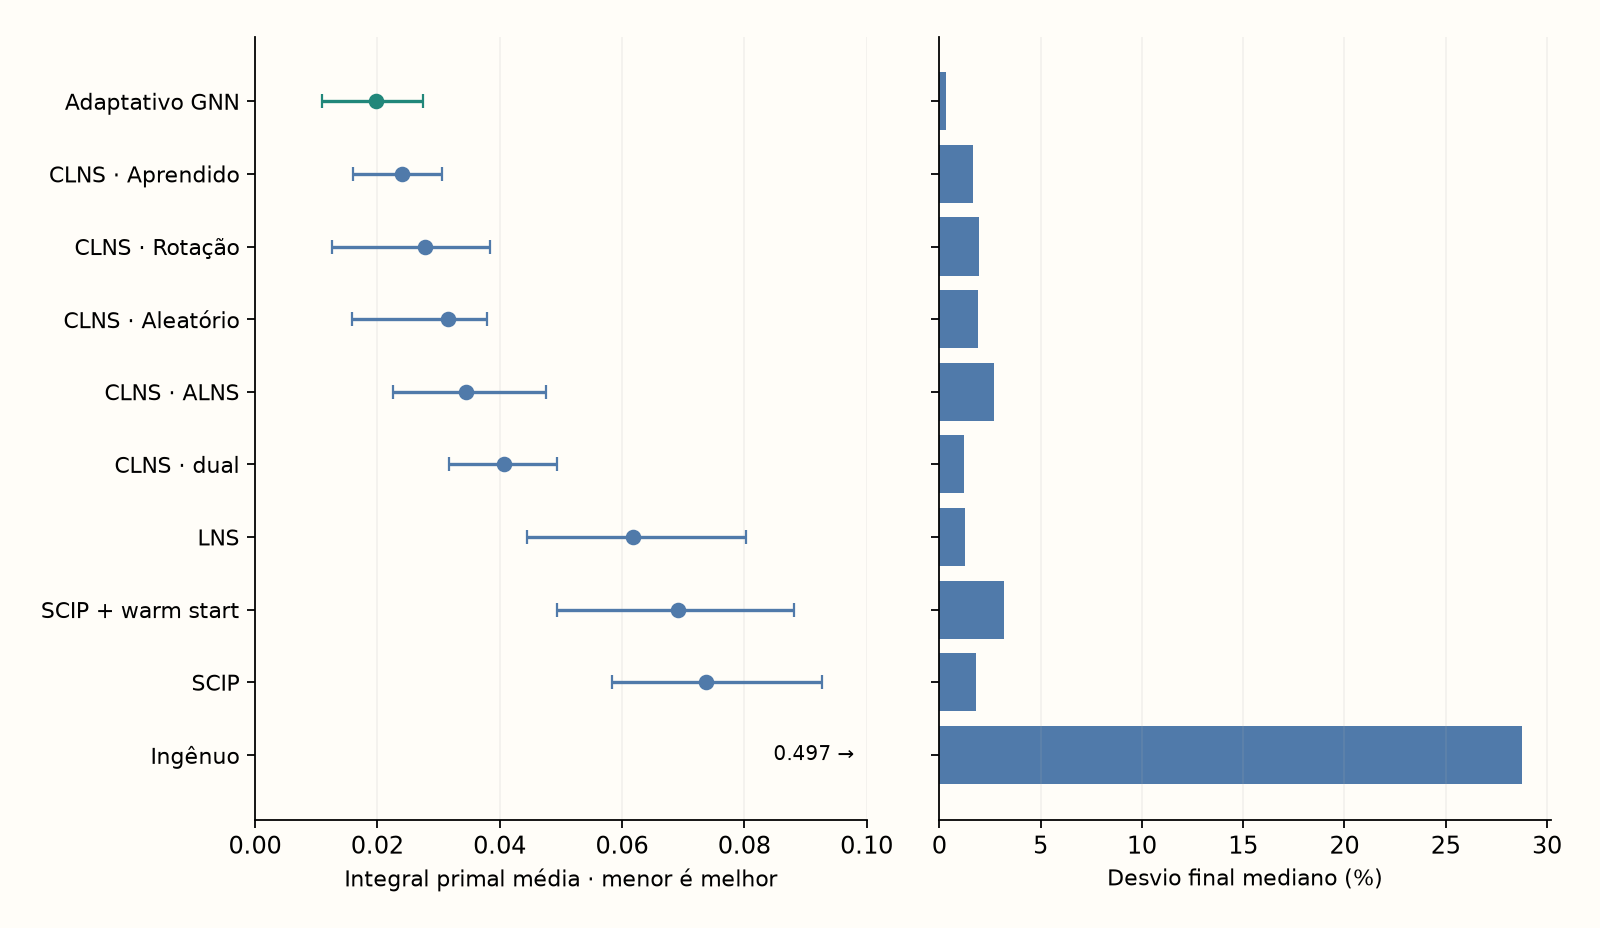
O CLNS alcançou integrais médias de 0,024–0,041, contra 0,062–0,074 de LNS e SCIP, e desvios finais medianos de 1,2–2,7%. O seletor aprendido obteve a melhor integral agregada do CLNS, mas a rotação venceu em cerca de 62% das instâncias; p = 0,43 não sustentou superioridade estatística do aprendizado. A expansão adaptativa GNN + informações de LP obteve integral 0,0198 e desvio mediano de 0,32%. São resultados deste piloto de validação, não do teste fechado reservado.
O que os resultados demonstram e o que não demonstram
O projeto permitiu identificar mecanismos úteis e limites concretos. A busca preservou a viabilidade global quando os subproblemas respeitaram a capacidade residual. Os modelos aprendidos ordenaram candidatos e vizinhanças, mas não superaram sistematicamente alternativas clássicas equivalentes. LP foi um filtro forte; Mettu–Plaxton com busca local absorveu grande parte da vantagem neural; uma aproximação contínua competiu com o MIP neural. O número relevante depende da decisão: rapidez para obter uma boa solução, custo final ou prova de otimalidade.
A execução usou CPU, com até três processos em quatro núcleos físicos, e dados majoritariamente sintéticos. Holmberg oferece uma referência externa; em outros casos, BKS continua sendo heurística. São reconstruções metodológicas em um ambiente aberto, não reproduções exatas de ambientes históricos ou do Gurobi. Mudanças de solver, escala e orçamento limitam a transferência das conclusões. Os gráficos desta publicação foram reconstruídos a partir dos CSVs armazenados; não representam novas execuções dos experimentos.