Optimización sin bala de plata: lo que aprendí al poner una GNN a prueba en AWS
De la preparación de los experimentos a los resultados: cuándo restringir la búsqueda ayuda, cuándo el aprendizaje no aporta y por qué el contexto cambia la decisión.
Empecé con una idea atractiva: entrenar una red neuronal en grafos para reconocer buenos lugares para centros de distribución y dejar que un optimizador resolviera un problema más pequeño. La red aprendió a ordenar candidatos bastante bien. Sin embargo, al medir la decisión completa, apareció una pregunta incómoda: ¿la mejora venía del aprendizaje o de haber organizado mejor la búsqueda?
El artículo que dio origen a esta publicación responde mediante comparaciones controladas, un test cerrado y una repetición en AWS. El resultado principal favoreció una guía clásica basada en relajación lineal, sin entrenamiento. Eso no demuestra que las GNN sean inútiles ni que un algoritmo clásico gane siempre. Demuestra algo más concreto: en este problema, con este modelo entrenado y estos presupuestos, la complejidad añadida no produjo la ventaja esperada.
Esta es la continuación de la publicación sobre los primeros experimentos. Allí el test cerrado estaba reservado; aquí ya fue ejecutado en dos entornos. Presento los resultados documentados en la versión actual de mi manuscrito de investigación.
Primero, entender la decisión logística
El problema consiste en elegir qué centros abrir y qué región atender desde cada uno. Abrir cuesta dinero, transportar también y cada centro tiene una capacidad máxima. Además, una región debe recibir toda su demanda desde un único centro: no se permite dividirla ni dejarla sin atender. Es el problema de localización capacitada con fuente única, o SSCFLP.
La capacidad conecta decisiones que parecen independientes. Si dos regiones necesitan 60 unidades cada una, no caben juntas en un centro de capacidad 100. Resolver cada región por separado puede producir dos respuestas razonables que, al juntarse, son imposibles. Es parecido a dos personas reservando los mismos asientos sin compartir el registro de reservas. Un buen sistema necesita coordinar las decisiones, no solo acertar cada recomendación aislada.
Qué construí para investigar la pregunta
Desarrollé un entorno de experimentación con generadores de instancias, separación entre entrenamiento, validación y test, modelos matemáticos, métodos de búsqueda y un evaluador independiente. Este último recalcula el coste y verifica capacidad y asignación directamente sobre los datos originales. Antes de medir velocidad, comparé enumeración y SCIP en 13 ejemplos pequeños en los que era posible comprobar la respuesta.
El entrenamiento utilizó 160 instancias de 30 centros y 150 clientes; la validación, otras 32. El test cerrado reunió 139 instancias: 32 de la familia principal, 16 en corredores espaciales no vistos, 16 de mayor tamaño, 71 del conjunto Holmberg con óptimos publicados y cuatro casos derivados de pedidos de Olist. Las hipótesis estadísticas principales se evaluaron sobre las 64 sintéticas; los cuatro casos Olist son un estudio descriptivo. En Olist, los pedidos son reales, pero capacidades y costes fijos siguen siendo supuestos declarados.
Cómo preparé la ejecución en AWS
Cada instancia es un escenario completo, con sus demandas, costes y capacidades. Entrenamiento sirve para aprender; validación, para elegir parámetros; test, para comprobar lo elegido en escenarios reservados. Una semilla fija las elecciones aleatorias para poder repetir una ejecución. Separar estas funciones evita ajustar el método a las mismas respuestas que después se presentan como evidencia.
La nube entró por una necesidad de medición. En la primera ronda, otras tareas competían por el procesador y el 16,5% de las 1.390 ejecuciones recibió una marca de posible contención. Hubo además dos suspensiones de la máquina; seis ejecuciones se descartaron por una regla temporal documentada y se repitieron. Si un algoritmo espera por la CPU, el cronómetro mide también esa espera. No sería correcto atribuir toda la diferencia al método.
Preparé una instancia EC2 c7i.2xlarge con Ubuntu 24.04, 16 GB y cuatro núcleos físicos configurados con un hilo por núcleo. Ejecuté tres experimentos simultáneos, cada uno fijado a un núcleo, dejando otro para el sistema. Las bibliotecas numéricas se limitaron a un hilo. No fue un entrenamiento masivo en GPU: el objetivo era comparar métodos en CPU con condiciones controladas.
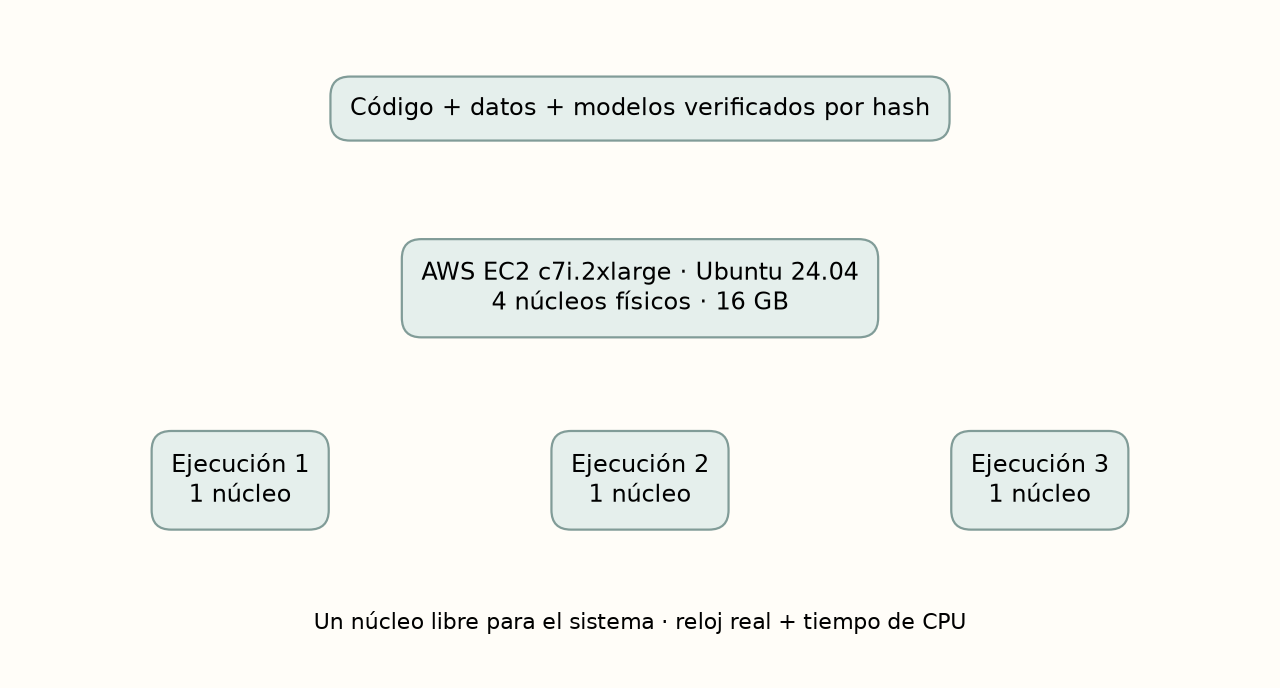
En el entorno Python, conservé el código de investigación idéntico byte a byte y comprobé datos y modelos mediante hashes. Registré versiones, configuración y resultados en manifiestos. En Linux fue necesario resolver una colisión entre las bibliotecas compartidas de HiGHS y OR-Tools, cambiando el identificador SONAME de libhighs; no se cambió el algoritmo. Antes del test, una calibración de 24 ejecuciones sobre cuatro instancias de validación comprobó el entorno y los relojes.
El script de ejecución recorrió los cinco conjuntos con los mismos métodos, semillas y presupuestos, guardó logs y permitió reintentos y reanudación. También programó un apagado de seguridad a las 20 horas y otro al terminar, tras empaquetar los resultados. Esas medidas controlan la ejecución; no son una estimación del coste de AWS. En la segunda ronda, ninguna de las 1.390 ejecuciones quedó marcada por contención, la razón CPU/tiempo real fue aproximadamente 1 y el mayor exceso de presupuesto fue 0,08 segundos.
Los métodos, sin misterio
SCIP sobre el modelo completo fue la referencia directa: recibe todas las decisiones y busca una solución respetando las restricciones. La relajación lineal, o LP, permite temporalmente valores fraccionarios. Su solución no es necesariamente una red operativa, pero aporta un límite inferior del coste y señales sobre qué centros conviene examinar. Es información calculada para la instancia actual, sin entrenamiento previo.
La GNN representa centros y clientes como dos tipos de nodos conectados por relaciones de servicio. El intercambio de información por esas conexiones permite aprender una puntuación para cada centro. En el experimento, esa puntuación orienta la búsqueda; no sustituye las restricciones ni convierte una probabilidad alta en garantía de una buena decisión. Aunque se entrenaron tres checkpoints, el test de optimización utilizó el de la semilla 0.
La expansión adaptativa empieza por los centros mejor clasificados y amplía el dominio en etapas de 20%, 40%, 60% y 100%, con reparaciones de factibilidad. Es como examinar primero una selección de opciones y abrir progresivamente el catálogo, en lugar de tirar el resto. Puede detenerse antes si los costes reducidos permiten certificar que ninguna opción excluida mejora la solución y el problema restringido ya está resuelto a optimalidad. Kernel search cumple una función parecida mediante un núcleo de variables y grupos adicionales; implementé una variante, no todos los detalles del algoritmo original.
CLNS libera una parte de la solución, conserva el resto y vuelve a optimizar solo esa parte. Descuenta la capacidad ya ocupada y cobra cada coste fijo una sola vez. Sus vecindarios incluyen grupos por perfiles de coste, fronteras entre grupos, clientes de centros caros y asignaciones desfavorables según LP. El híbrido dedica la mitad del presupuesto a expansión y la otra mitad a CLNS. También probé selectores por rotación, pesos adaptativos y aprendizaje, además de una memoria para evitar repetir subproblemas sin mejora; esas comparaciones de selección pertenecen a los pilotos.
Qué significa ser mejor
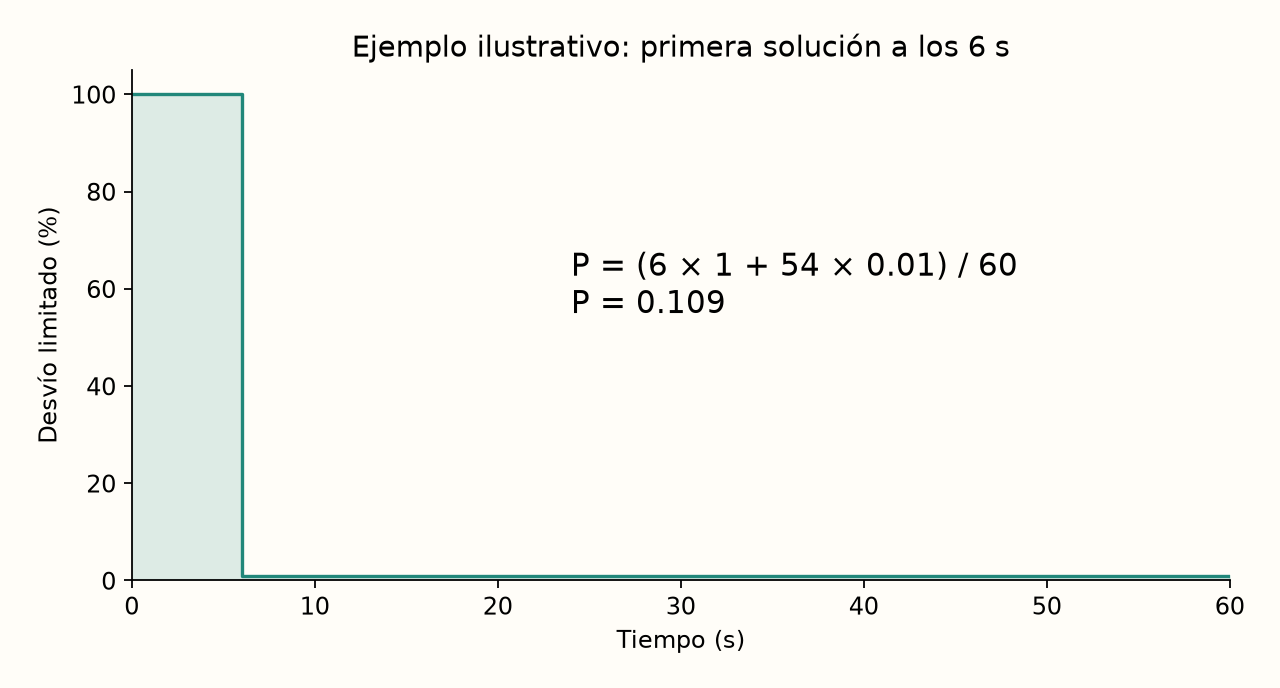
No basta con mirar el coste al final. Si necesito una respuesta en cualquier momento, importa cuánto tarda en aparecer una solución útil. La integral primal resume esa trayectoria: promedia durante el presupuesto la distancia relativa a la mejor referencia conocida, limitada entre 0 y 1. Mientras no hay solución, vale 1. Cuanto menor, mejor. No es un porcentaje de ahorro logístico ni una medida directa de velocidad del procesador.
El reloj incluyó atributos, inferencia, LP, reparación, construcción del modelo, resolución y validación. Los presupuestos fueron 60 segundos para los casos sintéticos principales y corredores, 120 para los mayores y Olist, y 30 para Holmberg. Promedié semillas dentro de cada instancia antes de comparar instancias. Utilicé intervalos bootstrap, Wilcoxon pareado y corrección de Holm. La regla para confirmar un hallazgo se fijó antes de repetir: significación al 5% en la nube y el mismo sentido en la ronda local.
El resultado que cambió mi lectura de la GNN
En lenguaje cotidiano, comparar de forma pareada significa enfrentar los métodos en los mismos escenarios. El bootstrap vuelve a muestrear esos escenarios para estimar la incertidumbre; la corrección de Holm controla los falsos positivos al probar varias hipótesis. Un valor p aislado no mide el tamaño de la mejora ni la probabilidad de que una explicación sea verdadera: por eso también informo magnitudes, intervalos y si el hallazgo se repitió.
En las 64 instancias sintéticas de la ronda AWS, la expansión LP obtuvo integral media 0,0326, frente a 0,0611 del SCIP completo: aproximadamente un 47% menos en esa métrica. La expansión GNN llegó a 0,0712. Cambiar solo el ranking de LP por el aprendido empeoró la integral en 0,0385 en promedio; LP ganó en 45 de 64 instancias y el valor p corregido fue aproximadamente 0,005. El sentido del resultado se repitió en ambos entornos.
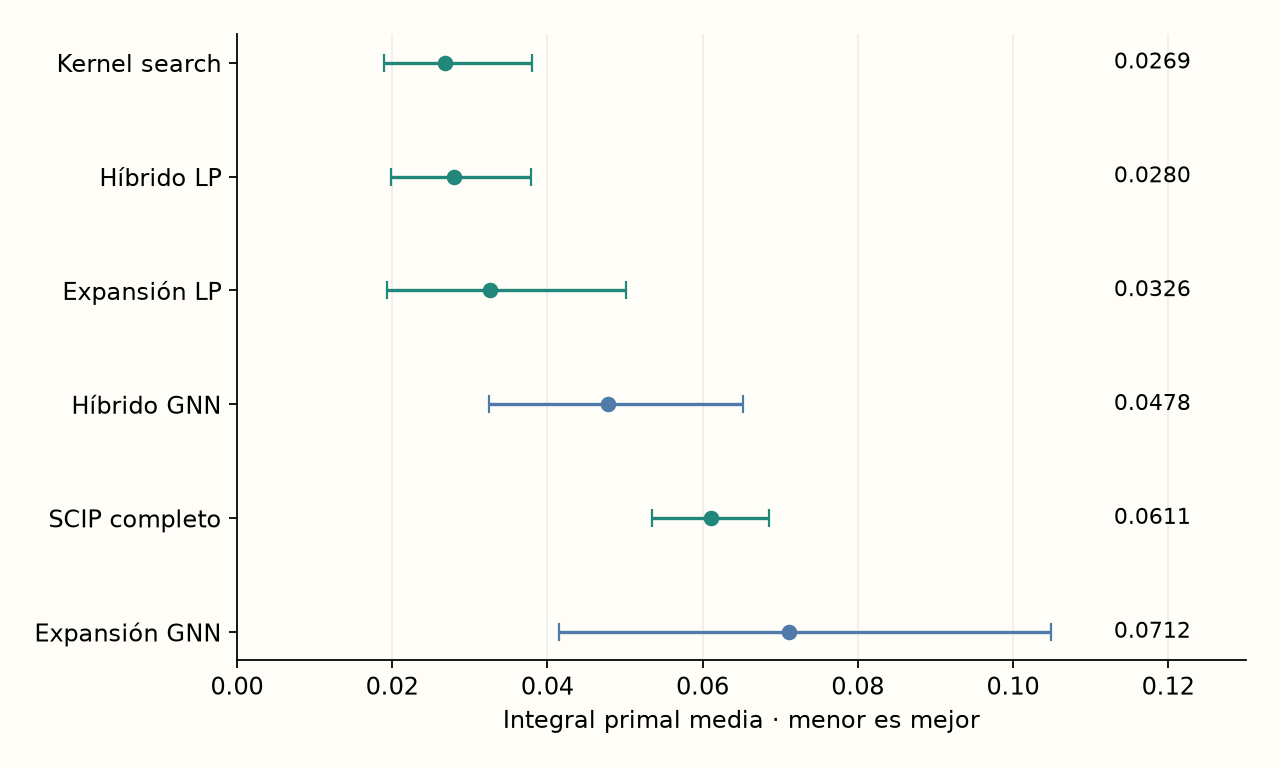
Sin embargo, no confirmé que la GNN terminara con peor coste: esa comparación secundaria quedó en p = 0,056 tras la corrección. Tampoco confirmé una mejora general por añadir CLNS a la expansión LP. Kernel search tuvo la menor integral numérica, 0,0269, pero no se demostró diferencia respecto a la expansión LP. Una tabla ordenada siempre produce un primer lugar; eso no convierte cada distancia entre filas en un hallazgo sólido.
La primera señal de este problema ya estaba en el filtrado. Una AUC cercana a 0,95 indicaba buena clasificación, pero conservar la solución de referencia en al menos el 80% de las instancias exigía mantener aproximadamente el 80% de los centros. Predecir bien una etiqueta no garantiza conservar la combinación completa necesaria para atender toda la demanda. La capacidad y la asignación única hacen que el conjunto importe más que cada puntuación aislada.
Cuando el tamaño cambia, la respuesta también cambia
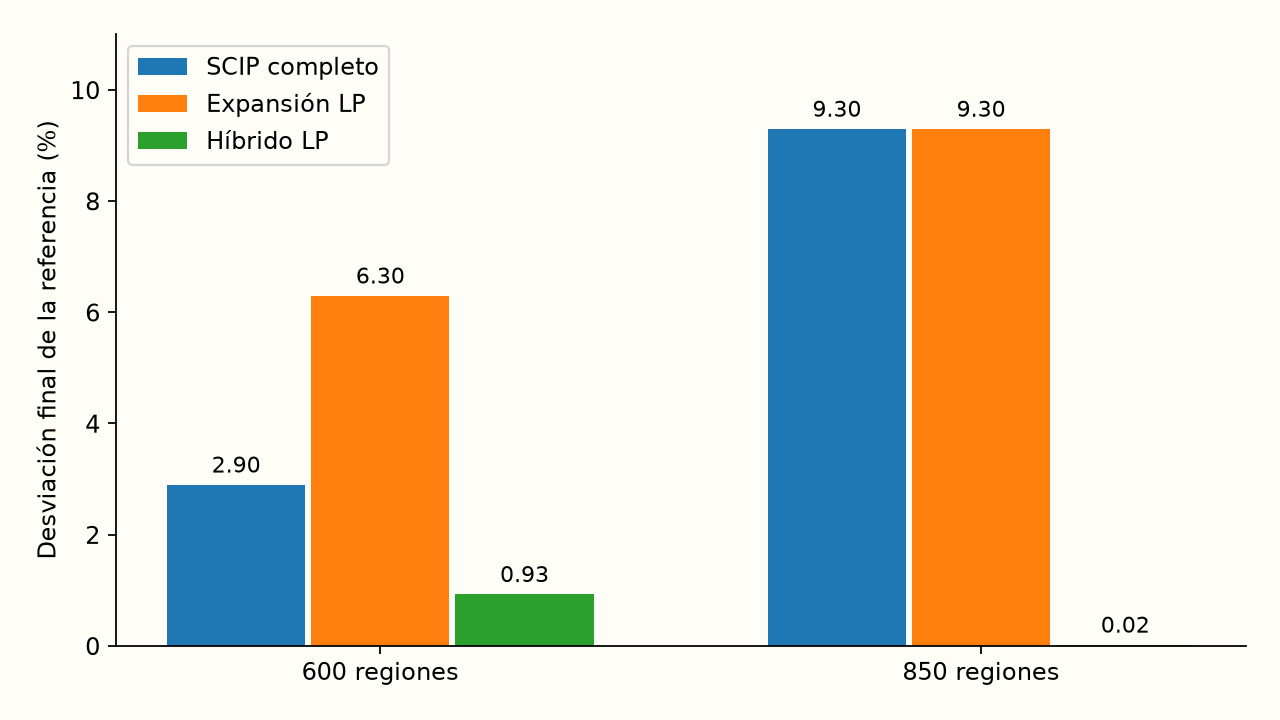
Los mayores casos Olist cuentan otra parte de la historia. En AWS, con 600 regiones, el híbrido LP terminó aproximadamente a 0,93% de la mejor solución conocida, frente a 2,9% del SCIP completo y 6,3% de la expansión LP. Con 850 regiones, los valores fueron 0,02%, 9,3% y 9,3%. Aquí la reoptimización coordinada aportó una mejora final importante. Son dos observaciones dentro de cuatro casos, no una garantía para cualquier red logística.
Holmberg permitió comprobar otra propiedad: como sus óptimos son conocidos, pude distinguir una buena solución de una prueba de optimalidad. La expansión LP certificó el óptimo antes de la última etapa en 66 de 71 instancias, con tiempo mediano de 0,4 segundos en esos casos, y alcanzó el óptimo publicado en 67, frente a 66 del solver completo. Son instancias pequeñas según estándares actuales; no trasladé esa velocidad a los casos grandes.
Investigar por qué una búsqueda se estanca
En los pilotos, entre el 54% y el 58% de los subproblemas seleccionados ya habían fallado en el mismo estado local. La memoria redujo esa repetición a aproximadamente 25–27%, pero no produjo una mejora concluyente de calidad. Después repetí 256 subproblemas con más tiempo: 252 terminaron con optimalidad probada y sin mejora; solo cuatro mejoraron con 30 segundos. Estos diagnósticos usaron validación y son exploratorios. Sugieren que esperar más no resolvía el principal obstáculo en esos casos.
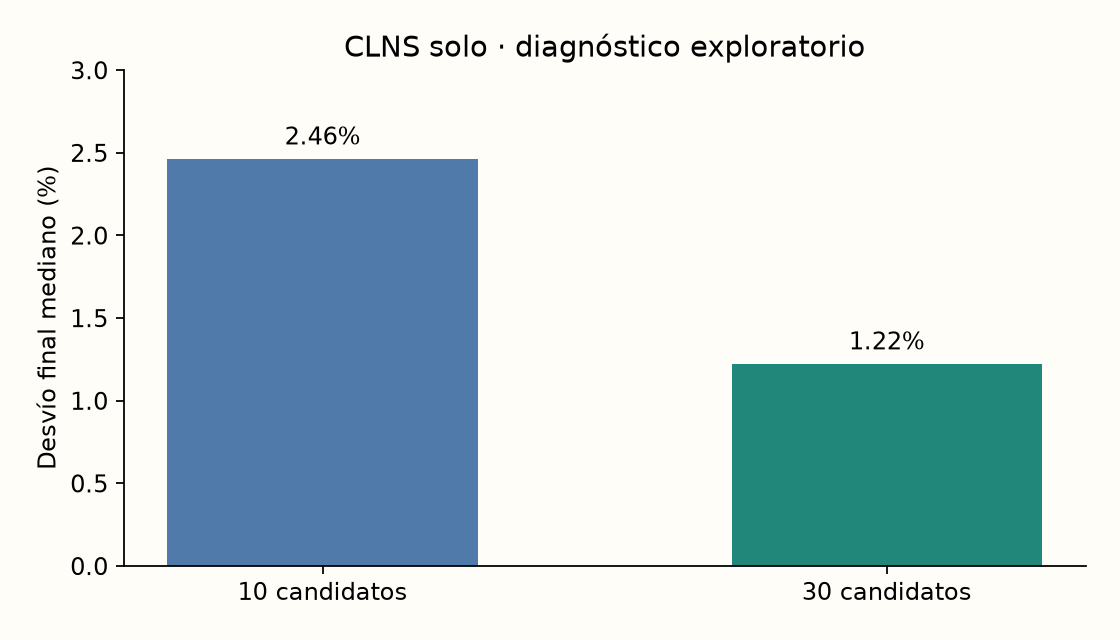
Ampliar de 10 a 30 los centros candidatos por cliente sí cambió el CLNS aislado: el desvío final mediano bajó de 2,46% a 1,22%, con mejora en 14 de 16 instancias y p corregido de 0,002. Se resolvieron menos subproblemas, pero más amplios. En el híbrido, que parte de una solución mejor, esa ampliación no mostró el mismo beneficio. Sustituir los grupos por agrupamientos aleatorios del mismo tamaño tampoco produjo diferencias significativas: la evidencia respalda la coordinación, no una superioridad demostrada del clustering.
Lo que significa no tener una bala de plata
La lección práctica es definir qué buscamos antes de elegir la herramienta. ¿Una solución útil pronto, el menor coste al terminar o una prueba de optimalidad? Después hay que identificar restricciones, comparar con una alternativa clásica que cumpla la misma función y cobrar todo el tiempo empleado. Si una GNN y una regla LP orientan exactamente la misma expansión, esa comparación permite separar el valor del mecanismo del valor del aprendizaje.
El apéndice también contiene un resultado favorable al aprendizaje: una MPNN estabilizada generalizó mejor en escala que Mettu–Plaxton para localización sin capacidad, antes de añadir búsqueda local. Otras reconstrucciones, como filtros de intercambios y un modelo neural dentro de un MIP de rutas, no superaron claramente sus controles clásicos. Son problemas y presupuestos distintos; no los sumé al test principal ni los traté como reproducciones exactas de los artículos originales.
Mi estudio no prueba una ley universal sobre optimización. Sus límites incluyen un único checkpoint evaluado, entrenamiento en un tamaño y dos familias espaciales, predominio de datos sintéticos y referencias heurísticas fuera de Holmberg. Las dos rondas repiten las mismas instancias: replican la medición, no una nueva muestra. Tampoco permiten afirmar que AWS sea cierto porcentaje más rápida, porque cambian hardware, entorno y referencias. Dentro de esos límites, el hallazgo es útil: conocer la estructura del problema y medir la contribución de cada componente fue más importante que añadir una red por su nombre.
Fuentes y continuidad
Base editorial: el manuscrito “Learning versus classical guidance in search-space reduction for single-source capacitated facility location”, tablas 10–11 y secciones 5.3, 6.8 y 6.9. Los gráficos utilizan los resultados guardados de la segunda ronda, salvo el ejemplo de la integral, identificado como ilustrativo. No se ejecutaron nuevos experimentos para preparar esta publicación.