Por qué cambia el resultado: capacidad, datos y límites de una GNN
Una lectura matemática de mis experimentos: cómo la distribución de la demanda, los límites LP y el alcance de la búsqueda favorecen o dificultan cada método.
En este artículo
Cuando utilicé una red neuronal en grafos para ayudar a elegir centros de distribución, la expectativa parecía razonable: si aprendía a reconocer buenas opciones en los ejemplos de entrenamiento, el optimizador podría concentrar su esfuerzo en una parte menor del problema. La red sí aprendió a ordenar candidatos con una buena métrica de clasificación. Sin embargo, al ejecutar los experimentos, una guía basada en programación lineal, sin entrenamiento previo, condujo la búsqueda a mejores resultados a lo largo del tiempo. Esa diferencia entre reconocer candidatos prometedores y ayudar a tomar una decisión completa fue lo que empezó a interesarme.
En la publicación anterior presenté la preparación de los experimentos en AWS y los resultados del estudio. Aquí quiero examinar qué había detrás de aquella comparación. Para ello conviene empezar por una dificultad muy concreta: un centro puede parecer excelente por sí solo y, aun así, formar parte de una mala combinación. Puede estar cerca de muchos clientes, pero no tener espacio para todos; puede ser barato de abrir, pero obligar a recorrer mayores distancias; o puede competir por los mismos clientes con otro centro igualmente bien situado. La optimización ocurre en esas relaciones, y a partir de ellas podemos entender mejor el comportamiento de los algoritmos.
Qué cambia cuando la demanda se concentra
El problema que estudié consiste en elegir qué centros abrir y definir cuál atenderá a cada cliente. Hay un coste fijo de apertura y un coste de atención, cuya suma debe ser lo menor posible. Ese ahorro, sin embargo, debe respetar dos condiciones: cada cliente será atendido por un único centro y ninguno podrá recibir una demanda superior a su capacidad. La primera condición impide dividir libremente un pedido entre varios lugares; la segunda hace que la elección de un cliente altere las opciones disponibles para los demás. Por eso, resolver cada atención de forma aislada no basta para organizar toda la red.
Para visualizar esa dependencia, construí tres ejemplos pequeños en los que podemos comprobar la mejor solución enumerando todas las asignaciones posibles. En todos hay tres centros, cada uno con capacidad para seis unidades, y seis clientes que demandan dos unidades cada uno. La capacidad disponible es, por tanto, 18 y la demanda total es 12. También mantuve el coste de apertura en dos unidades por centro y calculé la atención como diez veces la distancia euclídea por la demanda. Entre paneles solo cambié la posición de los clientes. Así podemos observar el efecto de la distribución espacial sin confundirlo con un cambio de capacidad o de regla de coste.

En los dos primeros escenarios, asignar cada cliente al centro más cercano produce cargas de cuatro unidades en cada lugar. En el tercero, la misma regla enviaría las doce unidades al centro B, que solo admite seis. Sigue sobrando capacidad total, pero parte de ella está en los lugares menos convenientes. Para respetar el límite, la solución debe enviar algunos clientes a otro centro y aceptar un mayor coste de transporte. La figura muestra precisamente esa redistribución: las líneas representan una asignación óptima, mientras que los números bajo los paneles muestran qué ocurriría si solo considerásemos la cercanía.
Este ejemplo da un significado más preciso a la expresión “distribución de los datos”. No se trata solo de la forma de los puntos en el mapa o de la demanda media, sino de cómo los clientes compiten por las alternativas disponibles. Incluso sin coordenadas geográficas, puede aparecer una situación equivalente si muchos clientes dependen de las mismas conexiones baratas. Cuando abrir un centro resulta caro respecto al transporte, esa competencia adquiere otra dimensión: concentrar la atención ahorra costes fijos, pero aumenta el riesgo de saturación y puede alargar los recorridos. La dificultad nace de combinar esas características, no de una regla según la cual todo agrupamiento sería difícil y toda distribución uniforme sería fácil.
Cómo una simplificación matemática ayuda a decidir
Para considerar esas relaciones conjuntamente utilizamos un modelo de optimización. Si llamamos yᵢ a la decisión de abrir el centro i y xᵢⱼ a la decisión de asignarle el cliente j, el coste total puede escribirse como z = Σᵢ fᵢyᵢ + Σᵢⱼ cᵢⱼxᵢⱼ. La primera suma reúne los costes fijos de apertura; la segunda, los costes de atención. En el modelo original, esas decisiones valen cero o uno. Las restricciones garantizan que cada cliente tenga exactamente una asignación y que la demanda recibida por un centro no supere su capacidad. Aquí cᵢⱼ ya representa el coste de atender toda la demanda de ese cliente mediante la conexión elegida.
Encontrar la mejor combinación entera puede ser laborioso. Una forma de obtener información antes de esa búsqueda es permitir temporalmente que x e y tomen valores entre cero y uno. Esta versión se llama relajación lineal, o LP. Puede dividir una atención y considerar aperturas fraccionarias, posibilidades que no forman parte de la operación real. Como admite más soluciones, su coste óptimo no puede superar al del problema original. Obtenemos así un límite inferior: una referencia matemática que ayuda a evaluar cuánto podríamos ahorrar todavía y qué centros parecen relevantes para la instancia que estamos resolviendo.
La distancia entre esa referencia y una solución realizable depende de la estructura del problema. Consideremos tres clientes con demanda de seis unidades y tres centros con capacidad de diez, cada uno con coste de apertura cien, sin coste de transporte. Dos centros suman capacidad veinte para demanda dieciocho, pero no pueden atender a los tres clientes: juntar dos exigiría doce unidades en un mismo lugar. Hay que abrir los tres centros y pagar trescientos. La LP, en cambio, puede distribuir un tercio de cada cliente a cada centro y abrir solo el 60% de cada uno. Cada centro recibe seis unidades, dispone de capacidad fraccionaria seis y el coste total queda en ciento ochenta.
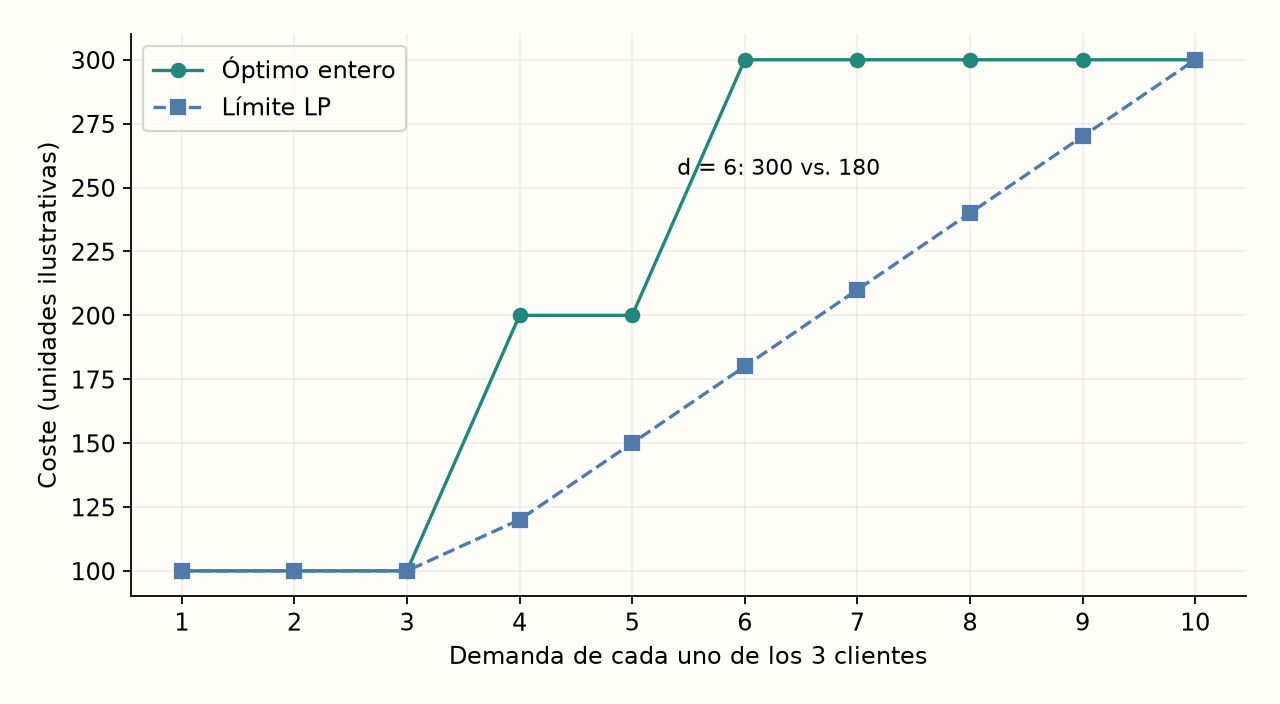
La diferencia del 40% respecto al óptimo entero no proviene de un error de cálculo. Aparece porque la relajación permitió dividir decisiones que en el problema original deben tomarse por entero. El salto del gráfico cuando la demanda pasa de cinco a seis muestra precisamente el momento en que dos clientes dejan de caber en el mismo centro. Demandas mayores o más desiguales pueden hacer especialmente importantes estos encajes. Aun así, sería precipitado concluir que una GNN necesariamente funcionaría mejor: en este ejemplo los tres centros son simétricos y todos son necesarios. La calidad del límite matemático y la utilidad de una ordenación de candidatos son cuestiones relacionadas, pero no equivalentes.
Qué aprendió la red y qué exigía la decisión
La GNN entró en el proyecto para producir esa ordenación por otro camino. Representé centros y clientes como nodos de un grafo, conectados por relaciones de atención. Cada nodo y cada conexión contienen información, como demanda, capacidad y costes relativos. Al intercambiar mensajes entre elementos conectados, la red combina esa información para asignar una puntuación a cada centro. En mi modelo esto ocurre en tres rondas. La propuesta era aprender, a partir de problemas ya resueltos, qué características solían identificar centros útiles y aprovechar ese aprendizaje para orientar problemas nuevos.
Para enseñar a la red, reuní soluciones cuyo coste estaba hasta un 1% por encima de la mejor encontrada en cada conjunto. La etiqueta de un centro era la frecuencia con que aparecía abierto en esas soluciones. La función de entrenamiento, una entropía cruzada binaria ponderada, penalizaba el desacuerdo entre la predicción y esa frecuencia. Esto tiene sentido para aprender recurrencia, pero introduce una diferencia importante: aparecer con frecuencia en buenas soluciones no equivale a ser indispensable para construir una buena combinación en un problema nuevo. La puntuación sirve para ordenar candidatos; no garantiza la viabilidad ni debe interpretarse como una probabilidad calibrada de éxito.
Esta diferencia ayuda a entender por qué una métrica de clasificación favorable puede coexistir con una reducción poco útil del espacio de búsqueda. La AUC, cercana a 0,95 en el piloto, evalúa la capacidad de ordenar pares de ejemplos de clases diferentes. El optimizador, en cambio, necesita recibir un conjunto de centros que funcione como red. Excluir una opción importante para atender una demanda difícil puede quitar valor a una selección aparentemente buena. En el piloto fue necesario conservar aproximadamente el 80% de los centros para preservar la mejor solución conocida en al menos el 80% de las instancias. Había aprendizaje en la ordenación, pero el margen para eliminar opciones con seguridad era mucho menor de lo que la AUC por sí sola podía sugerir.
La guía LP parte de una información distinta, calculada para el problema que se está resolviendo en ese momento. En la implementación, la puntuación considera el valor de apertura obtenido en la relajación y un pequeño ajuste por los costes reducidos. Estos provienen de la solución matemática e indican, bajo las condiciones apropiadas, una penalización mínima asociada a alejar una variable de su cota. La LP aporta así a la ordenación información sobre la combinación actual de capacidades, demandas y costes. Esto ofrece una explicación plausible de su utilidad en el estudio, aunque no permite atribuir toda la diferencia de rendimiento a una sola causa: el objetivo aprendido, la representación de los datos y el coste de inferencia también forman parte de la comparación.
Por qué orientar la búsqueda y demostrar una solución son tareas distintas
Los costes reducidos también permiten algo que una puntuación aprendida, por sí sola, no hace: justificar matemáticamente la exclusión de ciertas opciones. Supongamos que la relajación proporciona un límite inferior de cien y que ya existe una solución factible de coste ciento veinte. Para un centro cuya variable está en cero en la solución LP, un coste reducido válido de veinticinco significa que abrirlo elevaría el límite inferior a, como mínimo, ciento veinticinco. En ese caso, una solución que utilice ese centro no podrá mejorar la de ciento veinte que ya conocemos. La relación utilizada es L + rᵢ ≥ U, donde L es el límite inferior, rᵢ el coste reducido y U el coste de la solución factible.
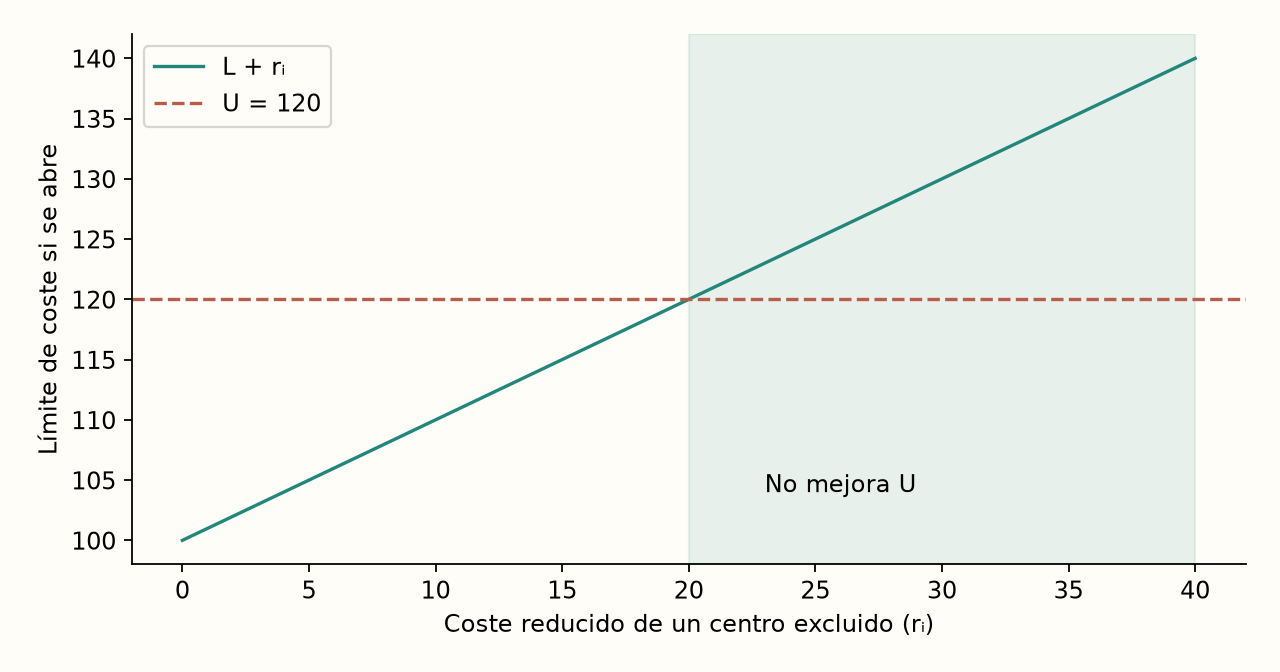
Cuando esa condición se cumple para todos los centros excluidos y el problema restringido se ha resuelto hasta la optimalidad, podemos certificar el resultado global, respetando las tolerancias numéricas. Este razonamiento depende de un límite dual válido y de las condiciones de la variable; no basta con aplicar la desigualdad a cualquier número producido por un algoritmo. En el experimento, tanto la expansión guiada por LP como la guiada por GNN calculan la relajación para aprovechar sus límites. La red añade una forma de ordenar candidatos, pero no elimina ese cálculo. Por ello, su guía debía ahorrar suficiente búsqueda para compensar también la preparación del grafo y la inferencia.
Ese balance se ve con más claridad al observar la evolución de las soluciones. Las dos versiones comienzan examinando el 20% de los centros, amplían el conjunto al 40% y al 60% y, si hace falta, llegan al problema completo, con reparaciones para hacer factibles las asignaciones. Una buena ordenación puede permitir que una combinación útil aparezca en las primeras etapas. Si quedaron fuera opciones importantes, el método debe invertir tiempo en ampliar el dominio. El resultado depende, por tanto, tanto de las elecciones como del momento en que pasan a estar disponibles para el optimizador.
Qué permiten explicar los resultados
Para observar esa evolución utilicé la integral primal, una medida que acumula la desviación respecto a una referencia durante la ejecución. Encontrar pronto una buena solución reduce la medida; alcanzarla solo cerca del final mantiene durante más tiempo una desviación mayor. En las 64 instancias sintéticas ejecutadas en AWS, la media fue 0,0326 para la expansión LP y 0,0712 para la expansión GNN. La diferencia favoreció a LP y siguió siendo significativa tras la corrección estadística de Holm, con p = 0,00479. La comparación de la desviación al agotar el presupuesto tuvo p = 0,0557 y no superó el criterio de significación del 5%. La evidencia más clara está, por tanto, en la calidad de la trayectoria temporal, y no en una superioridad final confirmada con el mismo criterio.
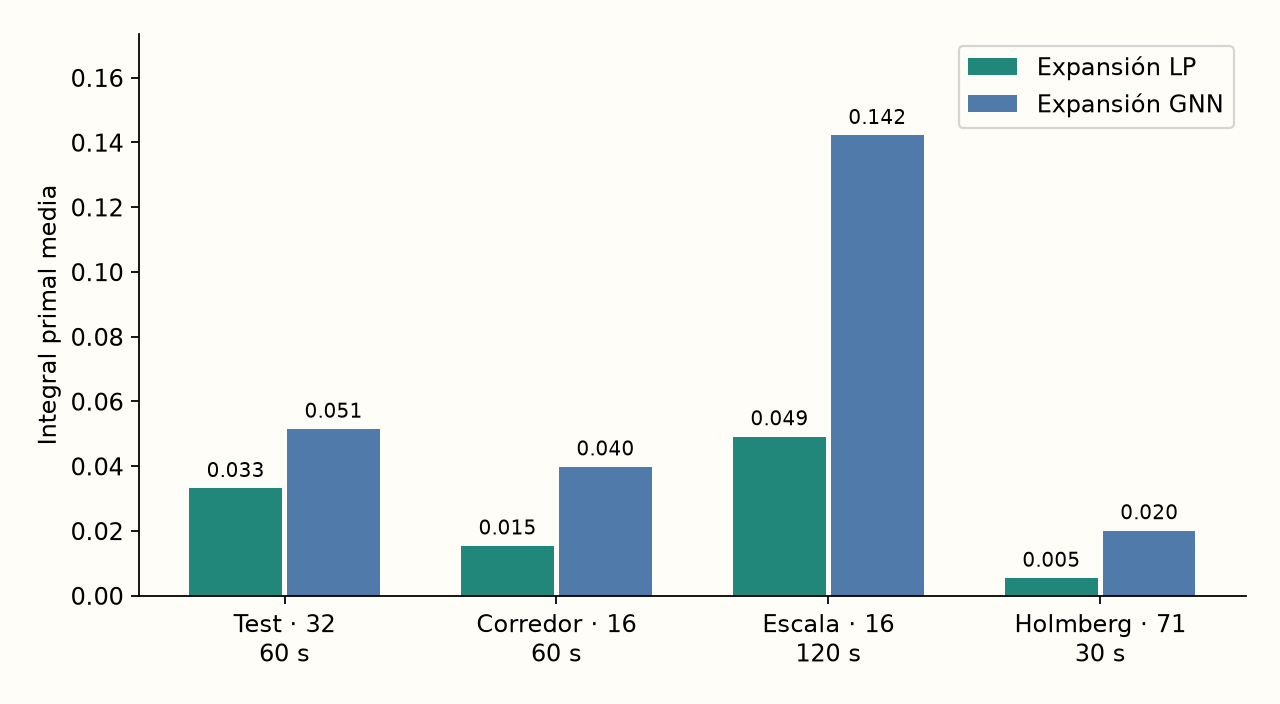
Separar los resultados por familia permite ver dónde aumenta la distancia entre métodos, pero no explica por sí solo sus causas. La red se entrenó con 160 instancias de 30 centros y 150 clientes, en geometrías uniformes y agrupadas, y solo uno de los checkpoints entrenados entró en el test de optimización. Al cambiar el tamaño del problema, organizar clientes en corredores o introducir costes no euclídeos, cambiamos relaciones encontradas durante el entrenamiento. Es plausible que ese cambio redujera la utilidad de la puntuación, pero el estudio no aisló su efecto del objetivo de entrenamiento o del coste computacional adicional. Los gráficos muestran el rendimiento observado; atribuir una parte concreta de la diferencia a cada mecanismo requeriría comparaciones adicionales.
También hay situaciones en las que queda poco margen para que una guía más compleja aporte beneficios. En Holmberg, la expansión LP certificó 66 de los 71 casos antes de llegar a la etapa con todos los centros. Cuando la información clásica ya permite resolver rápidamente el problema, el aprendizaje debe ofrecer un ahorro muy considerable para compensar su coste adicional. En otros escenarios, una guía clásica puede perder fuerza si muchos centros reciben valoraciones similares o si casi todos deben reincorporarse al problema. Entonces la reducción simplifica menos la búsqueda y el tiempo empleado en construir etapas puede consumir parte de la ventaja buscada.
Cuando el obstáculo está en los movimientos permitidos
Hasta aquí hemos visto cómo seleccionar centros puede ayudar a construir una solución. Una vez que existe una solución factible, aparece otra posibilidad: mantener parte de las decisiones y reorganizar solo un grupo de clientes. Ese es el principio del CLNS que implementé. El método libera algunas asignaciones, descuenta de la capacidad la atención de los clientes que permanecen fijos y resuelve un problema menor. Su beneficio es concentrar el esfuerzo en un cambio manejable. Su limitación es que el mejor resultado de ese problema menor puede seguir condicionado por las decisiones que no se liberaron.
Un ejemplo sencillo hace visible esa limitación. Imaginemos dos centros con capacidad para una unidad y dos clientes que demandan una unidad cada uno. En la solución inicial, A atiende al cliente 1 y B al cliente 2, con coste diez por atención. Si los clientes intercambiaran sus centros, ambos costes serían cero. Liberar solo un cliente no permite el cambio porque el destino sigue ocupado por el otro. Al liberar ambos, el intercambio se vuelve factible y el coste baja de veinte a cero. El tiempo disponible no era el problema: faltaba permitir que las dos decisiones cambiaran de manera coordinada.
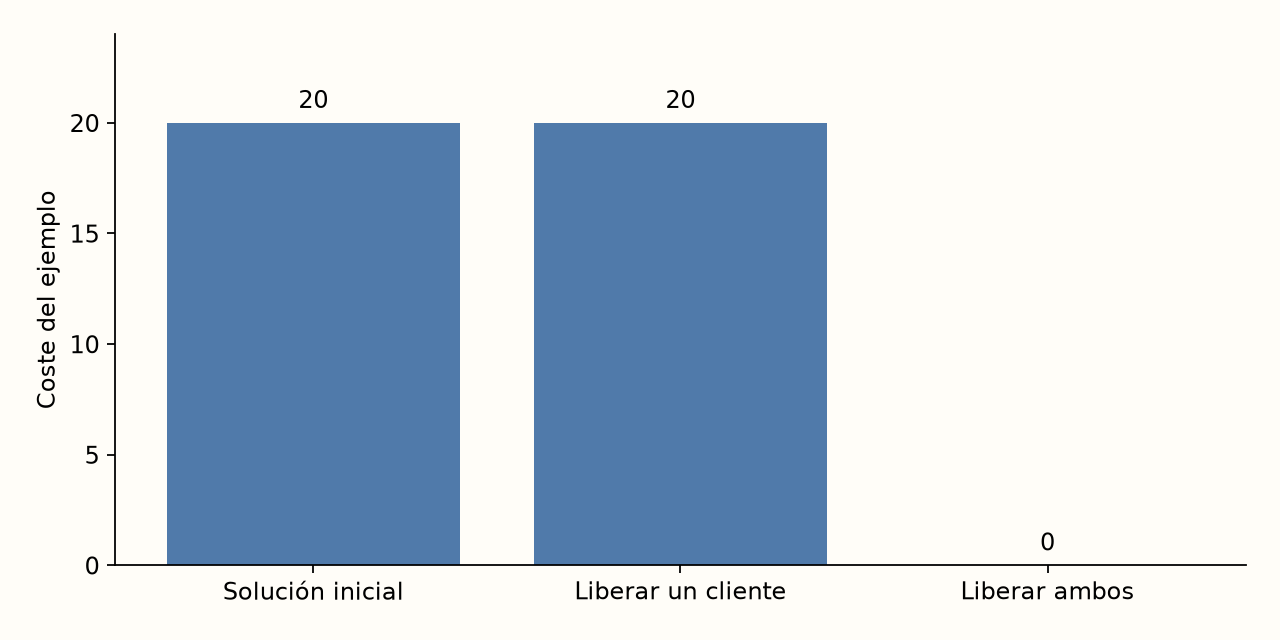
En los diagnósticos del estudio encontré evidencia compatible con esa limitación de alcance. Al reejecutar 256 subproblemas con más tiempo, 252 terminaron con optimalidad demostrada y sin mejora. Dentro de aquellas decisiones permitidas, esperar más no revelaba una solución mejor. Cuando amplié de diez a treinta los centros candidatos por cliente, la desviación final mediana del CLNS aislado bajó del 2,46% al 1,22%, mejorando en 14 de las 16 instancias de validación. El híbrido no obtuvo el mismo beneficio. Como parte de una solución mejor, las oportunidades restantes son distintas, y ampliar una vecindad también incrementa el trabajo necesario para explorarla.
Elegir el método a partir de la dificultad del problema
Estas observaciones me llevaron a pensar la elección del algoritmo como una decisión sobre qué dificultad conviene abordar primero. Si el modelo completo, resuelto por SCIP, ya encuentra buenas soluciones y demuestra su calidad rápidamente, crear etapas adicionales puede aportar poco. Si la LP identifica un conjunto pequeño de centros útiles, la expansión puede aprovecharlo para reducir el trabajo inicial. Kernel search explora una idea cercana: mantiene un núcleo de candidatos y añade grupos ordenados por costes reducidos. Obtuvo la menor integral media en el test sintético, pero su comparación con la expansión LP no estableció superioridad estadística. La media sirve, por tanto, como pista para investigar, no como justificación suficiente para elegir un ganador definitivo.
Cuando la dificultad está en reorganizar una solución existente, CLNS y los híbridos resultan interesantes, siempre que los cambios necesarios quepan en los grupos liberados. Esto ayuda a interpretar los resultados favorables al híbrido LP en los casos mayores de Olist, aunque cuatro casos no bastan para generalizar. Una GNN tiene una oportunidad plausible cuando muchos problemas comparten una estructura que el entrenamiento puede aprender y cuando la puntuación aprendida está alineada con la decisión que realmente ahorra búsqueda. Si cambian la proporción entre demanda y capacidad, la escala o la relación entre costes fijos y transporte, esa ventaja debe reevaluarse. Normalizar atributos ayuda a representar los datos, pero no garantiza que esos cambios preserven lo aprendido.
Mi estudio no identificó una distribución capacitada en la que esta GNN ganara de forma concluyente. Para saber si la concentración espacial, el tamaño de las demandas o el cambio de escala explican una parte concreta de los resultados, habría que variar una de esas características manteniendo comparables las demás. Conservar la red fija permitiría evaluar su robustez; volver a entrenarla respondería a otra pregunta: cuánto puede adaptarse. Esta distinción evita convertir una interpretación convincente en una conclusión que los experimentos todavía no respaldan.
Lo que la investigación ya permite afirmar es que las características del problema ayudan a organizar la comparación. La capacidad determina qué combinaciones son posibles; la distribución de clientes y costes determina cuáles resultan atractivas; y el mecanismo de búsqueda determina cuáles se examinarán en el tiempo disponible. Una guía aprendida debe ser útil dentro de esa secuencia, igual que una regla clásica debe justificar el esfuerzo que consume. Entender por qué funciona un método empieza por seguir esas decisiones desde los datos hasta la solución. Ese recorrido hizo que los resultados fueran más informativos para mí que una simple clasificación de algoritmos de mejor a peor.
Datos y referencias para seguir el análisis
Esta lectura se apoya en mi manuscrito “Learning versus classical guidance in search-space reduction for single-source capacitated facility location”, en los resultados guardados de AWS y en el código del proyecto. El gráfico por familias utiliza mediciones del test; los demás son ejemplos didácticos, identificados en sus leyendas, que permiten visualizar los mecanismos discutidos. Las pequeñas asignaciones se comprobaron por enumeración, y el ejemplo de la relajación también se verificó con un solver LP. Estos ejemplos añaden una explicación matemática al análisis, pero no constituyen nuevas pruebas de rendimiento de la GNN.
Para situar la comparación en un contexto más amplio, incluyo también trabajos que emplean GNN en otras tareas de optimización. Gasse y colaboradores investigan decisiones de ramificación en un grafo de variables y restricciones, mientras que Qian y colaboradores estudian localización uniforme sin capacidad. Como sus decisiones, hipótesis y formulaciones difieren de las mías, los resultados deben interpretarse dentro de esos contextos. Ayudan a comprender por qué una comparación desfavorable en un experimento no cierra la discusión sobre aprendizaje y optimización.
Leer el estudio y la preparación en AWS
Datos de los ejemplos exactos (JSON)
Resultados observados por familia (JSON)
Gasse et al.: aprendizaje para ramificación