De los pedidos a la red logística: un proyecto de optimización y aprendizaje automático
Qué construí, cómo se conectan los algoritmos y qué demuestran los experimentos de localización de centros con capacidad limitada.

Serie: de los datos a la decisión logística
- De los pedidos a la red logística: un proyecto de optimización y aprendizaje automático
- MILP: convertir una decisión logística en un modelo verificable
- Relajación lineal: cuánto puede mejorar una solución
- Voraz y búsqueda local: construir rápido y mejorar con criterio
- LNS: reorganizar parte de la red para escapar del óptimo local
- Predecir demanda: de una referencia poblacional a Poisson y boosting
- Previsión poblacional: tendencias, amortiguación y prueba temporal
- K-means: descubrir perfiles municipales sin inventar categorías naturales
- Scoring de candidatos: aprender a filtrar sin perder buenas decisiones
- Escenarios y SAA: decidir antes de conocer la demanda
La pregunta antes del algoritmo
¿Dónde abrir centros de distribución y a qué centro asignar cada región? Acercarse al cliente reduce desplazamientos, pero abrir instalaciones cuesta dinero y cada una admite un volumen limitado. Mi proyecto convierte ese conflicto en un modelo que permite comparar decisiones con reglas explícitas. El objetivo de esta serie es enseñar a construir y cuestionar ese proceso, desde los datos hasta la lectura del resultado.
Una cadena con responsabilidades distintas
La ingeniería de datos conserva fuentes, normaliza municipios y registra procedencia. Los modelos de demanda estiman pedidos; la previsión poblacional plantea futuros; el agrupamiento describe perfiles territoriales. Después, la optimización elige instalaciones y asignaciones. El scoring reduce candidatos y el análisis de escenarios comprueba si una elección resiste cambios. Ninguna etapa reemplaza la siguiente: predecir dónde habrá demanda no decide por sí solo dónde conviene instalarse.
Tres escalas de evidencia
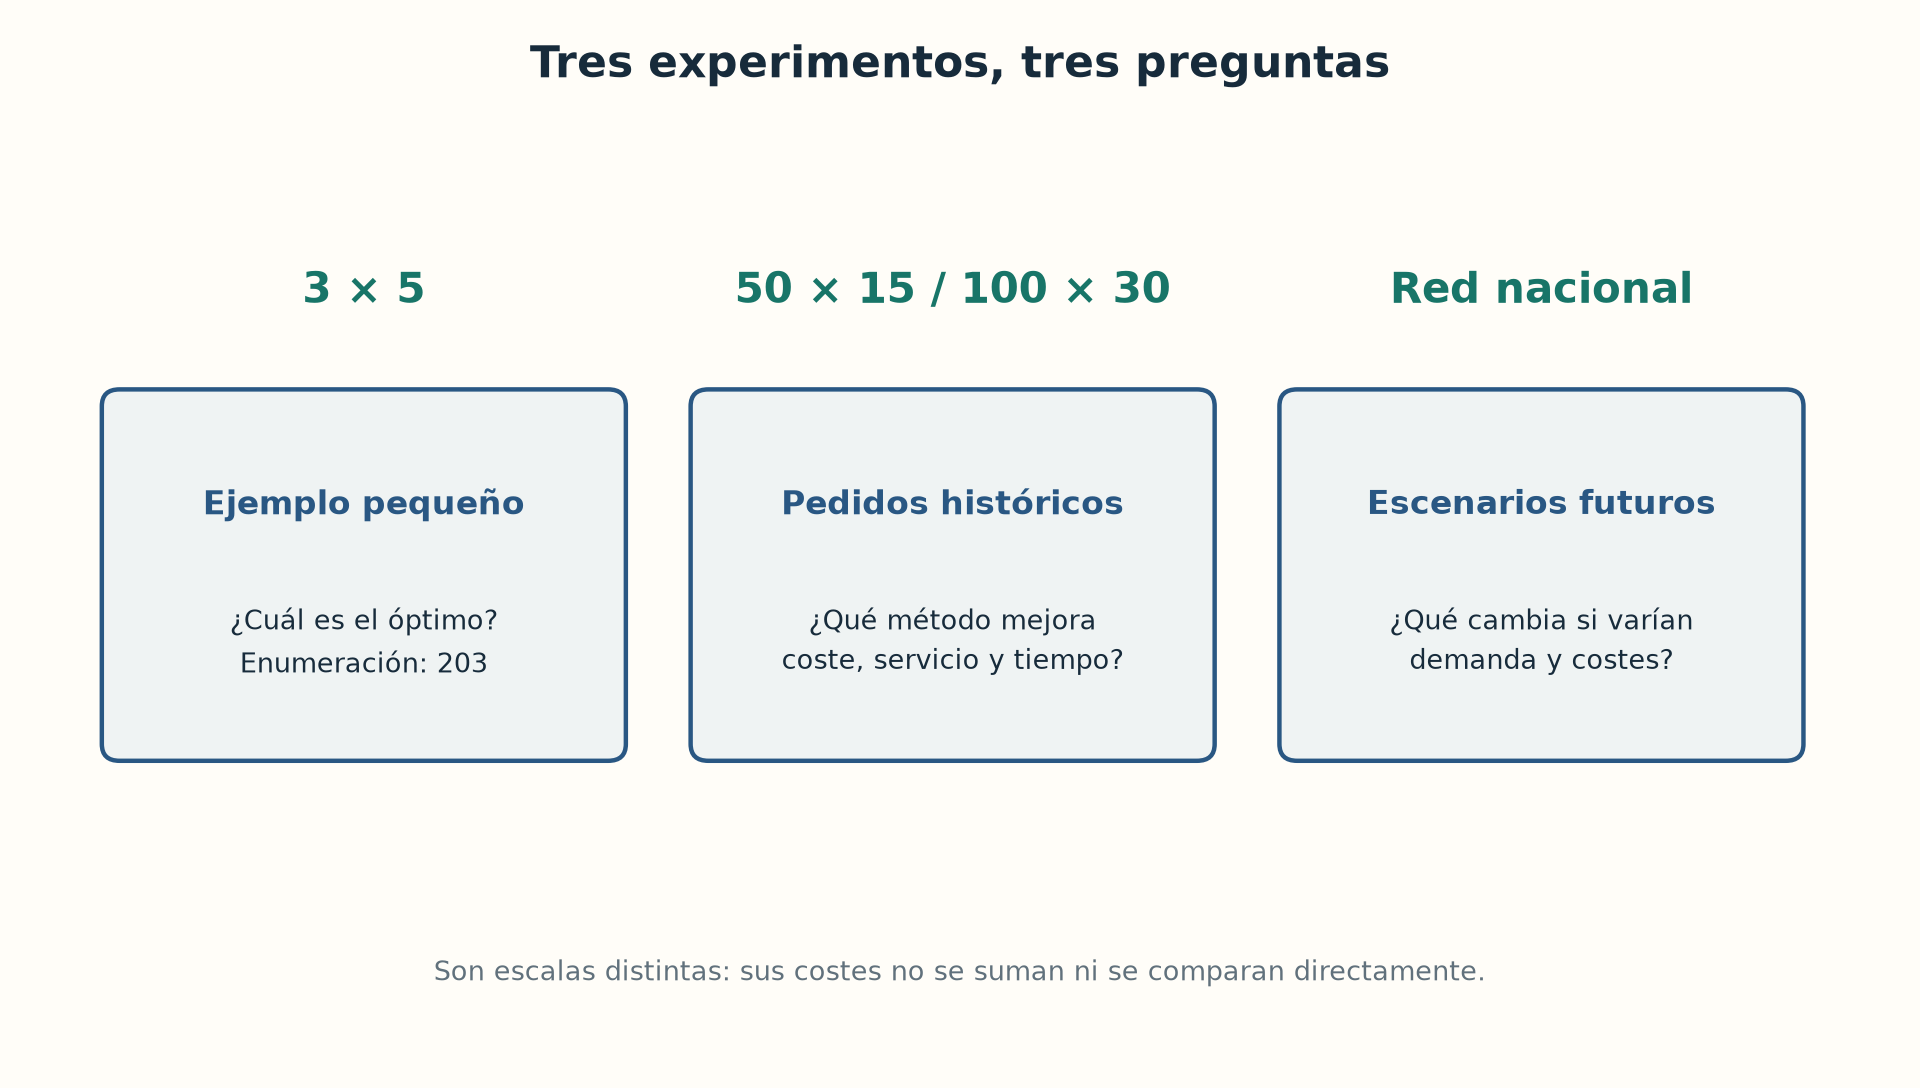
El ejemplo didáctico tiene tres centros y cinco regiones: permite enumerar todas las decisiones y demostrar el óptimo de 203 unidades monetarias. El estudio histórico utiliza recortes de pedidos Olist, con 50 regiones y 15 candidatos o 100 regiones y 30 candidatos. La red nacional añade población, propensión y escenarios de mercado. Son experimentos con horizontes y supuestos diferentes; sumar sus cifras o presentar sus costes como comparables sería incorrecto.
| Método | Coste 50×15 | Coste 100×30 |
|---|---|---|
| Voraz | 994102.40 | 1352149.43 |
| Búsqueda local | 920006.98 | 1339302.12 |
| MILP | 919471.41 | 1310952.57 |
| MILP con inicialización | 894531.26 | 1313883.90 |
| LNS, media de 3 semillas | 893976.56 | 1309923.03 |
El presupuesto nominal fue de diez segundos por ejecución; los métodos rápidos terminaron antes y hubo pequeños excesos de tiempo en LNS. Todos atendieron el 100% de la demanda seleccionada, que representa aproximadamente el 27,66% y el 43,01% de los pedidos del universo de referencia. El coste medio de LNS fue un 10,07% menor que el voraz en 50×15, calculado sobre el coste voraz. Es una mejora computacional bajo estas hipótesis, no un ahorro operativo medido.
Cómo estudiar y reproducir
Empiece por el modelo y ejecute el ejemplo pequeño antes de cambiar parámetros. Después compare heurísticas, límites y semillas; solo entonces añada predicción y escenarios. El repositorio requiere Python 3.12 o superior y declara Cavuca como dependencia editable en la carpeta hermana ../Cavuca: clonar únicamente este repositorio no garantiza instalar todo el entorno. Los ejemplos de la serie que importan alocacao_capacitada deben ejecutarse en ese entorno preparado. El sitio publicado contiene únicamente páginas estáticas.
La revisión local del 01/10/2026 ejecutó 91 pruebas con éxito. También identificó una métrica censal que no coincide con el APE convencional y una descripción del LNS más fuerte que la garantía real del código. Los artículos explican ambas limitaciones. Los resultados grandes aquí citados se contrastaron con los CSV existentes; no se volvieron a ejecutar todas las simulaciones nacionales. Antes de una decisión real faltan contratos de transporte, capacidad operativa, costes completos y niveles de servicio.
Fuentes y evidencias
Siguiente: MILP: convertir una decisión logística en un modelo verificable