Onde Maricá precisa de atenção primeiro? (1/3): a pergunta e os dados
Primeira parte da série sobre o Índice de Condições Socioterritoriais (ICST) de Maricá (RJ). Por que a média municipal não ajuda a decidir onde investir, como transformar dez variáveis oficiais em um índice de 0 a 100 por setor censitário e o que fazer quando o dado não existe na forma que você queria.

Neste artigo
Se eu te disser que Maricá tinha 197.277 habitantes no Censo 2022 e que 35% dos domicílios recebiam água da rede geral como forma principal de abastecimento, o que você faria com essa informação?
Provavelmente nada. Ou melhor: concluiria que "falta água encanada em Maricá", o que é verdade, mas não diz onde. E onde é exatamente a pergunta que um gestor precisa responder quando tem orçamento para uma obra de rede, uma nova Unidade de Saúde da Família ou um mapeamento de risco de detalhe.
Maricá cresceu muito nas últimas décadas, e cresceu do jeito mais difícil de atender: loteamentos extensos e de baixa densidade espalhados entre as lagoas, a orla e as encostas da serra. Bairros consolidados e bem servidos convivem com áreas recentes onde a rede de esgoto, a rede de água e os equipamentos públicos ainda não chegaram. A média municipal esconde tudo isso.
Esta série conta como construí o Índice de Condições Socioterritoriais (ICST) de Maricá, um indicador de 0 a 100 calculado para cada setor censitário do Censo 2022, só com dados oficiais e tudo em Python. O trabalho nasceu como artigo da pós-graduação em Análise de Dados como Método de Apoio às Políticas Públicas da UFRRJ.
- Parte 1 (esta): a pergunta, as dimensões e os dados. E as decisões que tomei quando o dado não vinha pronto.
- Parte 2: os resultados. Mapas, bairros, distritos e o que os números mostram.
- Parte 3: as áreas prioritárias, o quanto dá para confiar nelas e o mistério dos 35% contra 78% de água.
Três perguntas, uma unidade de análise
O índice foi desenhado para responder a três perguntas aplicadas:
- Como se distribuem, dentro do município, as condições socioeconômicas, de infraestrutura, socioambientais e de acesso a serviços?
- Quais áreas acumulam desvantagens e deveriam ser priorizadas?
- Quão sensível é essa priorização às escolhas metodológicas que eu fiz?
A terceira pergunta é a que mais gente esquece. Todo índice composto carrega escolhas (quais variáveis, quais pesos, como normalizar), e se o ranking muda inteiro quando você mexe um pouco nelas, ele não serve para decidir nada. Volto a isso na parte 3.
A unidade de análise é o setor censitário de 2022, a menor unidade com dados oficiais do Censo. Maricá tem 516 setores, dos quais 483 têm moradores. Os outros 33 são lagoas, áreas de proteção e áreas não ocupadas: aparecem nos mapas, mas não recebem índice. Para leitura gerencial, os resultados também foram agregados aos 49 bairros e 4 distritos definidos pela Prefeitura.
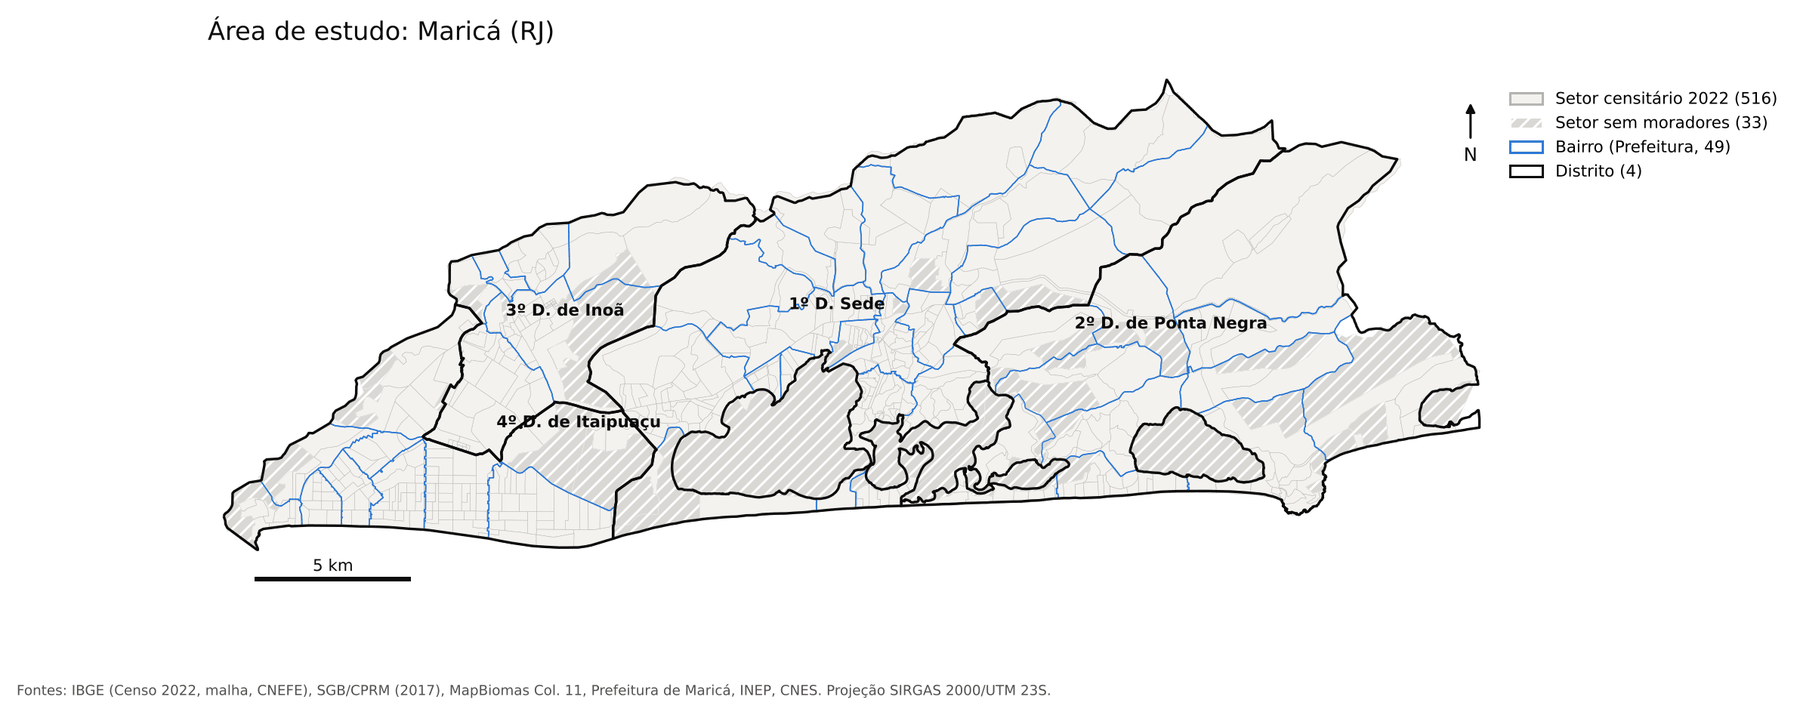
Um detalhe que parece pequeno e não é: na hora de agregar setores em bairros, não fiz média de percentuais. Somei numeradores e denominadores e recalculei. Média de percentuais dá o mesmo peso a um setor de 50 domicílios e a um de 800, e o bairro acaba parecendo melhor ou pior do que é.
Quatro dimensões, dez variáveis
O ICST tem quatro subíndices. Cada um responde a uma pergunta de política pública:
| Dimensão | Peso | Pergunta | Variáveis |
|---|---|---|---|
| S – Socioeconômica | 0,30 | Onde se concentram restrições de renda e de alfabetização? | S1 renda baixa, S2 alfabetização 15+ |
| I – Infraestrutura e saneamento | 0,30 | Como se distribuem água, esgoto e coleta de lixo? | I1 água, I2 esgoto, I3 lixo |
| A – Socioambiental | 0,25 | Que parte da ocupação está em área suscetível e onde se perde vegetação nativa? | A1 inundação, A2 movimento de massa, A3 perda de vegetação |
| P – Acesso a serviços | 0,15 | Que parte dos domicílios alcança a pé uma USF e uma escola pública? | P1 USF a 20 min, P2 escola a 20 min |
Os pesos foram fixados antes de olhar os resultados, como hipóteses de trabalho. Socioeconômica e infraestrutura ficaram com 0,30 cada por serem as dimensões mais tradicionais e mais ligadas às carências do domicílio; a de acesso ficou com 0,15 porque depende de dados de localização com mais incerteza. Fixar antes importa: se você escolhe os pesos depois de ver o mapa, é fácil (e tentador) ajustar até o resultado "fazer sentido".
Cada variável foi levada para a escala de 0 a 100 pelo método mínimo–máximo. Nas variáveis em que um valor alto é ruim (renda baixa, inundação, perda de vegetação), o sinal é invertido. No fim, em todas elas, 100 é a melhor situação observada no município e 0 é a pior. O ICST é a soma ponderada dos quatro subíndices.
De onde vieram os dados
Tudo foi baixado por script, com URL, data de acesso e hash SHA-256 registrados num catálogo de fontes, e os arquivos originais ficaram intactos. As principais fontes:
- IBGE, Censo 2022: agregados por setor censitário (alfabetização, água, esgoto, lixo, rendimento do responsável), malha de setores e o CNEFE, o cadastro de endereços, com 106.439 endereços de domicílios em Maricá.
- Serviço Geológico do Brasil (SGB/CPRM): carta de suscetibilidade a inundação e a movimentos de massa de Maricá (2017).
- MapBiomas Coleção 11: cobertura e uso da terra em 2022 e 2025, a 30 m.
- Prefeitura de Maricá: limites de bairros e distritos e as Unidades de Saúde da Família georreferenciadas.
- INEP: escolas e Censo Escolar 2024.
- CNES/DATASUS: estabelecimentos de saúde, para conferir as USF e incluir as dos municípios vizinhos.
- Overture Maps: rede viária para o cálculo de caminhada, porque a base viária municipal exige credencial.
- SNIS 2022 e SINISA 2024: só para confronto com o Censo no saneamento (spoiler da parte 3: deu trabalho).
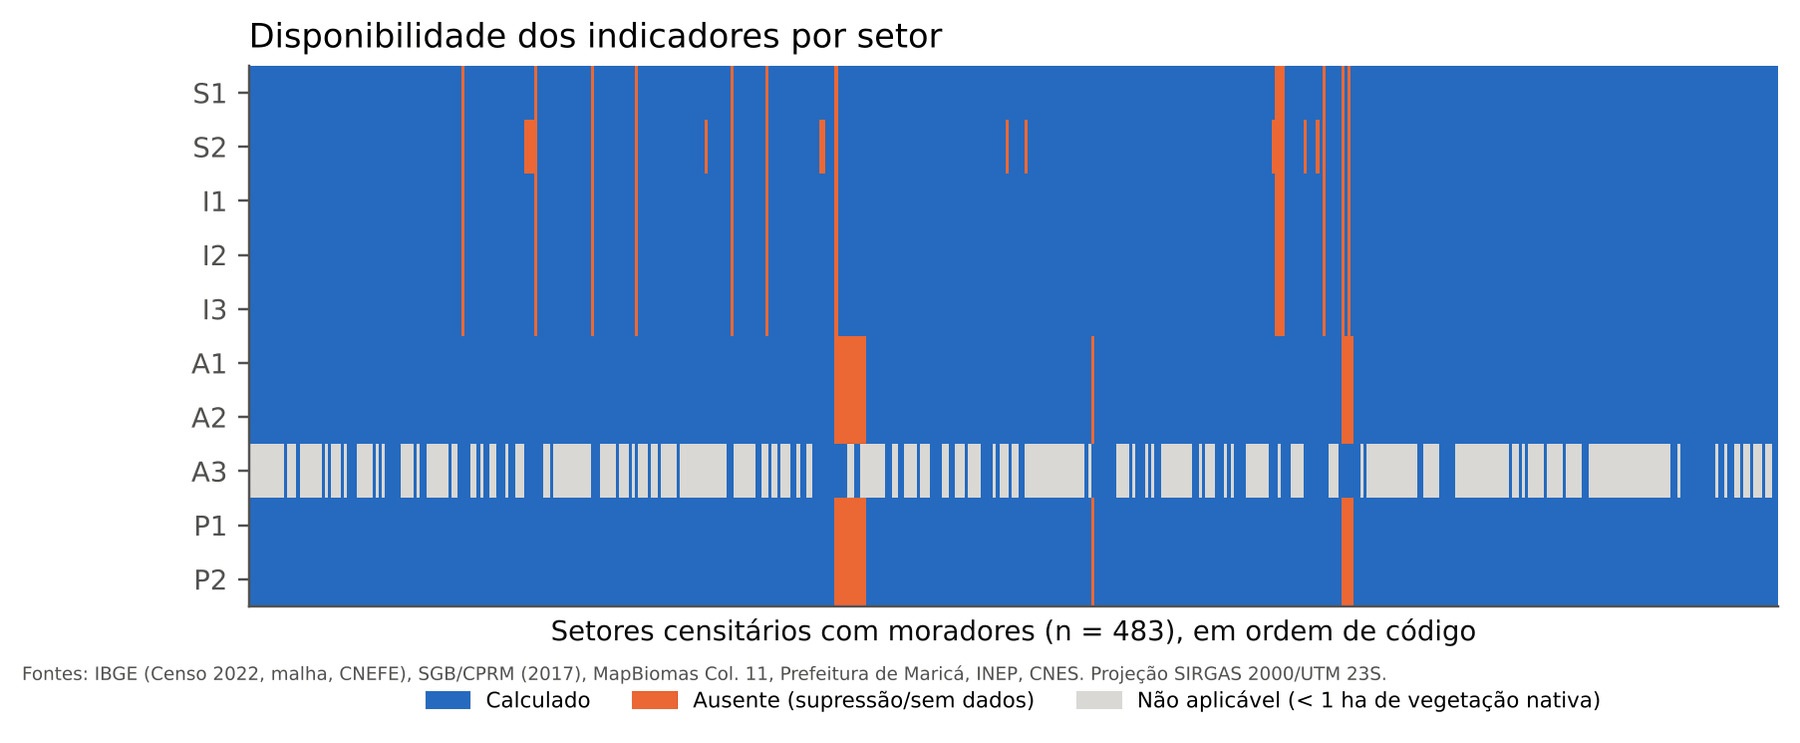
No fim, o ICST foi calculado para 447 dos 483 setores habitados, que reúnem 97,5% da população. Os setores que ficaram de fora são pequenos: somam 4.876 pessoas.
Quando o dado não vem do jeito que você queria
Esta é a parte que eu mais gostaria que você levasse para os seus projetos. A regra do trabalho era simples: não inventar dado. Ausente fica ausente, nunca vira zero nem média. Mas seguir essa regra exige decisões. Quatro delas:
1. Não existe faixa de renda por setor no Censo 2022
O indicador de renda que eu queria era "proporção de responsáveis com rendimento abaixo de 1 salário mínimo". O agregado por setor do Censo 2022 não traz faixas de rendimento: traz apenas a média, a variância e a mediana do rendimento dos responsáveis. A tabela por faixas só existe no nível do município, e os microdados mais finos são de acesso restrito.
A saída tentadora seria copiar o percentual municipal para todos os setores. Isso é fabricar dado. O que fiz foi estimar a proporção supondo que, dentro de cada setor, a renda segue uma distribuição lognormal (uma hipótese clássica para renda), com a média e a variância publicadas pelo IBGE. Depois validei de três formas: a mediana implícita do modelo tem correlação de 0,96 com a mediana publicada; agregado às 11 áreas de ponderação, o indicador ordena as áreas como a renda per capita da amostra; e o total municipal estimado (24,9% dos responsáveis abaixo de 1 SM) é da mesma ordem que a distribuição oficial do município.
Então o S1 é uma estimativa modelada, e eu escrevo isso em todo lugar onde ele aparece. Funciona bem para ordenar setores; não é uma contagem.
2. O IBGE esconde números pequenos (e isso não é zero)
Para proteger o sigilo, o IBGE suprime células com contagens pequenas: o valor aparece como "X". Tratar "X" como zero faria setores pequenos parecerem sem água ou sem esgoto.
Como as categorias de cada quesito somam exatamente o total de domicílios quando nada é suprimido, a diferença entre o total e o que foi publicado é a soma das células escondidas, e cada uma vale pelo menos 1. Com isso dá para calcular um intervalo exato para o valor suprimido e usar o centro dele. Os limites inferior e superior entraram na análise de sensibilidade e não mudaram o ranking.
3. Domicílio é endereço, não mancha urbana
Para saber que parte dos domicílios está em área de inundação ou a 20 minutos a pé de uma USF, preciso saber onde estão os domicílios. A opção comum é usar a classe "área urbanizada" do MapBiomas, mas ela não cobre bem loteamentos dispersos, que são justamente o padrão de Maricá. Usei os endereços do CNEFE: mesmo ano do Censo, precisão de endereço (97,6% com coordenada própria) e presente em todo setor com domicílios.
4. "Não se aplica" é diferente de "não sei"
A perda de vegetação nativa (A3) é uma razão: quanto da vegetação nativa de 2022 virou uso humano em 2025. Num setor urbano com menos de 1 hectare de vegetação nativa, essa razão não tem base. Marquei esses setores como não aplicáveis e recalculei a dimensão só com inundação e movimento de massa. Foi a única exceção, definida antes do cálculo. Em qualquer outro caso, faltou variável, o setor fica sem índice.
Como ficam as variáveis no mapa
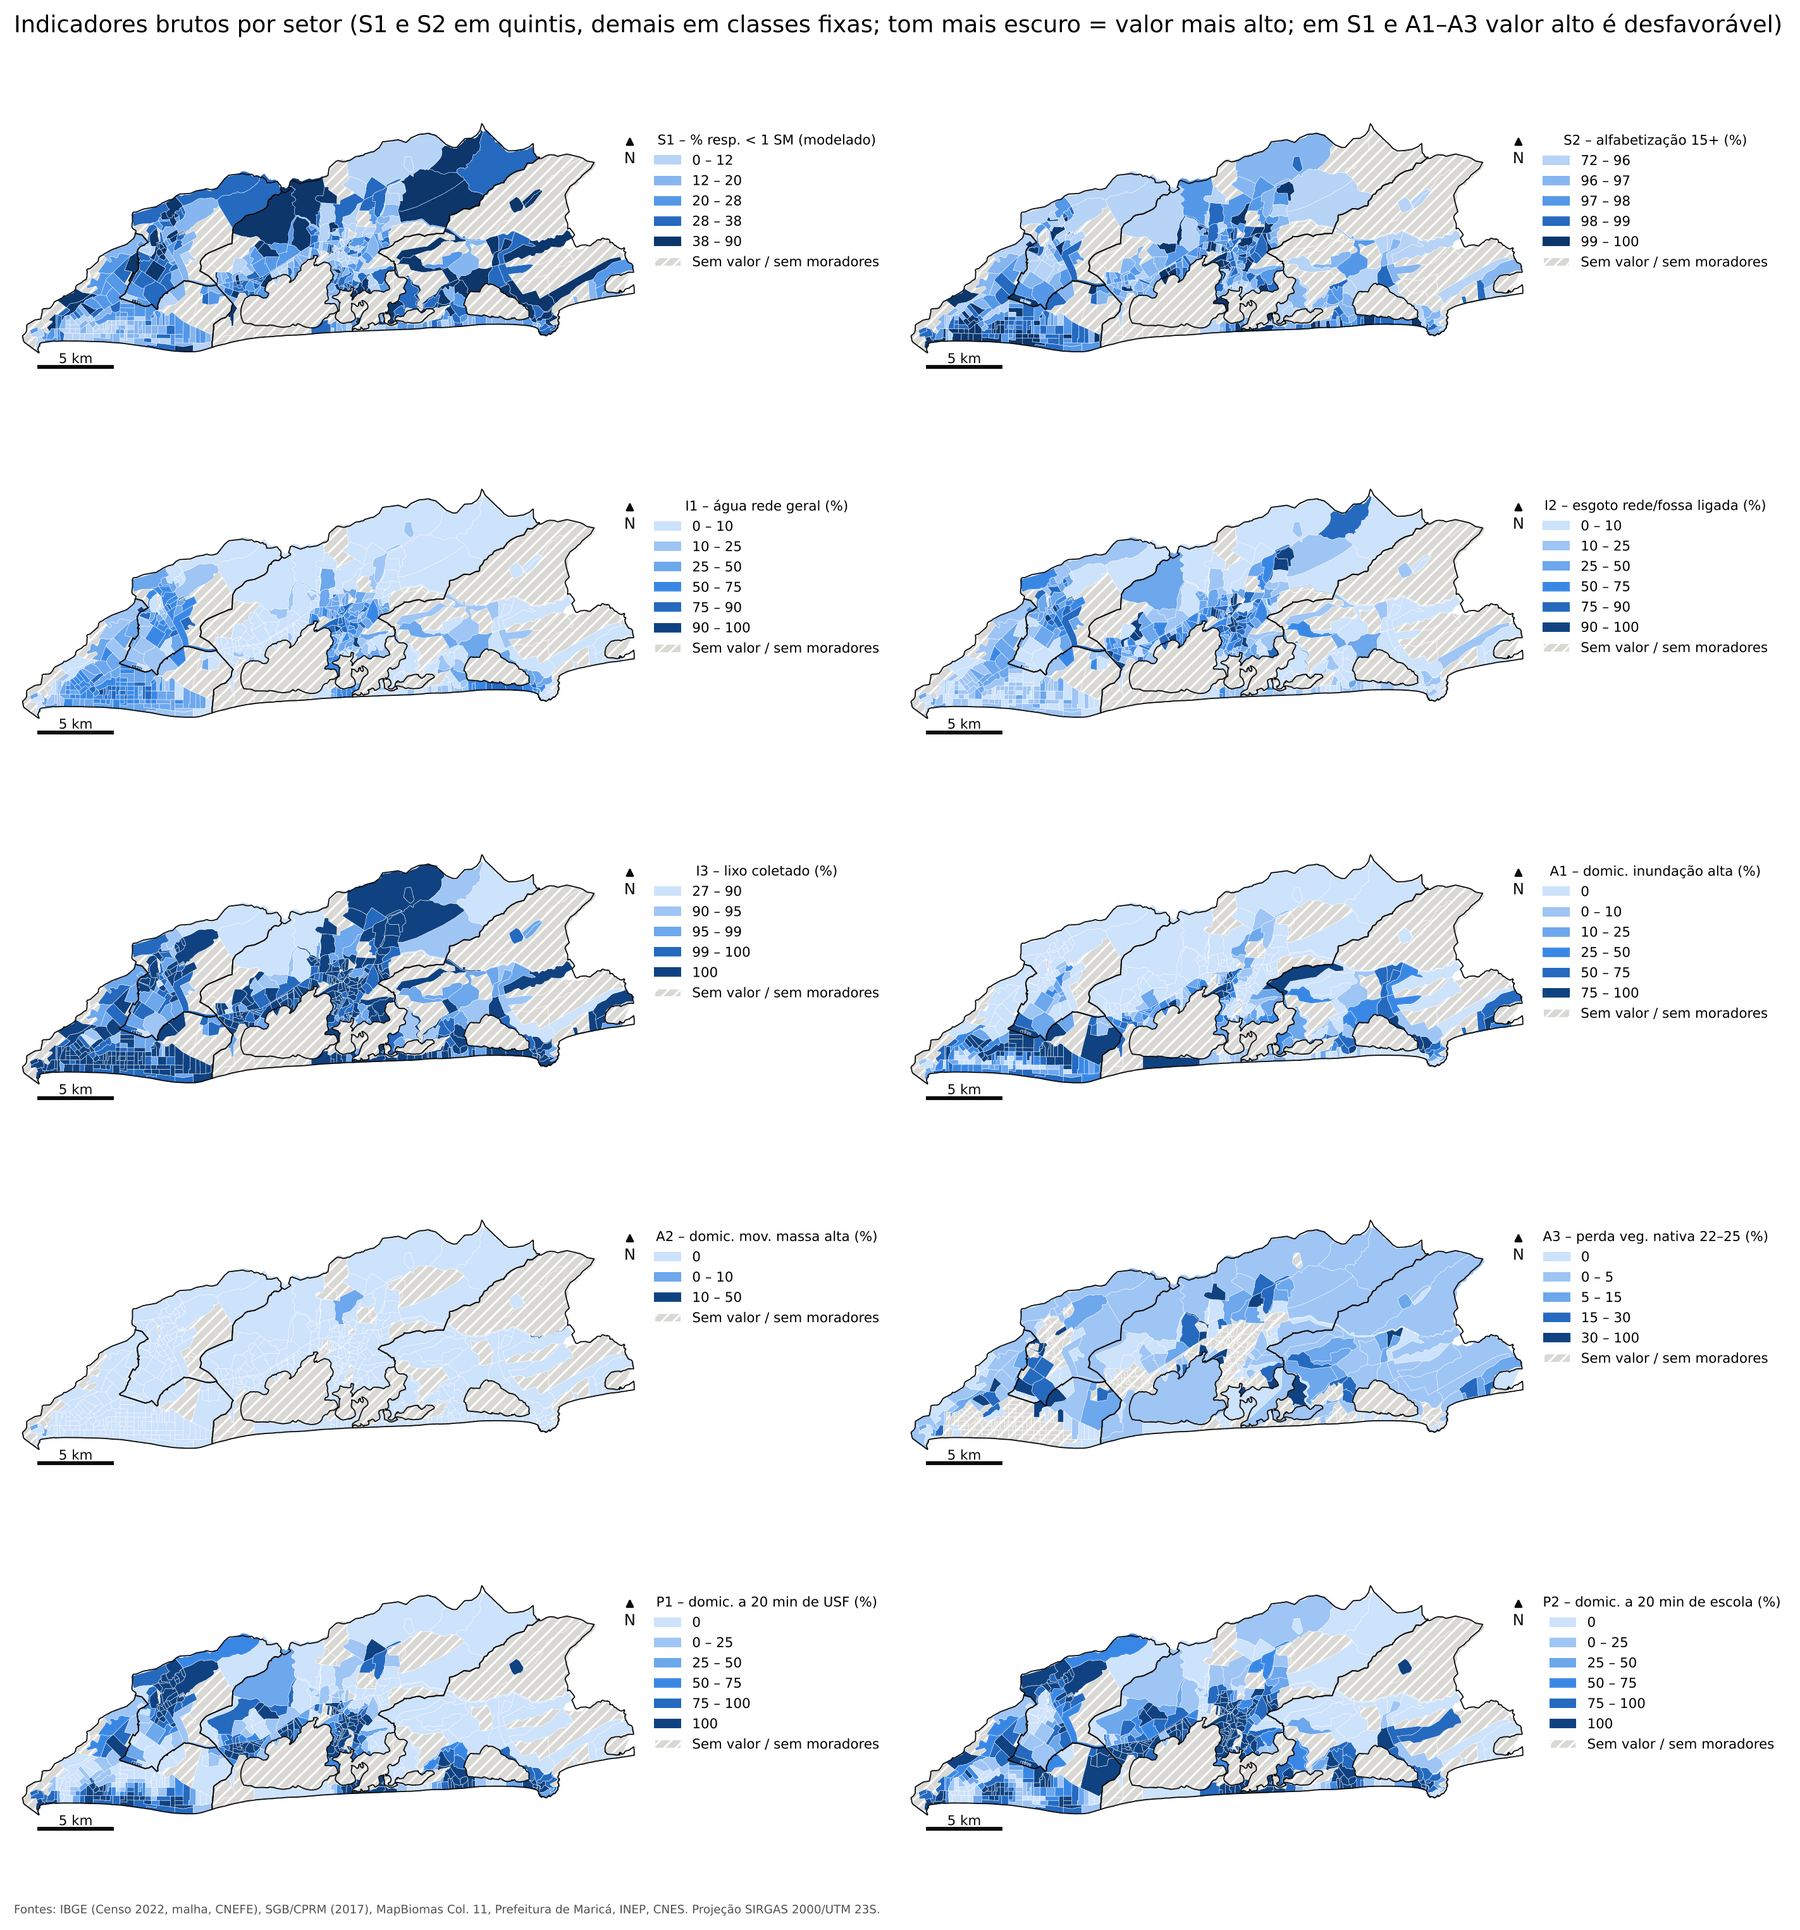
Antes de juntar tudo num número, vale olhar cada variável separadamente. Repare como água (I1) e esgoto (I2) variam de 0% a 100% entre setores, enquanto coleta de lixo (I3) e alfabetização (S2) são quase universais:
Alguns números do município inteiro para ancorar:
- Alfabetização de 15 anos ou mais: mediana de 97,9% entre setores.
- Coleta de lixo: 99,1% dos domicílios.
- Água da rede geral como forma principal: 35,2% dos domicílios.
- Esgoto ligado à rede: 34,7%.
- Domicílios em suscetibilidade alta a inundação: cerca de 24,6%.
- Domicílios a até 20 minutos a pé de uma USF: 56,9%; de uma escola pública com ensino fundamental, 65,1%.
Já dá para suspeitar de onde vem a desigualdade, não dá? Não é da escola básica nem do caminhão de lixo. É do cano.
No próximo post, junto as dez variáveis no índice e mostro o mapa de Maricá que sai dele: quais bairros e distritos estão melhor, quais estão pior e por que as desvantagens não aparecem espalhadas, e sim em manchas.