Localización capacitada y aprendizaje automático: modelos, experimentos y resultados
Un análisis experimental de dónde ayuda el aprendizaje automático a la optimización logística, con resultados, comparaciones clásicas y límites de la evidencia.

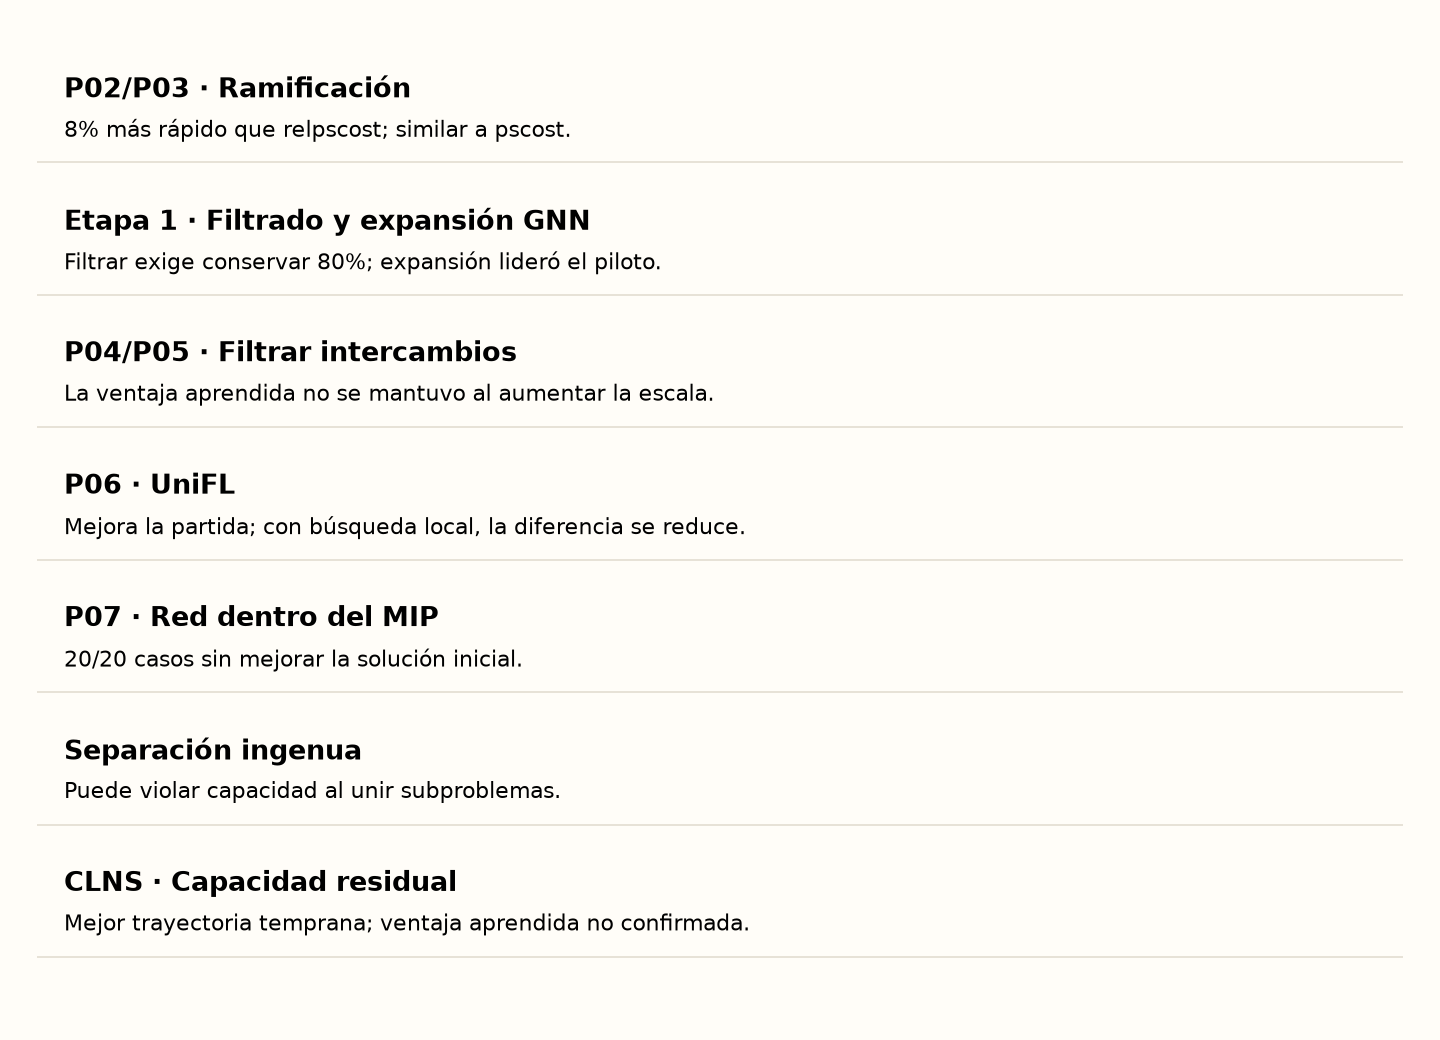
Abrir un centro de distribución parece una decisión local: elegir un lugar y atender a sus vecinos. Sin embargo, cada elección cambia las posibilidades del resto de la red. En este proyecto investigué si un modelo aprendido podía ayudar a decidir qué centros abrir y cómo asignarles la demanda, sin sacrificar calidad y contando todo el tiempo necesario para producir la solución.
Reconstruí seis líneas de la literatura, P02–P07, y las conecté con experimentos de filtrado de candidatos y búsqueda de grandes vecindarios. Utilicé SCIP 10, HiGHS, OR-Tools y PyTorch en CPU. La conclusión es acotada: en estos experimentos, orientar la búsqueda resultó más útil que sustituir sus decisiones por predicciones. Una buena puntuación predictiva, por sí sola, no garantizó una mejor solución logística.
El problema: una demanda, un centro, capacidad limitada
El modelo principal es SSCFLP: cada región debe ser atendida íntegramente por un único centro abierto. A diferencia del modelo con penalización por demanda no atendida presentado en la serie anterior, aquí el servicio es obligatorio. Se minimiza el coste fijo de abrir centros más el coste de atender las regiones, respetando la capacidad de cada instalación.
min Σᵢ fᵢ yᵢ + Σᵢⱼ cᵢⱼ xᵢⱼ
Σᵢ xᵢⱼ = 1
Σⱼ dⱼ xᵢⱼ ≤ Qᵢ yᵢ
xᵢⱼ ≤ yᵢ
xᵢⱼ, yᵢ ∈ {0, 1}
La variable y indica si se abre un centro; x, si atiende a una región. f es el coste fijo, d la demanda y Q la capacidad. c ya representa el coste de atender toda la demanda de la región: multiplicarlo otra vez por d contaría la demanda dos veces. Los costes se expresan en unidades monetarias; demanda y capacidad, en pedidos.
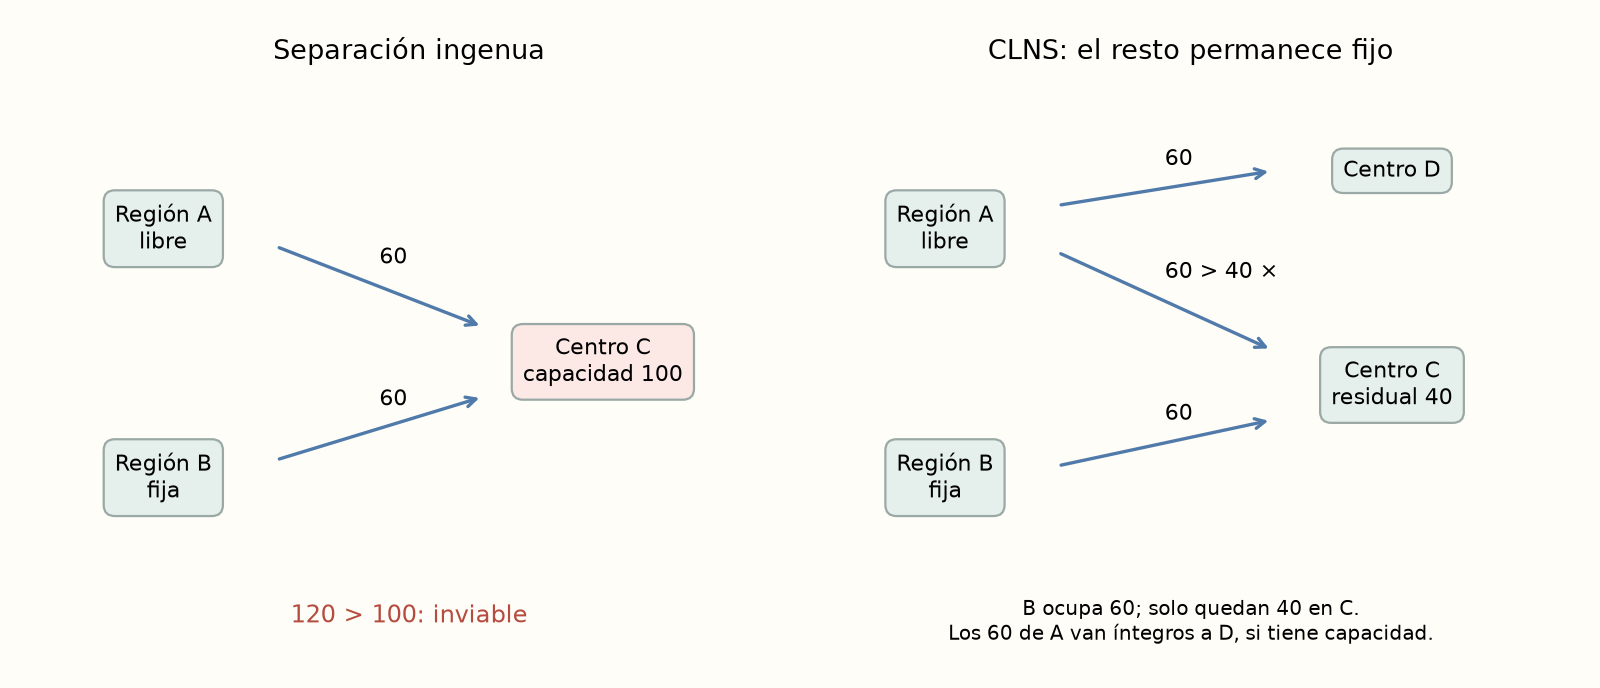
Esta dependencia explica por qué separar el mapa no separa automáticamente el problema. Es como reservar asientos de un mismo autobús desde dos ventanillas: ambas necesitan conocer las reservas de la otra. En instancias de 30 centros y 150 regiones, SCIP no siempre probó el óptimo en 60 segundos; se registraron gaps certificados de 1,8–3,6%. En una instancia de 50 × 200, el gap llegó al 15,6%.
Datos y separación de los experimentos
| Conjunto | Instancias | Uso y referencia |
|---|---|---|
| Entrenamiento | 160 · 30 × 150 | Uniformes y agrupadas; SCIP 60 s + LNS 30 s; gap medio 4,4%. |
| Validación | 32 · 30 × 150 | Semillas 1000+; selección de parámetros. |
| Test reservado | 32 · 30 × 150 | Semillas 2000+; preparado, no presentado aquí como test final completado. |
| Corredor no visto | 16 · 30 × 150 | Generalización espacial; SCIP 60 s + LNS 30 s. |
| Escala | 16 · 50 × 200 | SCIP 120 s + LNS 60 s. |
| Holmberg | 71 · 10–30 × 50–200 | Costes no euclídeos y óptimos publicados. |
| Olist | 4 · 30 × 150 → 150 × 850 | Pedidos entregados por CEP3; ANTT; SCIP 300 s + LNS 120 s. |
El generador sintético empleó demandas U(5,35), capacidades U(10,160) reescaladas, costes fijos proporcionales a la raíz de la capacidad y servicio 10 × distancia × demanda. Se probaron distribuciones uniformes y agrupadas con razones de capacidad 1,5 y 3. Las instancias incompatibles con asignación única se descartaron mediante empaquetado FFD y un MILP de factibilidad.
Olist aporta pedidos reales, pero no convierte todos los parámetros en observaciones: costes fijos y capacidades son supuestos del modelo. Los gaps de referencia fueron 0,04%, 0,7%, 3,3% y 4,2% para 150, 300, 600 y 850 regiones. Estas diferencias importan: superar una referencia heurística no equivale a probar optimalidad ni a demostrar ahorro implantado en una empresa.
Cómo se midió una mejora
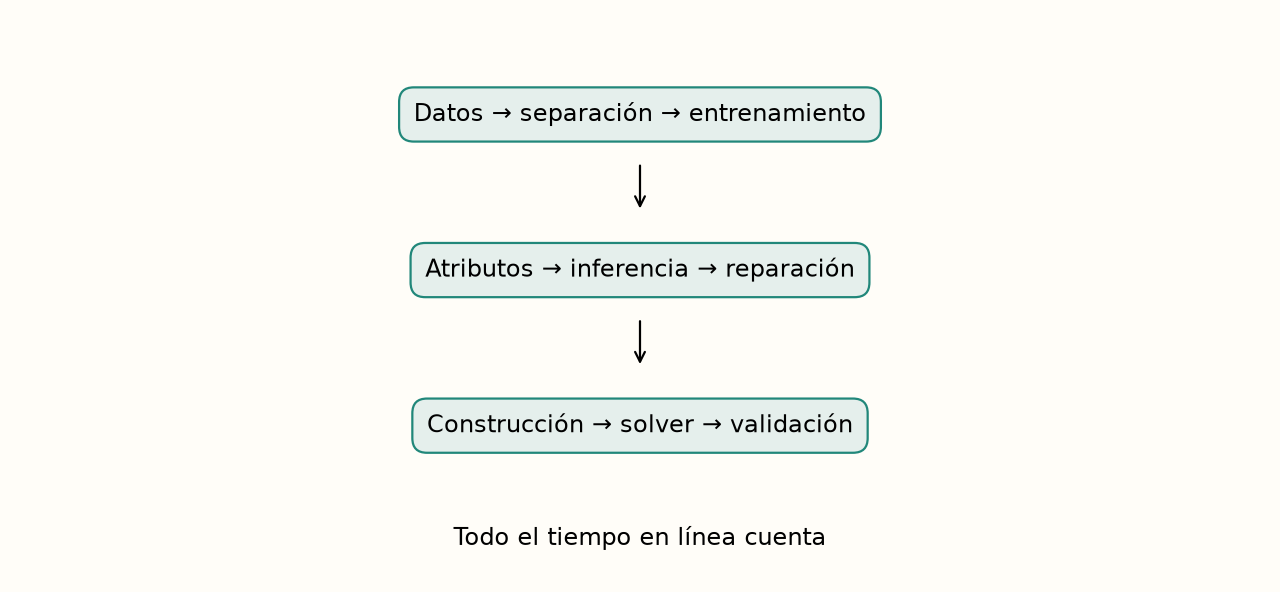
Antes de comparar velocidad, contrasté enumeración y SCIP en 13 microinstancias de tres familias, incluyendo capacidades ajustadas y costes asimétricos. Un evaluador separado recalculó costes, asignación única y capacidad. El reloj incluyó atributos, inferencia, relajación lineal, reparación, construcción del modelo, resolución y validación.
La desviación final es (U − BKS) / BKS, donde U es el coste obtenido y BKS la mejor referencia validada o el óptimo publicado. La integral primal añade la trayectoria: promedia durante el presupuesto temporal el desvío de la mejor solución disponible, limitado a [0,1], con valor 1 mientras no hay solución. Cero significa alcanzar la referencia desde el inicio; uno, permanecer sin solución o con desvío máximo. Menor es mejor, pero una integral menor no garantiza un menor coste final.
La auditoría de implementación detectó doble cómputo de construcción, falta de acumulación de la mejor solución entre etapas, ausencia de plazo global y evaluación de solo una de tres GNN. Se archivó la ejecución temporal inválida y se corrigió el protocolo con manifiestos de datos, modelos y código y checkpoints transaccionales. Los costes y la factibilidad no se invalidaron por esos errores de reloj. El análisis estadístico agrega semillas por instancia, usa comparaciones pareadas, Wilcoxon con corrección de Holm e intervalos bootstrap; los objetivos no alcanzados quedan censurados en el presupuesto.
Filtrar candidatos: una buena clasificación no basta
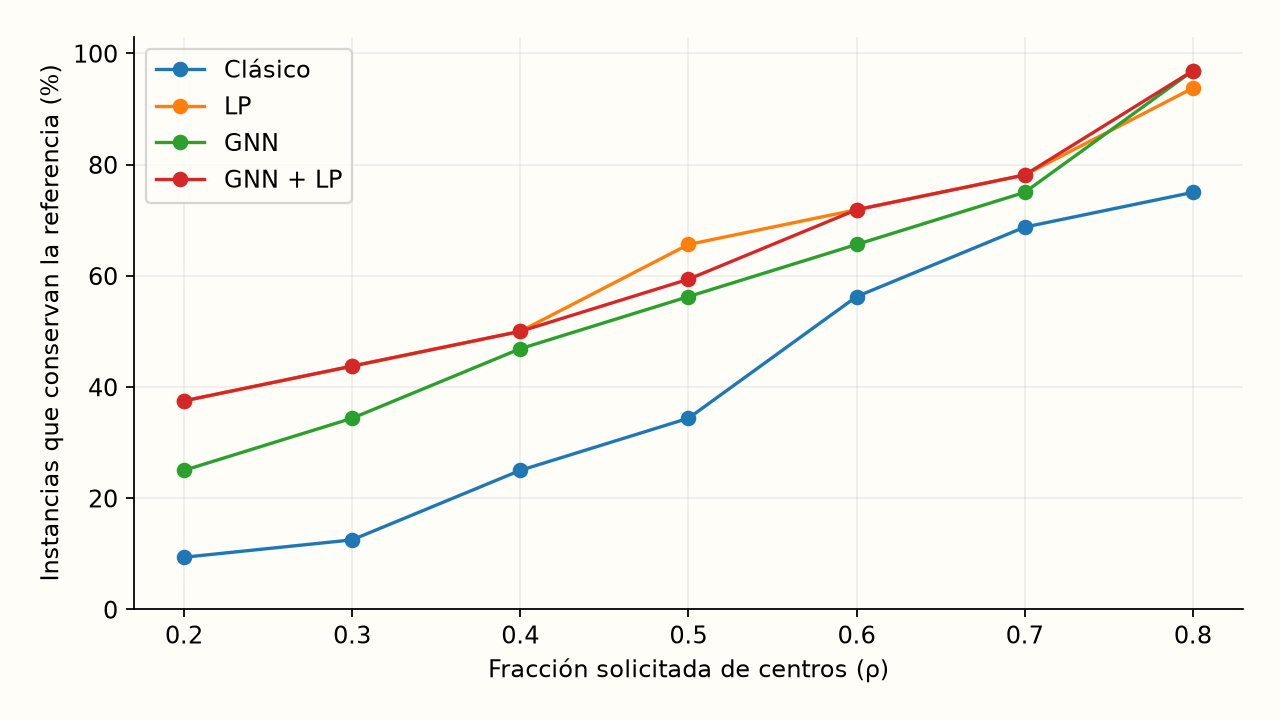
En la primera etapa, los modelos ordenaron centros para resolver un problema reducido. La GNN alcanzó AUC cercana a 0,95, pero preservar conjuntamente los centros de una buena solución es más exigente que acertar etiquetas individuales. En 32 instancias de validación, la relajación lineal sin entrenamiento superó a la GNN entre ρ = 0,2 y 0,7. Con ρ = 0,8, la GNN conservó la referencia en 31/32 casos (96,9%) y LP en 30/32 (93,8%). La diferencia fue de una instancia, reteniendo todavía el 80% de los centros.
UniFL: aprender una construcción y después mejorarla
P06 estudió una variante distinta: sin capacidad y con coste uniforme de apertura. Una MPNN de cuatro capas aprendió sin etiquetas, minimizando el coste esperado; se entrenó con n = 100 y 200. En 56 instancias, la versión estabilizada llegó a una razón de coste cercana a 1,03 con n = 1000, frente a 1,19 de Mettu–Plaxton. Aquí la referencia para n = 1000 es la mejor solución encontrada, no un óptimo probado. Con búsqueda local, ambos enfoques quedaron a aproximadamente 0,6% o menos de sus referencias: gran parte de la ventaja desapareció.
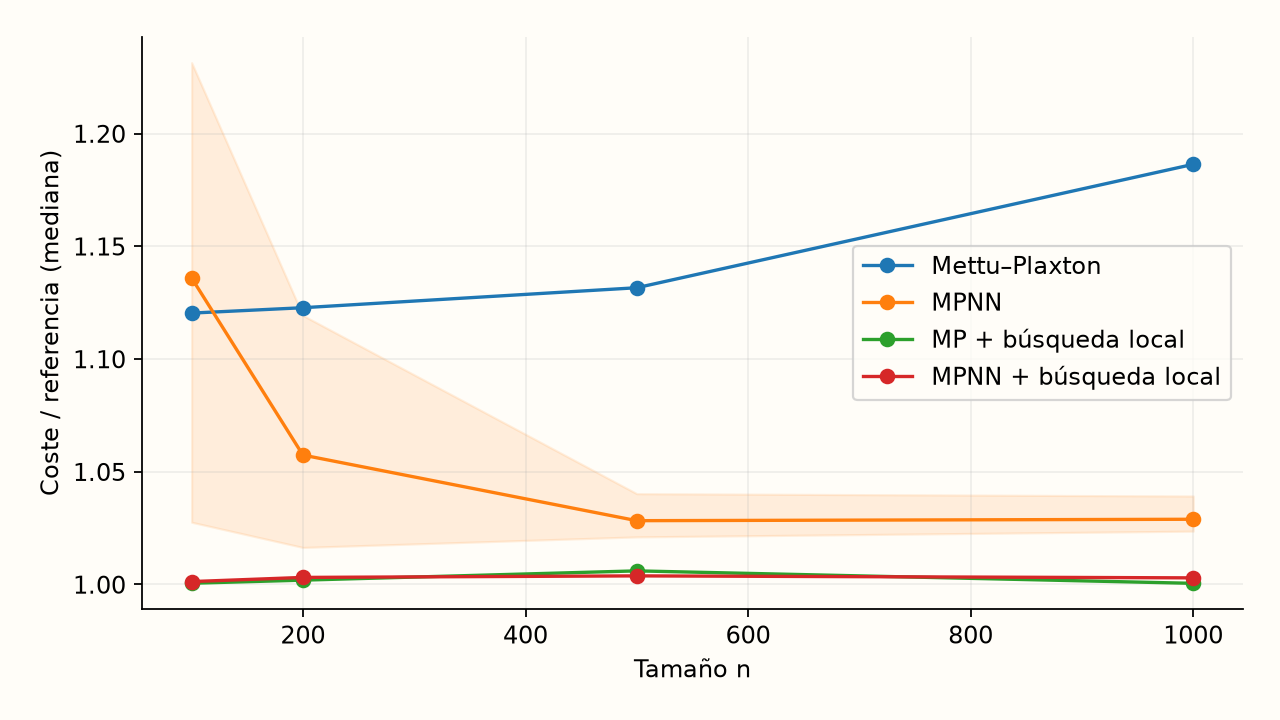
La versión prerregistrada sufrió colapso en tres de cuatro modelos: abrían un solo centro y generaban razones de coste entre 3 y 6. La corrección limitó probabilidades a 0,01–0,99, recortó gradientes a 1 y redujo la tasa de aprendizaje a 5 × 10⁻⁴. Se aplicó después de observar el test y quedó registrada como desviación del protocolo; por ello, la versión estable no constituye una confirmación independiente en datos intactos.
Filtrar intercambios: velocidad a cambio de qué
P04/P05 redujeron los intercambios evaluados por la búsqueda local. El modelo aprendido entrenado en n = 200 obtuvo desvío de 3,5%, frente a 5,1% del filtro clásico, sin fallback. En n = 500 y 1000, perdió esa ventaja. En n = 1000, el clásico alcanzó aproximadamente 47× de aceleración y 6,6% de desvío; el aprendido, 14× y 8,8%; el aleatorio, 622× y 19,9%. La aceleración compara tiempos pareados desde el mismo inicio; los desvíos usan la mejor referencia encontrada.
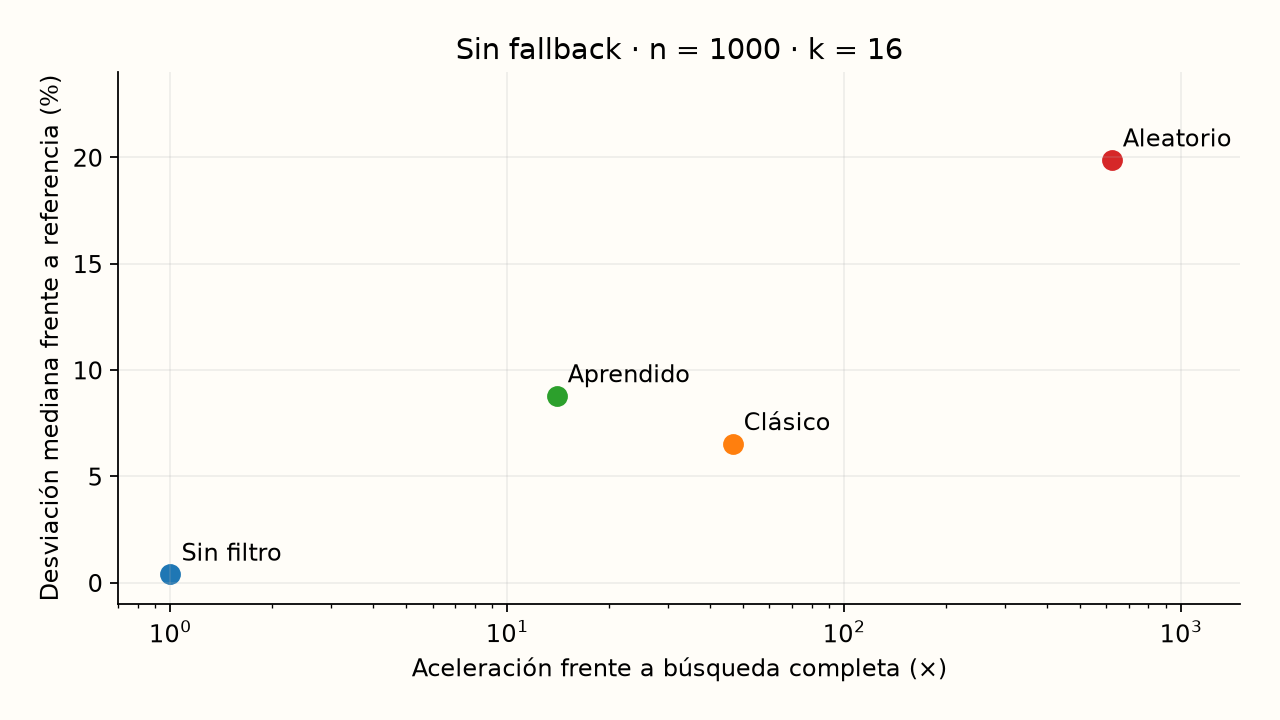
Con fallback, se vuelve a revisar la vecindad completa cuando el filtro no encuentra mejora. La calidad se aproxima a la búsqueda completa, pero la aceleración queda alrededor de 1,1–1,6×. Calcular atributos e invocar el modelo también cuesta tiempo: el filtro aprendido fue más lento que el clásico. La comparación pertinente es entre filtros con presupuestos equivalentes, no solamente contra la búsqueda sin filtrar.
Redes dentro del MIP y decisiones de ramificación
P07 incorporó un predictor Deep Sets al MIP de localización y rutas, mediante big-M. Un MAPE de 7,5% parecía favorable, pero Kendall τ = 0,34 mostró que ordenar decisiones era bastante más difícil. En 20 de 20 casos, el MIP neural no mejoró su solución inicial. En un caso con 50 clientes, el límite inferior fue 9222 y el coste 63746: el gap de 591% usa (U − L) / L; con U en el denominador sería aproximadamente 85,5%. No son convenciones intercambiables.
| Método LRP | Desvío mediano (%) | Desvío medio (%) | Mejor (%) | Tiempo MIP (s) |
|---|---|---|---|---|
| Continuo clásico | 0.03 | 0.67 | 45 | 1.5 |
| NEO SCIP | 0.05 | 0.69 | 45 | 61 |
| NEO: mejor inicio | 0.08 | 1.33 | 40 | 61 |
| NEO: búsqueda sustituta | 0.30 | 1.48 | 45 | 2 |
| FLP → VRP | 4.54 | 5.60 | 15 | 0.1 |
La evaluación usó rutas de OR-Tools en 20 instancias CLRP de 20–100 clientes. Los porcentajes de mejor resultado admiten empates. Es una comparación de calidad con presupuestos propios, no una prueba con tiempo total igual. La aproximación continua clásica, sin entrenamiento, empató o ganó frente a las alternativas neuronales.
P02/P03 aprendieron decisiones de ramificación, reconstruidas en SCIP 10 con LightGBM. Sobre 20 instancias de 100 × 100, la política aprendida fue aproximadamente 8% más rápida que relpscost, aunque exploró más de tres veces sus nodos. Empató prácticamente con pscost. Se utilizaron 953 muestras de entrenamiento, frente a unas 100 mil del estudio original; la inferencia consumió 0,4% del tiempo. La precisión top-1 fue 0,36, frente a 0,39 de la regla más fraccionaria.
| Ramificación | Resueltas en 300 s | Tiempo geom. desplazado (s) | Nodos |
|---|---|---|---|
| LightGBM | 95% | 91.7 | 167 |
| pscost | 95% | 93.2 | 165 |
| relpscost | 95% | 100.1 | 49 |
| fullstrong | 90% | 107.4 | 23 |
CLNS: reorganizar una parte sin romper el conjunto
Resolver grupos geográficos de forma independiente y unirlos falló en tres instancias de validación, con sobrecargas de 690–1070 unidades. Repararlas dejó costes 19–29% superiores a la referencia. CLNS evitó ese desacoplamiento: liberó un subproblema cada vez, mantuvo el resto fijo, descontó su ocupación de la capacidad disponible y contó el coste fijo una sola vez.
Se probaron cuatro vecindarios: interior de un grupo, frontera entre dos grupos, liberación de un centro caro y clientes con mayor arrepentimiento según información dual de LP. Cinco selectores eligieron qué vecindario resolver: rotación, aleatorio, ALNS, dual y aprendido. El selector LightGBM estimó ganancia por segundo y obtuvo AUC 0,76 en validación separada por instancia.
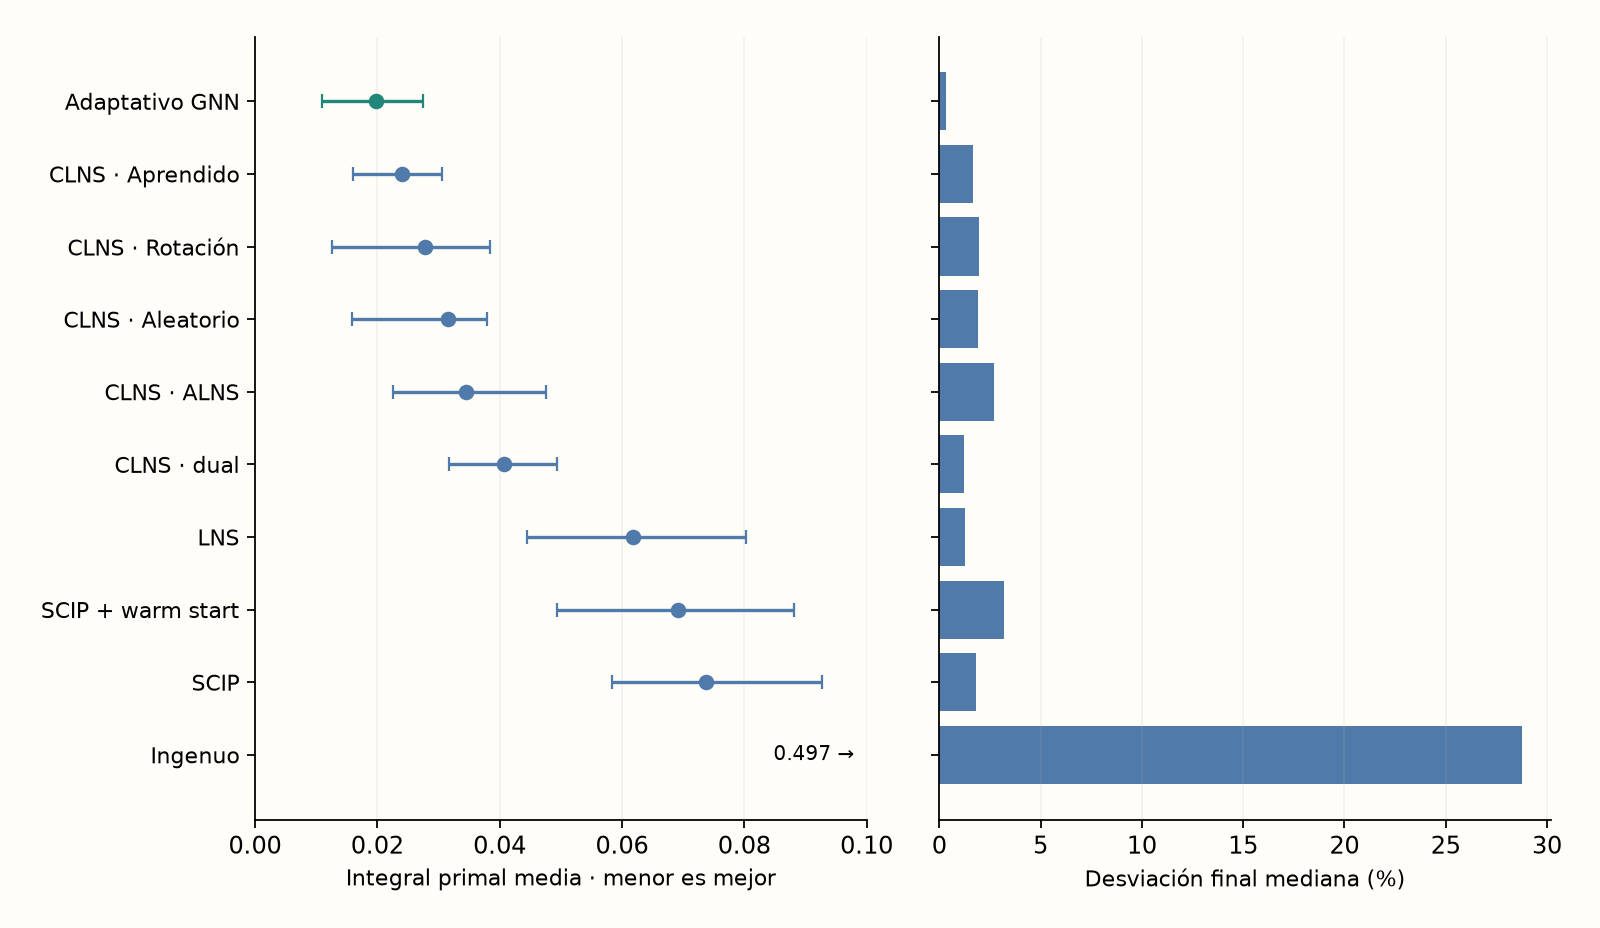
CLNS alcanzó integrales medias de 0,024–0,041, frente a 0,062–0,074 de LNS y SCIP, y desvíos finales medianos de 1,2–2,7%. El selector aprendido obtuvo la mejor integral agregada de CLNS, pero rotación ganó en alrededor del 62% de las instancias; p = 0,43 no respaldó superioridad estadística del aprendizaje. La expansión adaptativa GNN + información de LP obtuvo integral 0,0198 y desvío mediano 0,32%. Son resultados de este piloto de validación, no del test cerrado reservado.
Qué demuestran los resultados y qué no
El proyecto permitió identificar mecanismos útiles y límites concretos. La búsqueda conservó factibilidad global cuando los subproblemas respetaron capacidad residual. Los modelos aprendidos ordenaron candidatos y vecindarios, pero no superaron sistemáticamente alternativas clásicas equivalentes. LP fue un filtro fuerte; Mettu–Plaxton con búsqueda local absorbió gran parte de la ventaja neural; una aproximación continua compitió con el MIP neural. El número que interesa depende de la decisión: rapidez de una buena solución, coste final o prueba de optimalidad.
La ejecución usó CPU, con hasta tres procesos sobre cuatro núcleos físicos, y datos mayoritariamente sintéticos. Holmberg aporta una referencia externa; en otros casos, BKS sigue siendo heurística. Son reconstrucciones metodológicas en un entorno abierto, no reproducciones exactas de entornos históricos o de Gurobi. Cambios de solver, escalas y presupuestos limitan la transferencia de las conclusiones. Los gráficos de esta publicación fueron reconstruidos a partir de los CSV guardados; no representan nuevas ejecuciones de los experimentos.